Narzędzia i integracjePrzewodnik
Podłącz Qwen Code do CheapTokens: zmienne środowiskowe i settings.json
Skieruj Qwen Code na API zgodne z OpenAI za pomocą trzech zmiennych środowiskowych lub jednego wpisu w settings.json: bazowy URL, pełny identyfikator modelu i klucz trzymany poza git.
Na tej stronie
Qwen Code może łączyć się z niestandardowym endpointem zgodnym z OpenAI, więc podłączenie go do CheapTokens wymaga trzech wartości: bazowego URL https:/, Twojego klucza API i pełnego identyfikatora modelu, takiego jak deepseek-. Wyeksportuj je jako OPENAI_API_KEY, OPENAI_BASE_URL i OPENAI_MODEL albo umieść je w ~/. Obie ścieżki pochodzą z dokumentacji uwierzytelniania Qwen Code (strona ostatnio aktualizowana 22 października 2026).
Wyobraź sobie długą sesję: agent czyta kilkanaście plików, edytuje trzy, ponownie uruchamia testy. Każdy krok wysyła kontekst ponownie, więc płacisz za wejście raz za razem. Dlatego tani model rozliczany za token pasuje do agenta terminalowego i dlatego konfiguracja poniżej jest warta dziesięciu minut.
Instalacja Qwen Code#
Qwen Code wymaga Node.js 22 lub nowszego. README projektu (github.com/QwenLM/qwen-code) wymienia kilka ścieżek instalacji; dwie z nich:
Zainstaluj Qwen Code
npm
npm install -g @qwen-code/qwen-code@latestHomebrew
brew install qwen-codeUruchamiasz go poleceniem qwen. Dokumentacja opisuje też /auth → Custom Provider do ręcznego podłączania proxy lub nieobsługiwanego dostawcy. Dwie ścieżki poniżej są rozpisane linia po linii, więc zacznij od jednej z nich.
Ścieżka 1: trzy zmienne środowiskowe#
Najszybszy sposób. Otwórz terminal w swoim projekcie i uruchom:
export OPENAI_API_KEY="sk-your-api-key"
export OPENAI_BASE_URL="https://api.cheaptokens.dev/v1"
export OPENAI_MODEL="deepseek-ai/DeepSeek-V4-Flash-0731"
qwen
Klucz to placeholder; wklej swój z panelu CheapTokens. Wyeksportowanie OPENAI_API_KEY to również to, co mówi Qwen Code, by używał uwierzytelniania zgodnego z OpenAI, gdy wszystko ustawiasz przez zmienne środowiskowe. OPENAI_MODEL ma alias QWEN_MODEL.
Jeden szczegół sprawia ludziom kłopot: identyfikator modelu. Użyj pełnego identyfikatora z dokumentacji CheapTokens. Krótka nazwa widoczna obok cen, deepseek-, nie jest akceptowana przez API, a identyfikatory różnią się między dostawcami.
Która zmienna robi co? Dopasuj je:
Dopasuj pary
Dopasuj każdą zmienną do jej zadania
Dotknij element po lewej, a następnie jego parę
- OPENAI_API_KEYTwój klucz CheapTokens; jego wyeksportowanie wybiera uwierzytelnianie zgodne z OpenAI
- OPENAI_BASE_URLEndpoint, do którego Qwen Code wysyła żądania
- OPENAI_MODELIdentyfikator modelu wysyłany do API
- QWEN_MODELAlias dla OPENAI_MODEL
Eksporty działają do zamknięcia terminala. Aby zachować konfigurację, użyj następnej ścieżki.
Ścieżka 2: settings.json i klucz poza git#
Załóżmy, że dzielisz repozytorium z zespołem i nikt nie chce klucza w pliku konfiguracyjnym. Wtedy opisz model w ~/, a klucz trzymaj w osobnym pliku.
{
  "modelProviders": {
    "openai": [
      {
        "id": "deepseek-ai/DeepSeek-V4-Flash-0731",
        "name": "DeepSeek-V4-Flash (CheapTokens)",
        "baseUrl": "https://api.cheaptokens.dev/v1",
        "description": "DeepSeek-V4-Flash through CheapTokens",
        "envKey": "CHEAPTOKENS_API_KEY"
      }
    ]
  },
  "security": { "auth": { "selectedType": "openai" } },
  "model": { "name": "deepseek-ai/DeepSeek-V4-Flash-0731" }
}
Cztery pola mają znaczenie:
idto identyfikator modelu wysyłany do API, więc musi to być pełny identyfikator.model.namemusi pasować do jednej z wartościid, inaczej Qwen Code nie ma czego wybrać.security.ustawione naauth. selectedType "openai"wybiera ścieżkę zgodną z OpenAI.envKeywskazuje nazwę zmiennej przechowującej klucz. Jest opcjonalne i domyślnie przyjmujeOPENAI_API_KEY.
Sam klucz trafia do .qwen/.env, który dokumentacja zaleca dla sekretów, a ten plik pozostaje poza git:
CHEAPTOKENS_API_KEY=sk-your-api-keyJest powód, by preferować to zamiast bloku env w settings.json: wartości z env mają najniższy priorytet, a plik z kluczem łatwo przypadkowo zacommitować. Więcej o bezpiecznym przechowywaniu kluczy znajdziesz w bezpieczne przechowywanie klucza API.
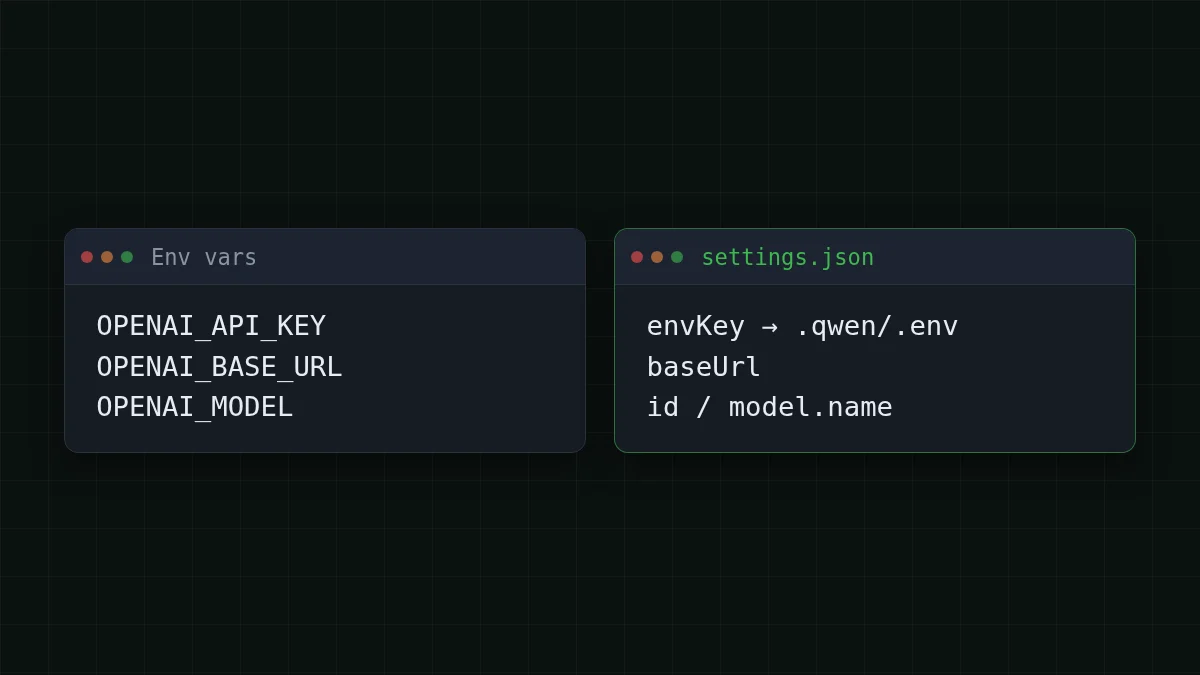
Po uruchomieniu /model pokazuje skonfigurowane modele i pozwala je przełączać. Aby zacząć od konkretnego, uruchom qwen -.
Ile kosztuje sesja kodowania#
Agenci terminalowi są obciążeni wejściem: każdy krok niesie ze sobą pliki i historię zebrane do tej pory. Weź zadanie na 40 kroków i załóż 30 000 tokenów wejściowych oraz 1 000 tokenów wyjściowych na krok. To daje 40 × 30 000 = 1 200 000 tokenów wejściowych i 40 × 1 000 = 40 000 tokenów wyjściowych. Oto całe zadanie według aktualnych cen:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 40 żądań | OpenRouter, 40 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00064 | $0.0256 | $0.0526 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.022 | $0.0633 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.066 | $0.408 |
30 000 tokenów wejściowych i 1000 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Licząc wejście i wyjście razem, CheapTokens jest tańszy niż OpenRouter dla każdego modelu w tabeli. Do tego rodzaju pętli dobrze pasuje DeepSeek-V4-Flash: kontekst 380K, do 32 768 tokenów wyjściowych w jednej odpowiedzi, jedna cena o każdej porze i jedno saldo dla każdego modelu. Twoje liczby będą inne, więc przesuń suwaki:
Kalkulator kosztów
Twój własny dzień z agentem terminalowym
Tokeny wejściowe na żądanie: 25 000 · Tokeny wyjściowe na żądanie: 800 · Żądania dziennie: 120
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0638 | $1.92 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0546 | $1.64 |
| MiniMax-M2.7$0.05$0.15 | $0.164 | $4.93 |
Ceny są na stronie cen. Jeśli śledzisz użycie w innym agencie, ile kosztuje Cline przechodzi przez tę samą arytmetykę.
Inne modele do wypróbowania#
Przełączenie to zmiana identyfikatora, nic więcej. Weź go ze strony modeli lub z GET /v1/models:
zai-: kontekst 390K, do 8 192 tokenów wyjściowych na odpowiedź i niższa cena całkowita niż w OpenRouter.org/ GLM- 5. 3- Flash MiniMaxAI/: kontekst 180K, do 8 192 tokenów wyjściowych na odpowiedź i niższa cena całkowita niż w OpenRouter.MiniMax- M2. 7
Zmień OPENAI_MODEL albo dodaj drugi wpis do modelProviders. i przełączaj się między nimi za pomocą /model.
Jeśli Qwen Code się nie łączy#
- Typ uwierzytelniania nie jest wybrany. Przy samych zmiennych środowiskowych
OPENAI_API_KEYmusi być wyeksportowane. Przy settings.json sprawdź, czyselectedTypeto"openai". - Nie znaleziono modelu.
model.namemusi być znak w znak równeid, a identyfikator musi być pełnym identyfikatorem bramy. - 401. Brakuje klucza lub jest błędny. Jeśli używasz
envKey, upewnij się, że ta zmienna naprawdę istnieje w.qwen/.envlub w Twojej powłoce. - 404. Sprawdź, czy bazowy URL kończy się na
/v1i czy identyfikator nie ma literówki. Pełny przewodnik jest w API 401 lub 404: zły klucz, bazowy URL lub identyfikator modelu. - Zmienna wydaje się ignorowana. Wartości w
envwewnątrz settings.json mają najniższy priorytet, więc wygrywa zmienna ustawiona gdzie indziej.
Konfiguracja innych agentów terminalowych działa według tego samego schematu, na przykład OpenCode i Aider. Wszystko inne, od kluczy po pierwsze żądanie, jest w dokumentacji CheapTokens.


