Модели и сравненияСравнение
Какая дешёвая модель вам нужна: выбор по входу и выходу
Измерьте соотношение входных и выходных токенов и узнайте, что выйдет дешевле для чата, сводок или разметки: GLM-5.3-Flash, DeepSeek-V4-Flash или MiniMax-M2.7.
Содержание
Выбирайте по форме задачи, а не по цене в заголовке. Если вход длинный, а ответ короткий (разметка, сводки длинных отчётов), из трёх дешевле всего выйдет DeepSeek-V4-Flash. Если ответ сопоставим со входом или длиннее (короткие реплики в чате, переписывание, генерация кода), дешевле GLM-5.3-Flash, а длинный чат посреди разговора меняет ответ. MiniMax-M2.7 берут, когда ваш собственный тест показал, что его ответы подходят лучше; из трёх у него самый большой отрыв от референсной цены OpenRouter.
Где вы находитесь, видно уже после 20 запросов. Цены ниже взяты из справки CheapTokens на 6 ноября 2026 года, а все числа в таблицах и метках живые: они следуют за текущими тарифами.
У запроса два счётчика#
Каждый запрос оплачивается дважды: за токены, которые вы отправили (вход), и за токены, которые модель написала в ответ (выход). У каждой модели своя цена на каждую сторону, и именно здесь сравнение по цене в заголовке ломается (основы — в статье чем отличаются входные и выходные токены и за что вы платите).
DeepSeek-V4-Flash берёт $0.015 за вход и $0.10 за выход на 1 млн токенов. GLM-5.3-Flash — $0.02 и $0.04. MiniMax-M2.7 — $0.05 и $0.15. Одна модель дешевле на входе, другая на выходе, так что победитель зависит от того, сколько токенов идёт в каждую сторону.
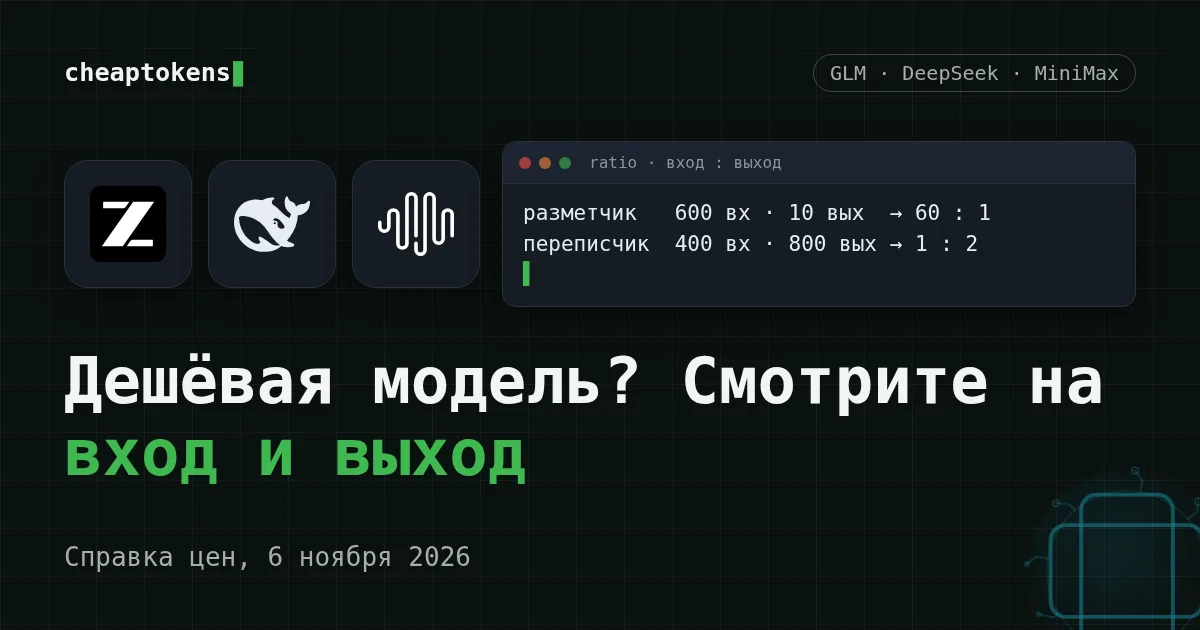
Эта пропорция и есть главное число: входные токены, делённые на выходные. Разметчик читает тикет в 600 токенов и отвечает меткой в 10 токенов — это 60 к 1 (600 ÷ 10 = 60). Инструмент переписывания берёт абзац в 400 токенов и возвращает 800 — это 1 к 2 (400 ÷ 800 = 0,5).
Угадайте число
В чате накопилось 6 000 токенов истории, модель отвечает на 300. Какое соотношение входа и выхода?
Ваш вариант
060
Показать ответ
Ответ: 20
6 000 ÷ 300 = 20. История в двадцать раз больше ответа, поэтому счётчик входа убегает далеко вперёд счётчика выхода.
Измерьте своё соотношение на 20 запросах#
На догадках всё и ломается, поэтому измеряйте. В каждом ответе Chat Completions есть объект usage с полями prompt_tokens (что вы отправили) и completion_ (что вернулось). В формате Anthropic Messages они называются input_tokens и output_tokens; оба формата показаны в документации CheapTokens.
Возьмите 20–50 настоящих запросов вашей задачи и сложите каждую сторону. Именно сложите, а не усредняйте соотношения отдельных запросов: один крошечный ответ раскачает среднее.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

prompts = ["...", "..."]  # 20-50 real inputs from your task

tokens_in = tokens_out = 0
for text in prompts:
    r = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=[{"role": "user", "content": text}],
        max_tokens=2000,
    )
    tokens_in += r.usage.prompt_tokens
    tokens_out += r.usage.completion_tokens

print(f"input {tokens_in}, output {tokens_out}, ratio {tokens_in / tokens_out:.1f} : 1")
Последняя строка выводит ваше соотношение. Это одно число вы и несёте в следующий раздел.
Что соотношение делает со счётом#
Четыре частые формы задачи. Размеры — допущения, выбранные как типичные; подставьте числа из своего замера.

Разметка 10 000 тикетов в день#
Допустим, служба поддержки размечает 10 000 тикетов в день: 600 токенов на входе, метка в 10 токенов на выходе. Весь день на каждой модели:
| Модель | Вход $/1M | Выход $/1M | За запрос | 10 000 запросов | OpenRouter, 10 000 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.124 | $0.209 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00001 | $0.10 | $0.434 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000032 | $0.315 | $3.78 |
600 входных и 10 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Посмотрите на таблицу. DeepSeek-V4-Flash здесь дешевле всех трёх, потому что почти каждый оплачиваемый токен — входной. Колонка OpenRouter показывает: все три модели ниже референсной цены в сумме, с учётом входа и выхода.
Сводки длинных отчётов#
Отчёт в 12 000 токенов, сжатый до сводки в 300, — это 40 к 1 (12 000 ÷ 300 = 40). Одна сводка стоит $0.00021 на DeepSeek-V4-Flash и $0.00025 на GLM-5.3-Flash. Та же история, что и с разметкой: чем больше читаешь на каждое написанное слово, тем сильнее помогает цена входа DeepSeek.
Переписывание и файлы с кодом#
Теперь наоборот. Переписывание в другом тоне: 400 токенов на входе, 800 в ответе. DeepSeek-V4-Flash: $0.000086. GLM-5.3-Flash: $0.00004. Выход здесь большая половина счёта, поэтому выигрывает модель с самой низкой ценой выхода — GLM-5.3-Flash.
Чат, который растёт#
Коварнее всего чат: у API нет памяти, и на каждом ходу вы заново отправляете весь массив сообщений. На первом ходу пользователь пишет 300 токенов, бот отвечает 200 (300 ÷ 200 = 1,5). Это территория GLM: $0.000014 против $0.000025 на DeepSeek-V4-Flash.
К тридцатому ходу история уже 6 000 токенов, а ответ всё те же 200 (6 000 ÷ 200 = 30). Теперь $0.00013 на GLM-5.3-Flash против $0.00011 на DeepSeek-V4-Flash — и дешёвая модель сменилась. Один и тот же бот посреди длинного разговора меняет лучшую для себя модель.
Найдите пары
Сопоставьте задачу и её форму «вход : выход»
Нажмите на элемент слева, затем на его пару
- Разметка тикета одной меткойОколо 60 : 1, вход преобладает
- Сводка отчёта в 12 000 токеновОколо 40 : 1, вход преобладает
- Переписывание абзаца в дружелюбном тонеОколо 1 : 2, выход преобладает
- Сообщение №30 в чате с полной историейОколо 30 : 1 и растёт
Когда решает длина одного ответа#
Соотношение — не единственный фильтр. Лимит ответа разный: DeepSeek-V4-Flash пишет до 32 768 выходных токенов за один ответ, GLM-5.3-Flash и MiniMax-M2.7 — до 8 192.
Допустим, вы просите целый модуль на 12 000 токенов за раз. У модели с лимитом 8 192 ответ оборвётся посреди файла с finish_ (что делать — в статье ответ модели обрывается: finish_reason length и max_tokens). На DeepSeek-V4-Flash он поместится. Так что для длинных одиночных результатов сначала смотрите на лимит, потом на соотношение.
На стороне входа у GLM-5.3-Flash контекст 390K токенов, у DeepSeek-V4-Flash — 380K: хватает, чтобы целый документ размером с книгу ушёл одним запросом. У MiniMax-M2.7 — 180K.
Где место MiniMax-M2.7#
Соотношение выбирает между двумя строками, которые выигрывают таблицы выше. MiniMax-M2.7 выбирают по другой причине: как его ответы читаются на вашей задаче. В таблице стоимости у него к тому же самый широкий отрыв от колонки OpenRouter, а 180K контекста с запасом хватает для чата и большинства документов.
О качестве не расскажет ни одна таблица цен. Прогоните те же 20 запросов из шага с замером через все три id (zai-, deepseek-, MiniMaxAI/) и прочитайте ответы рядом. Общий обзор трёх моделей — GLM, DeepSeek или MiniMax: что выбрать. Про целые агентные сессии — сколько стоит агентная сессия из 50 шагов на GLM, DeepSeek и MiniMax.
Подставьте свои числа#
Введите токены одного запроса и число запросов в день. Калькулятор считает по живым ценам и показывает все три модели. Стартовые значения — бот с ответами по базе знаний (RAG): 3 000 токенов найденного текста и вопроса на входе, 500 на выходе. Увеличивайте вход и смотрите, как меняется самая дешёвая строка.
Калькулятор стоимости
Бот с RAG-ответами, один день
Входные токены на запрос: 3 000 · Выходные токены на запрос: 500 · Запросов в день: 200
| Модель | В день | В месяц |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.016 | $0.48 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.019 | $0.57 |
| MiniMax-M2.7$0.05$0.15 | $0.045 | $1.35 |
Когда числа выглядят правильно, пройдитесь по списку.
Чек-лист
Прежде чем выбрать модель
Адрес API и id моделей — в документации CheapTokens, полный живой прайс — на странице цен, у каждой модели своя страница: GLM, DeepSeek, MiniMax. Баланс один на все три модели, поэтому после замера переход — это правка одной строки с id модели.


