ماڈلز اور موازنہموازنہ
کون سا ماڈل 100K ٹوکن کی دستاویز میں فٹ ہے: کانٹیکسٹ اور آؤٹ پٹ کی حدیں
دو مرحلوں میں جانچیں کہ لمبی دستاویز اور اس کا جواب GLM-5.3-Flash، DeepSeek-V4-Flash یا MiniMax-M2.7 میں فٹ ہیں، اور دیکھیں کہ ایک 100K ٹوکن کام کی قیمت کتنی ہے۔
اس صفحہ پر
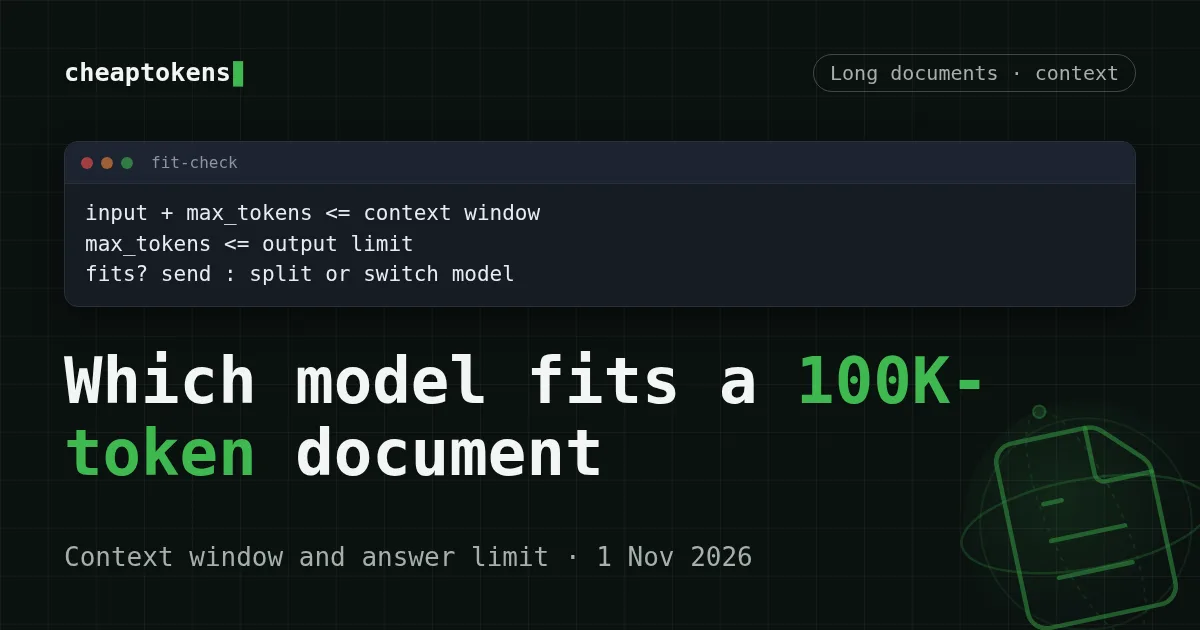
مختصر جواب: 100K ٹوکن کی دستاویز تینوں ماڈلز میں سے کسی میں بھی ایک ہی درخواست میں چلی جاتی ہے۔ فرق ان کے گرد دستیاب جگہ کا ہے۔ GLM-5.3-Flash کا کانٹیکسٹ ونڈو 390K ہے، DeepSeek-V4-Flash کا 380K ہے اور یہ 32,768 ٹوکن تک واپس لکھ سکتا ہے، MiniMax-M2.7 کا 180K ہے۔ دو جانچیں بتاتی ہیں کہ کون سا استعمال کرنا ہے: کیا دستاویز اور جواب ونڈو میں فٹ ہیں، اور کیا جواب ماڈل کی آؤٹ پٹ حد میں فٹ ہے۔
نیچے دی گئی حدیں CheapTokens کی اپنی ہیں، 1 نومبر 2026 کو جانچی گئی ہیں، اور جب آپ https:/ کال کرتے ہیں تو آپ کی درخواست انہی کے خلاف ناپی جاتی ہے۔ دستاویزات دکھاتی ہیں کہ کیسے جڑنا ہے، اور قیمتوں میں مکمل قیمت کی فہرست ہے۔
دو مرحلوں والی جانچ#
دونوں اصول ایسے نمبر استعمال کرتے ہیں جو آپ کچھ بھیجنے سے پہلے جان سکتے ہیں:
- ان پٹ ٹوکن +
max_tokens≤ کانٹیکسٹ ونڈو۔ دستاویز اور جواب ایک ہی ونڈو شیئر کرتے ہیں۔ max_tokens≤ ماڈل کی آؤٹ پٹ حد۔
ٹیبل کو دائیں طرف اسکرول کریں →
| ماڈل | API id | کانٹیکسٹ | زیادہ سے زیادہ جواب | مکمل لمبائی کے جواب کے ساتھ سب سے بڑی دستاویز |
|---|---|---|---|---|
| GLM-5.3-Flash | zai- |
390K | 8,192 | تقریباً 381K |
| DeepSeek-V4-Flash (0731) | deepseek- |
380K | 32,768 | تقریباً 347K |
| MiniMax-M2.7 | MiniMaxAI/ |
180K | 8,192 | تقریباً 172K |
آخری کالم ونڈو مائنس سب سے لمبا جواب ہے، K کو 1,000 پڑھتے ہوئے: 390,000 − 8,192 = 381,808؛ 380,000 − 32,768 = 347,232؛ 180,000 − 8,192 = 171,808۔ عملی طور پر آپ شاذ و نادر ہی سب سے لمبا ممکنہ جواب مانگتے ہیں، اس لیے آپ کے پاس اس کالم سے زیادہ جگہ ہوتی ہے۔

یہاں ایک حقیقی نظر آنے والے کیس پر جانچ ہے۔ آپ کے پاس 200,000 ٹوکن کا لاگ ہے اور آپ 2,000 ٹوکن کا تجزیہ چاہتے ہیں: 200,000 + 2,000 = 202,000۔ یہ 390K اور 380K ونڈوز میں فٹ ہے اور 180K میں فٹ نہیں۔ وہی لاگ، وہی سوال، اور تینوں میں سے ایک پہلے ہی باہر ہے۔

آپ کی دستاویز واقعی کتنی بڑی ہے؟#
صفحات ایک ناقص اکائی ہیں، ٹوکن اصل اکائی ہیں۔ فرض کریں ایک انگریزی صفحہ تقریباً 600 ٹوکن ہے (ایک مفروضہ؛ حقیقی صفحات تقریباً 500 سے 700 تک ہوتے ہیں)۔ پھر 100K ٹوکن کی دستاویز 100,000 ÷ 600 ≈ 167 صفحات ہے۔ یہ ایک موٹا معاہدہ یا لمبی سالانہ رپورٹ ہے، اور یہ جدول کے ہر ماڈل میں کافی جگہ کے ساتھ فٹ ہے۔
نمبر کا اندازہ لگائیں
100K ٹوکن کی دستاویز انگریزی متن کے کتنے صفحات ہے؟
آپ کا اندازہ
0400
جواب دکھائیں
جواب: 170
تقریباً 170۔ تقریباً 600 ٹوکن فی صفحہ پر، 100,000 ÷ 600 ≈ 167 صفحات۔ گھنا قانونی متن یا جدولیں صفحے کو بڑھا دیتی ہیں، اس لیے آپ کی اپنی گنتی مختلف ہو سکتی ہے۔
صفحات کا تخمینہ منصوبہ بندی کے لیے ہے۔ بھیجنے سے پہلے، ٹوکنائزر سے ٹوکن گنیں، یا انگریزی کے لیے تقریباً چار حروف فی ٹوکن کا موٹا اصول استعمال کریں۔ ہر ماڈل کا اپنا ٹوکنائزر ہے، اس لیے گنتی ایک تخمینہ ہے، اور درخواست کے بعد جواب کا usage فیلڈ درست نمبر دیتا ہے۔
کوڈ میں جانچ چلائیں#
یہ اسکرپٹ ایک معاہدے کو اوپر دی گئی حدوں کے خلاف جانچتا ہے، اسے بھیجتا ہے، اور پرنٹ کرتا ہے کہ جواب کیسے ختم ہوا۔ پہلے CHEAPTOKENS_ سیٹ کریں، اور دوسرے آزمانے کے لیے ماڈل id بدلیں۔
import os
from openai import OpenAI

# context window, max answer tokens (CheapTokens, checked 1 Nov 2026)
LIMITS = {
    'zai-org/GLM-5.3-Flash': (390_000, 8_192),
    'deepseek-ai/DeepSeek-V4-Flash-0731': (380_000, 32_768),
    'MiniMaxAI/MiniMax-M2.7': (180_000, 8_192),
}

def fits(model, input_tokens, max_tokens):
    context, out_limit = LIMITS[model]
    return max_tokens <= out_limit and input_tokens + max_tokens <= context

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

text = open('contract.txt', encoding='utf-8').read()
estimate = len(text) // 4   # rough: about 4 characters per token in English
model = 'zai-org/GLM-5.3-Flash'
max_tokens = 1500

if not fits(model, estimate, max_tokens):
    raise SystemExit('Does not fit: pick another model or split the text')

reply = client.chat.completions.create(
    model=model,
    max_tokens=max_tokens,
    messages=[
        {'role': 'system', 'content': 'Summarize contracts in 10 bullet points.'},
        {'role': 'user', 'content': text},
    ],
)
print(reply.choices[0].finish_reason)   # stop = ended on its own, length = cut by max_tokens
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
اگر یہ کام کرے، تو پہلی لائن stop پرنٹ کرتی ہے اور دوسری دکھاتی ہے کہ کتنے ٹوکن اندر گئے اور کتنے باہر آئے۔ اگر آپ کو length نظر آئے، تو جواب max_tokens پر پہنچ گیا؛ یہ مضمون حل بتاتا ہے۔ اور اگر درخواست سائز کی وجہ سے مسترد ہو، تو درخواست بہت لمبی: 400 بمقابلہ 413 اس پر تفصیل سے بات کرتا ہے۔
ایک 100K کام کی قیمت#
فرض کریں آپ معاہدوں کا خلاصہ کرتے ہیں۔ ہر ایک 100,000 ٹوکن ہے، اور خلاصہ تقریباً 1,500 ٹوکن ہے (مفروضے، اپنی فائلوں کے مطابق بدلیں)۔ نیچے دیا گیا جدول لائیو ہے: یہ موجودہ قیمتوں سے دوبارہ حساب لگاتا ہے اور OpenRouter حوالہ ہمارے ساتھ رکھتا ہے۔
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | لاگت | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0035 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0072 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.0627 |
کل 100,000 ان پٹ اور 1,500 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
یہاں دستاویز مہنگی طرف ہے، کیونکہ آپ واپس آنے والے سے کہیں زیادہ بھیجتے ہیں۔ ایسے ایک کام کے لیے کل رقم GLM-5.3-Flash پر $0.0021، DeepSeek-V4-Flash پر $0.0017 اور MiniMax-M2.7 پر $0.0052 ہے۔ ان پٹ اور آؤٹ پٹ کو ملا کر گننے پر، تینوں OpenRouter سے سستے نکلتے ہیں۔ قیمتیں فی ماڈل مقرر ہیں، کوئی پیک آورز نہیں، اس لیے رات کا بیچ دن کے برابر لاگت رکھتا ہے۔
اب اسے اپنے دن تک بڑھائیں۔ سلائیڈرز کو اپنے بوجھ پر لے جائیں اور کل رقم پڑھیں:
لاگت کیلکولیٹر
معاہدوں کے خلاصوں کا ایک دن
فی درخواست ان پٹ ٹوکنز: 100,000 · فی درخواست آؤٹ پٹ ٹوکنز: 1,500 · فی دن درخواستیں: 40
| ماڈل | فی دن | فی ماہ |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0824 | $2.47 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.066 | $1.98 |
| MiniMax-M2.7$0.05$0.15 | $0.209 | $6.27 |
جب جواب لمبا حصہ ہو#
خلاصے آسان کیس ہیں: مختصر جواب ہر جگہ فٹ ہوتا ہے۔ مصیبت تب شروع ہوتی ہے جب ماڈل کو بہت کچھ لکھنا ہو۔ فرض کریں آپ کے پاس 20,000 ٹوکن کا مینوئل ہے اور آپ اس کی بنیاد پر 6,000 ٹوکن کی رپورٹ مانگتے ہیں۔ یہ ہر ماڈل میں فٹ ہے (6,000 ≤ 8,192)، اور لائیو جدول لاگت دکھاتا ہے:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | لاگت | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00064 | $0.0012 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0009 | $0.0022 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0019 | $0.0228 |
کل 20,000 ان پٹ اور 6,000 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
اب اسی مینوئل کا مکمل ترجمہ مانگیں۔ ترجمہ اصل کے تقریباً برابر لمبا ہوتا ہے، اس لیے آپ کو تقریباً 20,000 ٹوکن کے جواب کی جگہ چاہیے۔ max_tokens کو 25,000 پر سیٹ کریں: 20,000 + 25,000 = 45,000، 380K ونڈو کے اندر کافی، اور 25,000 ≤ 32,768، اس لیے DeepSeek-V4-Flash اسے ایک جواب میں لے لیتا ہے۔ ایسے ایک کام کی قیمت $0.0023 ہے۔ 8,192 ٹوکن کی جواب حد والے ماڈلز کے لیے، مینوئل کو ابواب میں کاٹیں اور ایک ایک کر کے بھیجیں۔
آپ کے کیس کے لیے کون سا#
اپنا کیس منتخب کریں
اپنے کام کی شکل کے مطابق ماڈل چنیں
جواب دیکھنے کے لیے ایک آپشن منتخب کریں
لمبی دستاویز، مختصر جواب
300K ٹوکن کا آرکائیو، لمبا لاگ، رپورٹوں کا ڈھیر جس پر خلاصہ یا چند سوالات ہوں: GLM-5.3-Flash چنیں۔ اس کی سب سے چوڑی ونڈو، 390K، ہے اور 8,192 ٹوکن تک کا جواب خلاصے کے لیے کافی ہے۔
لمبا جواب
مکمل ترجمہ، مکمل رپورٹ، لمبا مسودہ: DeepSeek-V4-Flash چنیں۔ یہ ایک جواب میں 32,768 ٹوکن تک لکھتا ہے اور ماخذ کے لیے پھر بھی 380K ونڈو رکھتا ہے۔
تقریباً 170K سے کم کی دستاویز
معاہدہ، ٹرانسکرپٹ، درمیانے سائز کا کوڈ بیس اقتباس: MiniMax-M2.7 کی 180K ونڈو اور 8,192 ٹوکن تک کا جواب ہے، جو ان کے لیے کافی ہے۔ اپنے نمبروں پر اس کی لاگت کے لیے اوپر دیا گیا لائیو جدول دیکھیں۔
اگر پھر بھی یقین نہ ہو، تو ایک حقیقی دستاویز اسکرپٹ سے گزار کر usage پڑھیں۔ کام کے لحاظ سے تینوں ماڈلز کے وسیع تر موازنے کے لیے GLM بمقابلہ DeepSeek بمقابلہ MiniMax دیکھیں، اور DeepSeek صفحہ DeepSeek-V4-Flash کو مزید تفصیل سے بتاتا ہے۔


