خرابیوں کا ازالہگائیڈ
درخواست بہت لمبی: 400 بمقابلہ 413، سیاق و سباق کی ونڈو اور max_tokens
413 (بہت زیادہ بائٹس) کو ٹوکن-لمبائی کے ایرر (عام طور پر 400) سے پہچانیں، ان پٹ جمع max_tokens کو سیاق و سباق کی ونڈو کے خلاف چیک کریں، اور درخواست کو چھوٹا کریں۔
اس صفحہ پر
آپ کی چیٹ چالیس ٹرنز تک ٹھیک چلی، پھر ہر درخواست ناکام ہونے لگی۔ مختصر جواب: "request too long" دو مختلف حدود کو چھپاتا ہے۔ 413 کا مطلب ہے کہ درخواست بائٹس میں بہت بڑی ہے اور کسی ماڈل نے اسے دیکھنے سے پہلے ہی مسترد کر دیا گیا۔ اگر ایرر ٹوکنز میں لمبائی کی شکایت کرے (عام طور پر 400 کلاس کی غلط درخواست)، تو آپ کا ان پٹ جمع جواب جو آپ مانگ رہے ہیں سیاق و سباق کی ونڈو میں فٹ نہیں ہوتا؛ یہ دیکھنے کے لیے error.message پڑھیں کہ کون سا ہے۔ حل یہ ہے کہ پیمائش کریں، پھر تراشیں۔
یہ گائیڈ دکھاتی ہے کہ دونوں میں فرق کیسے کریں، بھیجنے سے پہلے حساب کیسے چیک کریں، اور درخواست کو چھوٹا کرنے کے چار طریقے۔ اگر یہ اصطلاح نئی ہے، تو سیاق و سباق کی ونڈو کیا ہے اسے آسان الفاظ میں بیان کرتا ہے۔
دو حدیں، دو ایررز#
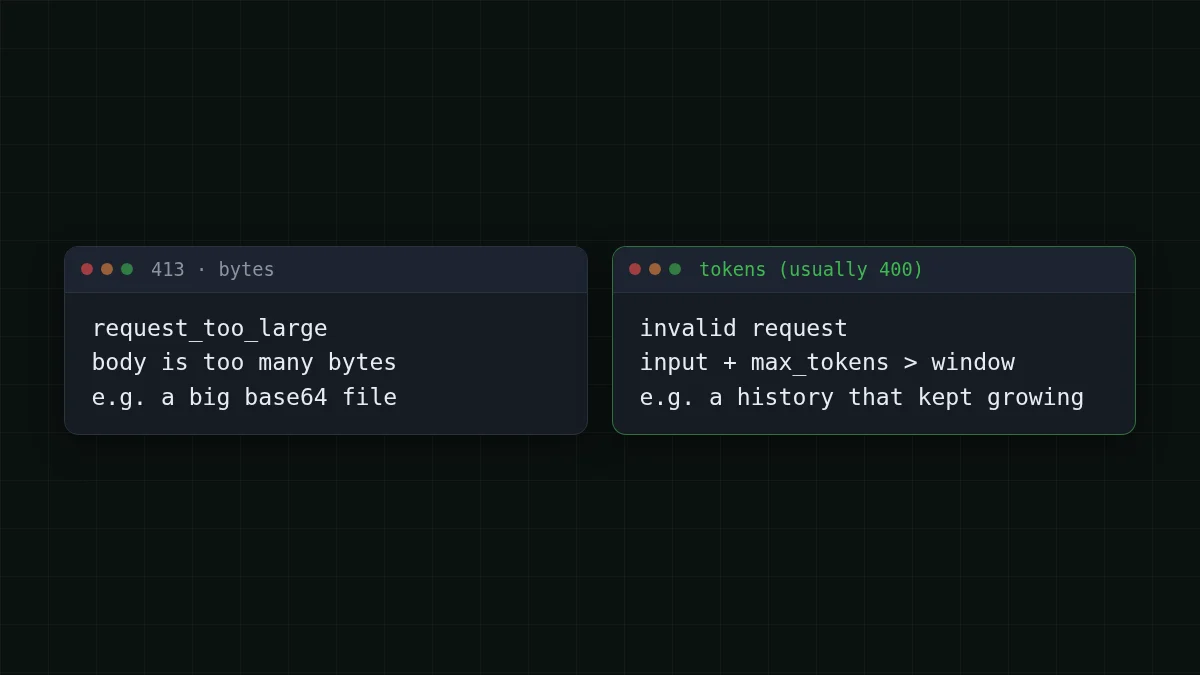
413 ڈاک خانے کا بہت بڑا پارسل مسترد کرنے کی طرح ہے؛ ٹوکن ایرر ماڈل کا یہ کہنے کی طرح ہے کہ خط اس کی پڑھنے کی ونڈو میں نہیں آئے گا۔ یہ مختلف جگہوں پر ناکام ہوتے ہیں اور مختلف حل چاہتے ہیں۔
Anthropic کا API ایررز صفحہ (29 اکتوبر 2026 کو چیک کیا گیا) 413 request_ کو ایسی درخواست کے طور پر بیان کرتا ہے جو زیادہ سے زیادہ بائٹس سے تجاوز کرے: Messages API کے لیے 128 MB، Batch API کے لیے 256 MB، Files API کے لیے 500 MB۔ 400 invalid_ درخواست کی شکل یا مواد کے مسائل کو کور کرتا ہے۔ یہ Anthropic کی حدیں ہیں۔ ان کے صفحے پر ٹوکن گنتی کا پیغام درج نہیں، اور نہ ہی OpenAI کی ایرر کوڈز گائیڈ میں، لہٰذا فورم تھریڈ میں دیکھے گئے الفاظ پر منطق مت بنائیں۔
عملی طور پر، صرف متن والی چیٹس عام طور پر بائٹس سے بہت پہلے ٹوکنز میں بڑھتی ہیں۔ بائٹس اس وقت مسئلہ بنتے ہیں جب آپ base64 تصاویر یا پوری دستاویزات منسلک کرتے ہیں۔ ٹوکنز اس وقت مسئلہ بنتے ہیں جب تاریخ بڑھتی ہے، اور یہ عام معاملہ ہے۔
جوڑے ملائیں
ہر علامت کو اس کی وجہ سے ملائیں
بائیں طرف کسی آئٹم پر ٹیپ کریں، پھر اس کا جوڑا
- 413 request_too_largeباڈی بہت زیادہ بائٹس ہے، مثلاً ایک بڑا base64 منسلکہ
- بہت بڑا لاگ پیسٹ کرنے کے فوراً بعد ٹوکن-لمبائی کا ایررصرف پرامپٹ ہی سیاق و سباق کی ونڈو سے زیادہ ٹوکنز ہے
- 380K ماڈل پر max_tokens=32768 کے ساتھ تقریباً 375K ٹوکنز کے پرامپٹ کے بعد 400مل کر ونڈو سے تجاوز کر سکتے ہیں
- وہی تاریخ، مختلف ماڈلہر ماڈل کی ونڈو چیک کریں: جو تاریخ ایک میں فٹ ہو، دوسرے میں نہیں فٹ ہو سکتی
ایرر باڈی JSON ہے جس میں ٹاپ لیول type: error، ایک error آبجیکٹ جس کا اپنا type اور message ہے، اور ایک ریکویسٹ آئی ڈی ہے۔ error.message پڑھیں اور ریکویسٹ آئی ڈی محفوظ رکھیں؛ سرکاری SDKs کے ساتھ، سٹرنگز ملانے کے بجائے ٹائپڈ ایکسپشن پکڑیں۔
بھیجنے سے پہلے حساب چیک کریں#
سب سے زیادہ وقت بچانے والی عادت: ایرر کا انتظار نہ کریں۔ ہر کال سے پہلے، تین چیزیں جمع کریں اور انہیں ونڈو سے موازنہ کریں۔
- آپ کے پیغامات میں ٹوکنز (سسٹم پرامپٹ، تاریخ، نیا سوال)۔
- وہ
max_tokensجو آپ مانگ رہے ہیں۔ - ماڈل کی سیاق و سباق کی ونڈو۔
ان پٹ جمع مطلوبہ جواب کو ونڈو کے اندر رکھیں۔ CheapTokens پر ونڈوز GLM-5.3-Flash کے لیے 390K، DeepSeek-V4-Flash کے لیے 380K اور MiniMax-M2.7 کے لیے 180K ہیں؛ جوابات GLM اور MiniMax پر 8,192 ٹوکنز تک اور DeepSeek-V4-Flash پر 32,768 تک جاتے ہیں۔ موجودہ فہرست کے لیے قیمتوں اور ماڈل صفحات دیکھیں۔
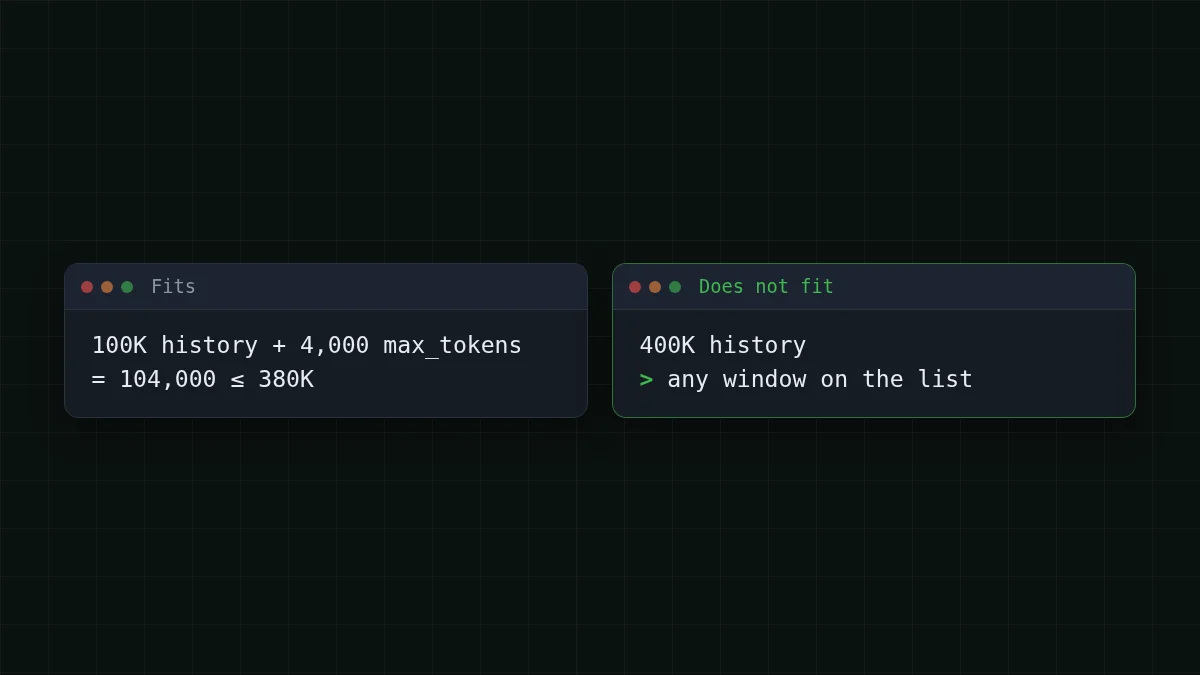
فرض کریں آپ کا ایجنٹ 100K ٹوکنز کی تاریخ بھیجتا ہے اور 4,000 ٹوکنز واپس مانگتا ہے۔ یہ 100,000 + 4,000 = 104,000 ٹوکنز ہیں، تینوں میں سے کسی پر بھی آرام دہ۔ اب وہی ایجنٹ مزید پچاس مراحل کے بعد: 400K۔ فہرست میں کوئی ونڈو اسے نہیں لیتی، چاہے آپ max_tokens کچھ بھی مقرر کریں۔ یہی وہ لمحہ ہے جب ایرر ظاہر ہوتا ہے، اور یہ اچانک صرف اس لیے لگتا ہے کہ تاریخ ہر ٹرن میں تھوڑی بڑھتی رہی۔
گارڈ کے لیے ایک موٹا کاؤنٹر کافی ہے۔ انگریزی متن اوسطاً تقریباً 4 حروف فی ٹوکن استعمال کرتا ہے؛ کوڈ اور غیر انگریزی متن فی حرف زیادہ ٹوکنز استعمال کرتے ہیں، لہٰذا حاشیہ چھوڑیں:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
آخری لائن آپ کی کیلیبریشن ہے: usage. وہ ہے جو API نے اصل میں گنا۔ اسے rough_ سے چند بار موازنہ کریں اور تقسیم کنندہ اور حاشیہ کو اپنے متن کے مطابق ایڈجسٹ کریں۔
درخواست کو چھوٹا کرنے کے چار طریقے#
سب سے سستا حل منتخب کریں جو کام کرے، اس ترتیب میں۔
1. max_tokens کم کریں۔ صرف وہی جواب مانگیں جس کی آپ کو ضرورت ہے: ان پٹ جمع max_tokens وہ ہے جو آپ کو ونڈو کے اندر رکھنا ہے، اور ہر ماڈل کی جواب پر اپنی حد ہے (اوپر 8,192 یا 32,768 ٹوکنز)۔ max_tokens کو جواب کی ضرورت سے زیادہ اور ماڈل کی جواب کی حد سے زیادہ مقرر نہ کریں۔ اگر جواب آپ کی مقرر کردہ حد پر رک جائے، تو یہ finish_ پر ختم ہوتا ہے، جس کا اپنا حل ہے۔
2. تاریخ تراشیں۔ سب سے پرانے ٹرنز چھوڑ دیں، سسٹم پرامپٹ اور آخری چند تبادلے رکھیں۔ اوپر دیا گیا trim فنکشن بالکل یہی کرتا ہے۔ ایجنٹ کے لیے، بوجھ بھی کاٹیں: 5,000 لائنوں کے ٹول آؤٹ پٹس کو ایجنٹ کے استعمال کے بعد مکمل طور پر رکھنے کی شاذ و نادر ہی ضرورت ہوتی ہے۔
3. چھوڑنے کے بجائے خلاصہ کریں۔ جب پرانے ٹرنز اہم ہوں، ماڈل سے ایک بار انہیں مختصر نوٹ میں سکیڑنے کو کہیں، پھر پرانے پیغامات کو اس نوٹ سے بدل دیں۔ آپ ایک اضافی کال کی قیمت دیتے ہیں اور تھریڈ برقرار رکھتے ہیں۔
4. بڑی ونڈو پر سوئچ کریں۔ MiniMax-M2.7 (180K) سے GLM-5.3-Flash (390K) یا DeepSeek-V4-Flash (380K) پر جانا ماڈل آئی ڈی کی ایک لائن کی تبدیلی ہے۔ اگر آپ کو طویل جوابات بھی چاہیے، تو DeepSeek-V4-Flash 32,768 آؤٹ پٹ ٹوکنز تک اجازت دیتا ہے، اور تینوں ایک ہی بیلنس شیئر کرتے ہیں، لہٰذا سوئچ کرنے میں سیٹ اپ کا کوئی خرچ نہیں۔
چیک لسٹ
ناکام درخواست دوبارہ بھیجنے سے پہلے
طویل تاریخ کی قیمت#
تراشنا صرف ایررز کے بارے میں نہیں۔ ایجنٹ کا ہر مرحلہ پوری تاریخ دوبارہ بھیجتا ہے، لہٰذا پھولی ہوئی تاریخ بل کا مہنگا حصہ بھی ہے۔ 30 مراحل کا کام لیں جہاں ہر مرحلہ تقریباً 100K ٹوکنز بھیجتا ہے اور تقریباً 1,500 واپس پاتا ہے:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 30 درخواستیں | OpenRouter، 30 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
فی درخواست 100,000 ان پٹ اور 1,500 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
ٹیبل اسی کام کی قیمت ہر ماڈل پر لائیو ریٹس کے ساتھ دکھاتا ہے۔ تاریخ کو چوتھائی تک کاٹیں تو ان پٹ کی طرف تقریباً تین چوتھائی گر جاتی ہے۔ یہ دیکھنے کے لیے کہ آپ کا اپنا ایجنٹ کہاں ٹوکنز خرچ کرتا ہے، Python میں فی درخواست استعمال ٹریک کریں؛ میکانکس کے لیے، ایجنٹس اتنے ٹوکنز کیوں استعمال کرتے ہیں 20 مراحل کی مثال سے گزرتا ہے۔
DeepSeek-V4-Flash فی الوقت $0.015 فی 1M ان پٹ ٹوکنز اور $0.10 فی 1M آؤٹ پٹ ٹوکنز کی قیمت رکھتا ہے، کسی بھی وقت ایک قیمت۔ اپنے نمبر آزمائیں:
لاگت کیلکولیٹر
100K تاریخ کے ساتھ 30 مراحل کا ایجنٹ کام
فی درخواست ان پٹ ٹوکنز: 100,000 · فی درخواست آؤٹ پٹ ٹوکنز: 1,500 · فی دن درخواستیں: 30
| ماڈل | فی دن | فی ماہ |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
اگر پھر بھی ناکام ہو#
سست لنک پر طویل درخواستوں کی ایک الگ ناکامی ہے: Anthropic بڑے max_tokens والی طویل درخواستوں کے لیے اسٹریمنگ یا Batch API کا مشورہ دیتا ہے، کیونکہ نیٹ ورکس بیکار کنکشنز گرا سکتے ہیں، اور اس کے SDKs غیر اسٹریمنگ درخواستوں کے 10 منٹ میں مکمل ہونے کی توقع کرتے ہیں۔ اگر ایرر 400 کے بجائے ٹائم آؤٹ یا گرایا گیا کنکشن ہو، تو کنکشن ایررز دیکھیں اور stream=True مقرر کریں۔
اگر پیغام 401 یا 404 ہے، تو مسئلہ کلید، بیس URL یا ماڈل آئی ڈی ہے: API 401 یا 404 ایرر۔ درست بیس URL، ماڈل آئی ڈیز اور مثالوں کے لیے، CheapTokens ڈاکس کھولیں۔


