استكشاف الأخطاءدليل
الطلب طويل جدًا: 400 مقابل 413، نافذة السياق وmax_tokens
ميّز بين 413 (بايتات كثيرة جدًا) وخطأ طول التوكينات (عادةً 400)، وتحقق من المدخلات زائد max_tokens مقابل نافذة السياق، وقلّص الطلب.
في هذه الصفحة
دارت محادثتك بسلاسة لأربعين دورًا، ثم بدأت كل الطلبات تفشل. الجواب المختصر: "request too long" يخفي حدّين مختلفين. يعني 413 أن الطلب كبير جدًا بـالبايتات ورُفض قبل أن يراه أي نموذج. أما إذا اشتكى الخطأ من الطول بالتوكينات (عادةً طلب غير صالح من فئة 400)، فإن مدخلاتك زائد الإجابة التي تطلبها لا تتسع لنافذة السياق؛ اقرأ error.message لتعرف أيّهما. الحل هو القياس ثم التقليم.
يوضح هذا الدليل كيفية التمييز بين الاثنين، وكيفية التحقق من الحساب قبل الإرسال، وأربع طرق لتقليص الطلب. إذا كان المصطلح جديدًا عليك، فإن ما هي نافذة السياق يشرحه بكلمات بسيطة.
حدّان، وخطآن#
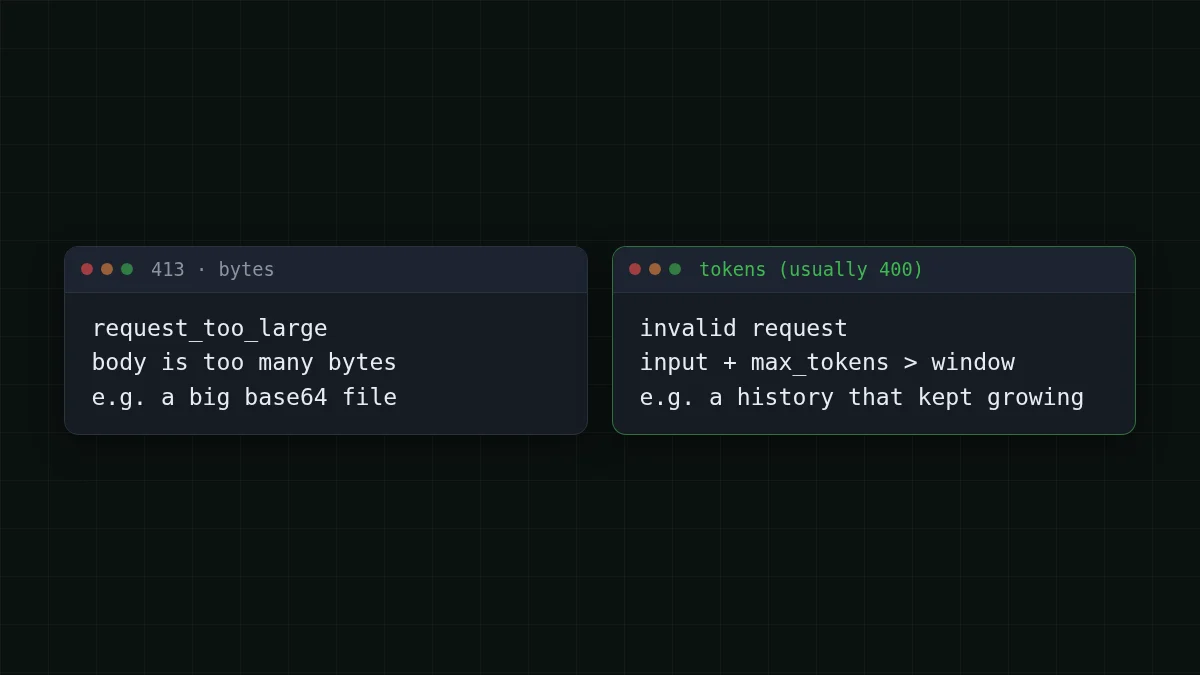
الخطأ 413 هو مكتب البريد يرفض طردًا كبيرًا جدًا؛ وخطأ التوكينات هو النموذج يقول إن الرسالة لن تتسع لنافذة قراءته. يفشلان في موضعين مختلفين ويحتاجان إلى حلّين مختلفين.
تصف صفحة أخطاء واجهة Anthropic (تم التحقق منها في 29 أكتوبر 2026) 413 request_ بأنه طلب يتجاوز الحد الأقصى لعدد البايتات: 128 ميغابايت لواجهة Messages، و256 ميغابايت لواجهة Batch، و500 ميغابايت لواجهة Files. أما 400 invalid_ فيغطي مشكلات في صيغة الطلب أو محتواه. تلك هي حدود Anthropic. ولا تسرد صفحتهم رسالة خاصة بعدد التوكينات، ولا يفعل دليل رموز الأخطاء لدى OpenAI، لذا لا تبنِ منطقًا على الصياغة الدقيقة التي رأيتها في منتدى.
عمليًا، تنمو المحادثات النصية بالتوكينات قبل البايتات بكثير. تصبح البايتات هي المشكلة عندما ترفق صورًا بترميز base64 أو مستندات كاملة. وتصبح التوكينات هي المشكلة عندما ينمو السجل، وهذه هي الحالة الشائعة.
طابق الأزواج
طابق كل عَرَض مع سببه
اضغط على عنصر من اليسار، ثم على زوجه
- 413 request_too_largeالجسم يحتوي بايتات أكثر من اللازم، مثل مرفق base64 كبير
- خطأ في طول التوكينات فور لصق سجل ضخمالمطالبة وحدها توكيناتها أكثر من نافذة السياق
- 400 بعد مطالبة بنحو 375K توكين مع max_tokens=32768 على نموذج بسعة 380Kمجموعهما قد يتجاوز النافذة
- نفس السجل، نموذج مختلفتحقق من نافذة كل نموذج: سجل يتسع لأحدهما قد لا يتسع للآخر
جسم الخطأ هو JSON يحتوي على type: error في المستوى الأعلى، وكائن error له type وmessage خاصّان به، ومعرّف طلب. اقرأ error.message واحتفظ بمعرّف الطلب؛ مع حِزم SDK الرسمية، التقط الاستثناء المُنمّط بدلًا من مطابقة النصوص.
تحقق من الحساب قبل الإرسال#
العادة التي توفّر أكبر وقت: لا تنتظر الخطأ. قبل كل استدعاء، اجمع ثلاثة أشياء وقارنها بالنافذة.
- التوكينات في رسائلك (مطالبة النظام، والسجل، والسؤال الجديد).
- قيمة
max_tokensالتي تطلبها. - نافذة سياق النموذج.
أبقِ المدخلات زائد الإجابة المطلوبة داخل النافذة. النوافذ على CheapTokens هي 390K لـ GLM-5.3-Flash، و380K لـ DeepSeek-V4-Flash، و180K لـ MiniMax-M2.7؛ وتصل الإجابات إلى 8,192 توكين على GLM وMiniMax وإلى 32,768 على DeepSeek-V4-Flash. تحقق من صفحات الأسعار والنماذج للقائمة الحالية.
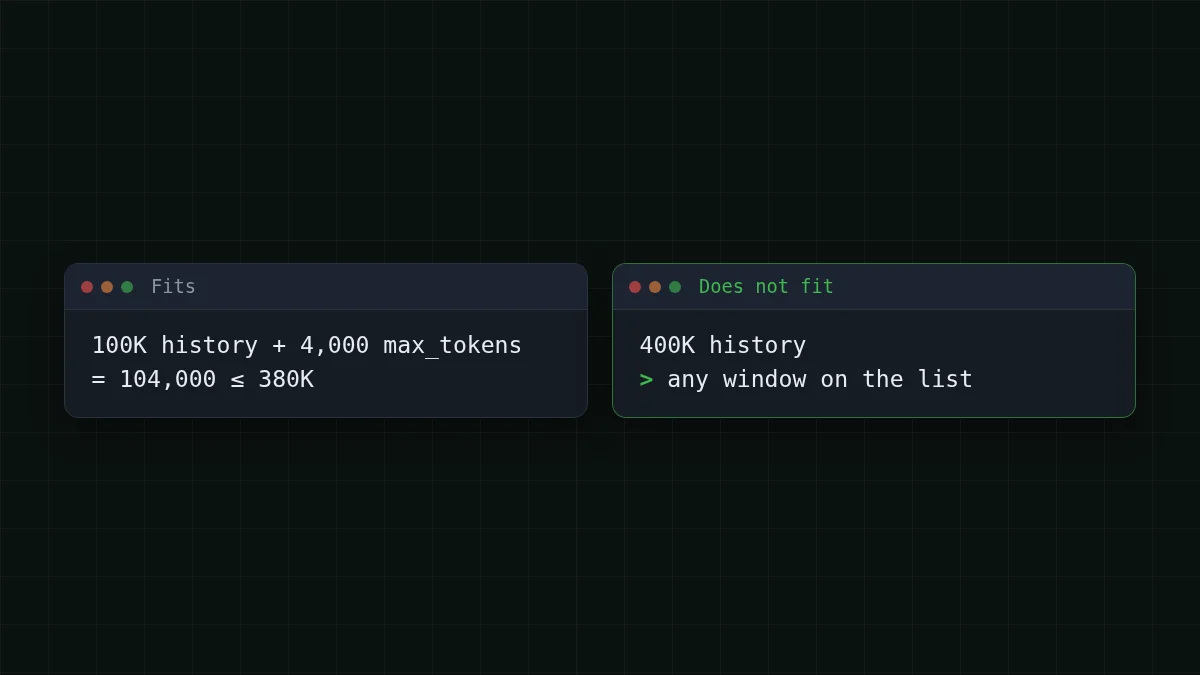
لنفترض أن وكيلك يرسل سجلًا من 100K توكين ويطلب 4,000 توكين في المقابل. هذا 100,000 + 4,000 = 104,000 توكين، مريح على أي من الثلاثة. الآن نفس الوكيل بعد خمسين خطوة أخرى: 400K. لا نافذة في القائمة تستوعبه، أيًّا كانت قيمة max_tokens التي تضبطها. تلك هي لحظة ظهور الخطأ، ويبدو مفاجئًا فقط لأن السجل نما قليلًا في كل دور.
يكفي عدّاد تقريبي كحارس. متوسط النص الإنجليزي نحو 4 أحرف لكل توكين؛ أما الشيفرة والنصوص غير الإنجليزية فتستخدم توكينات أكثر لكل حرف، لذا اترك هامشًا:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
السطر الأخير هو معايرتك: usage. هو ما عدّه الـ API فعليًا. قارنه بـrough_ بضع مرات واضبط المقسوم والهامش على نصّك الخاص.
أربع طرق لتقليص الطلب#
اختر أرخص حلّ ناجح، بهذا الترتيب.
1. خفّض max_tokens. اطلب فقط الإجابة التي تحتاجها: المدخلات زائد max_tokens هو ما يجب أن يبقى داخل النافذة، ولكل نموذج سقفه الخاص على الإجابة (8,192 أو 32,768 توكين أعلاه). لا تضبط max_tokens أعلى من حاجة الإجابة، ولا فوق سقف النموذج على الإجابات. إذا توقفت الإجابة عند الحد الذي ضبطته، فإنها تنتهي بـfinish_، ولذلك حلّه الخاص.
2. قلّم السجل. أسقط أقدم الأدوار، واحتفظ بمطالبة النظام وآخر بضع تبادلات. دالة trim أعلاه تفعل ذلك بالضبط. بالنسبة لوكيل، اقطع أيضًا الحجم الكبير: نادرًا ما تحتاج مخرجات الأدوات المكوّنة من 5,000 سطر إلى البقاء كاملة بعد أن يستخدمها الوكيل.
3. لخّص بدلًا من الإسقاط. عندما تكون الأدوار القديمة مهمة، اطلب من النموذج مرة واحدة ضغطها في ملاحظة قصيرة، ثم استبدل الرسائل القديمة بتلك الملاحظة. تدفع مقابل استدعاء إضافي واحد وتحافظ على الخيط.
4. انتقل إلى نافذة أكبر. الانتقال من MiniMax-M2.7 (180K) إلى GLM-5.3-Flash (390K) أو DeepSeek-V4-Flash (380K) هو تغيير سطر واحد في معرّف النموذج. إذا كنت تحتاج أيضًا إجابات طويلة، يسمح DeepSeek-V4-Flash بما يصل إلى 32,768 توكين إخراج، والثلاثة يتشاركون رصيدًا واحدًا، لذا لا يكلّف التبديل شيئًا في الإعداد.
قائمة التحقق
قبل إعادة إرسال طلب فاشل
ماذا يكلّف السجل الطويل#
التقليم ليس فقط لتفادي الأخطاء. كل خطوة من الوكيل تعيد إرسال السجل كاملًا، لذا فالسجل المتضخم هو أيضًا الجزء المكلف من الفاتورة. خذ مهمة من 30 خطوة حيث ترسل كل خطوة نحو 100K توكين وتحصل على نحو 1,500 في المقابل:
| النموذج | الإدخال $/1M | الإخراج $/1M | لكل طلب | 30 طلبات | OpenRouter، 30 طلبات |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
100,000 رمز إدخال و1,500 رمز إخراج لكل طلب. الأسعار لكل مليون رمز حالية وتتغير مع تعريفاتنا؛ يعرض عمود OpenRouter أسعارًا مرجعية لنفس حجم العمل.
يسعّر الجدول تلك المهمة نفسها على كل نموذج بالأسعار الحية. قلّم السجل إلى الربع فينخفض جانب المدخلات بنحو ثلاثة أرباع. لترى أين يصرف وكيلك التوكينات، تتبّع الاستخدام لكل طلب في Python؛ وللتفاصيل، لماذا تستخدم الوكلاء توكينات كثيرة يستعرض مثالًا من 20 خطوة.
يكلّف DeepSeek-V4-Flash حاليًا $0.015 لكل 1M توكين مدخلات و$0.10 لكل 1M توكين مخرجات، بسعر واحد في أي ساعة. جرّب أرقامك الخاصة:
حاسبة التكلفة
مهمة وكيل من 30 خطوة بسجل 100K
رموز الإدخال لكل طلب: 100,000 · رموز الإخراج لكل طلب: 1,500 · الطلبات يوميًا: 30
| النموذج | يوميًا | شهريًا |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
إذا استمر الفشل#
للطلبات الطويلة عبر رابط بطيء فشل منفصل: تنصح Anthropic بالبثّ أو واجهة Batch للطلبات الطويلة ذات max_tokens الكبير، لأن الشبكات قد تُسقط الاتصالات الخاملة، وتتوقع حِزم SDK الخاصة بها أن تنتهي الطلبات غير المبثوثة خلال 10 دقائق. إذا كان الخطأ مهلة أو اتصالًا منقطعًا بدلًا من 400، راجع أخطاء الاتصال واضبط stream=True.
إذا كانت الرسالة 401 أو 404، فالمشكلة في المفتاح أو عنوان URL الأساسي أو معرّف النموذج بدلًا من ذلك: خطأ API 401 أو 404. للحصول على عنوان URL الأساسي الدقيق ومعرّفات النماذج والأمثلة، افتح وثائق CheapTokens.


