Richiesta troppo lunga: 400 vs 413, finestra di contesto e max_tokens
Distingui un 413 (troppi byte) da un errore di lunghezza token (di solito un 400), verifica input più max_tokens rispetto alla finestra di contesto e riduci la richiesta.
In questa pagina
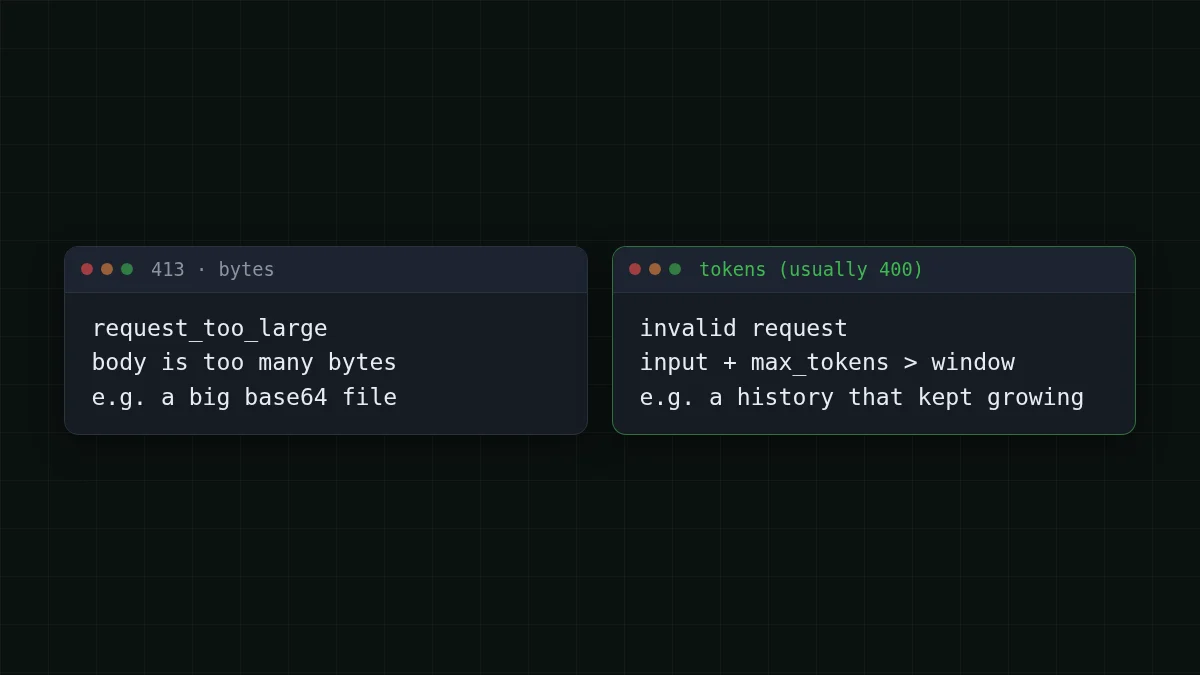
La tua chat ha funzionato per quaranta turni, poi ogni richiesta ha iniziato a fallire. La risposta breve: "request too long" nasconde due limiti diversi. Un 413 significa che la richiesta è troppo grande in byte ed è stata respinta prima che qualsiasi modello la vedesse. Se l'errore lamenta una lunghezza in token (di solito una richiesta non valida della classe 400), il tuo input più la risposta che chiedi non entrano nella finestra di contesto; leggi error.message per capire quale. La soluzione è misurare, poi tagliare.
Questa guida mostra come distinguere i due casi, come verificare i calcoli prima di inviare e quattro modi per ridurre una richiesta. Se il termine è nuovo, cos'è una finestra di contesto lo spiega in parole semplici.
Due limiti, due errori#
Un 413 è l'ufficio postale che rifiuta un pacco troppo grande; un errore sui token è il modello che dice che la lettera non entra nella sua finestra di lettura. Falliscono in punti diversi e richiedono soluzioni diverse.
La pagina degli errori API di Anthropic (consultata il 29 ottobre 2026) descrive 413 request_ come una richiesta che supera il numero massimo di byte: 128 MB per la Messages API, 256 MB per la Batch API, 500 MB per la Files API. Un 400 invalid_ copre problemi con il formato o il contenuto della richiesta. Questi sono i limiti di Anthropic. La loro pagina non elenca un messaggio di conteggio token, e nemmeno la guida ai codici di errore di OpenAI, quindi non costruire logica sulla formulazione esatta che hai visto in un thread di un forum.
In pratica, le chat di solo testo di solito crescono in token molto prima che in byte. I byte diventano il problema quando alleghi immagini base64 o interi documenti. I token diventano il problema quando cresce la cronologia, e questo è il caso comune.
Abbina le coppie
Abbina ogni sintomo alla sua causa
Tocca un elemento a sinistra, poi il suo abbinamento
- 413 request_too_largeIl corpo ha troppi byte, per esempio un grande allegato base64
- Un errore di lunghezza token subito dopo aver incollato un log enormeIl solo prompt ha più token della finestra di contesto
- 400 dopo un prompt di circa 375K token con max_tokens=32768 su un modello da 380KInsieme possono superare la finestra
- Stessa cronologia, modello diversoControlla la finestra di ogni modello: una cronologia che entra in uno può non entrare in un altro
Il corpo dell'errore è JSON con un type: error di primo livello, un oggetto error con il proprio type e message, e un id di richiesta. Leggi error.message e conserva l'id della richiesta; con gli SDK ufficiali, intercetta l'eccezione tipizzata invece di confrontare stringhe.
Verifica i calcoli prima di inviare#
L'abitudine che fa risparmiare più tempo: non aspettare l'errore. Prima di ogni chiamata, somma tre cose e confrontale con la finestra.
- I token nei tuoi messaggi (system prompt, cronologia, la nuova domanda).
- Il
max_tokensche stai chiedendo. - La finestra di contesto del modello.
Mantieni input più risposta richiesta dentro la finestra. Le finestre su CheapTokens sono 390K per GLM-5.3-Flash, 380K per DeepSeek-V4-Flash e 180K per MiniMax-M2.7; le risposte arrivano fino a 8.192 token su GLM e MiniMax e fino a 32.768 su DeepSeek-V4-Flash. Controlla prezzi e pagine dei modelli per l'elenco aggiornato.
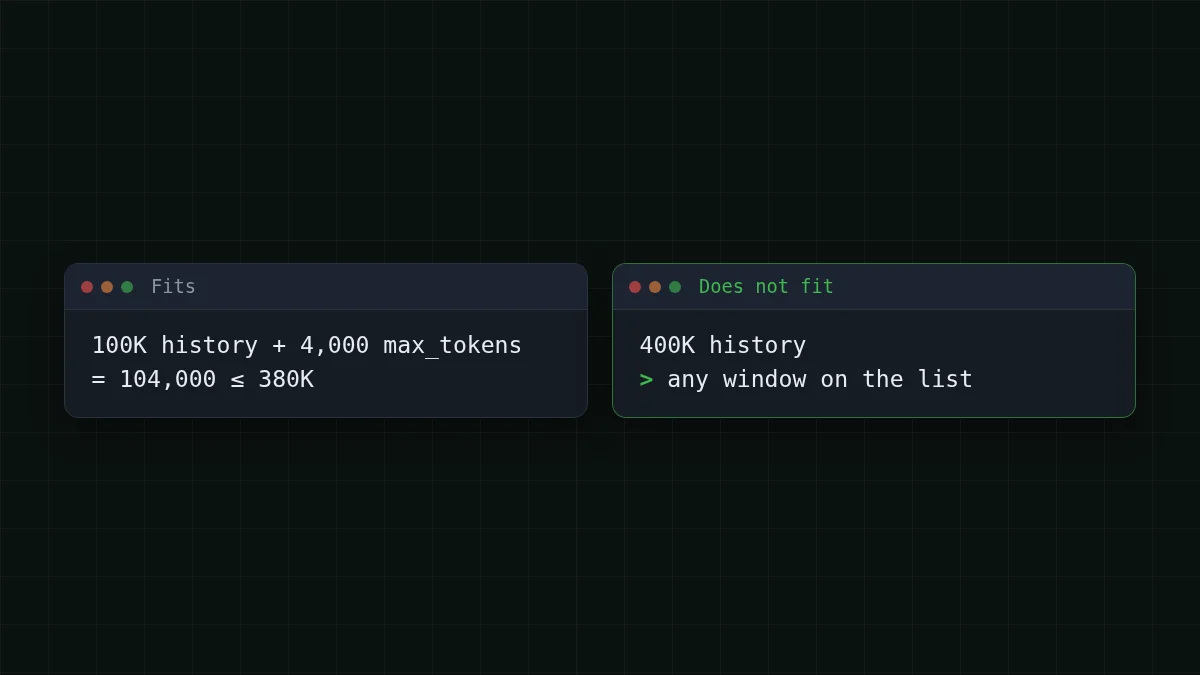
Supponi che il tuo agente invii una cronologia di 100K token e chieda 4.000 token indietro. Sono 100.000 + 4.000 = 104.000 token, comodi su ognuno dei tre. Ora lo stesso agente dopo altri cinquanta passi: 400K. Nessuna finestra dell'elenco lo accoglie, qualunque max_tokens tu imposti. Quello è il momento in cui appare l'errore, e sembra improvviso solo perché la cronologia è cresciuta un po' a ogni turno.
Un contatore approssimativo basta per una guardia. Il testo inglese ha in media circa 4 caratteri per token; il codice e il testo non inglese usano più token per carattere, quindi lascia un margine:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
L'ultima riga è la tua calibrazione: usage. è ciò che l'API ha effettivamente contato. Confrontalo con rough_ alcune volte e regola il divisore e il margine sul tuo testo.
Quattro modi per ridurre una richiesta#
Scegli la soluzione più economica che funziona, in questo ordine.
1. Abbassa max_tokens. Chiedi solo la risposta che ti serve: input più max_tokens è ciò che devi mantenere dentro la finestra, e ogni modello ha il proprio limite sulla risposta (8.192 o 32.768 token sopra). Non impostare max_tokens più alto di quanto serva alla risposta, e non oltre il limite di risposta del modello. Se la risposta si ferma al limite che hai impostato, termina con finish_, che ha la sua soluzione.
2. Taglia la cronologia. Elimina i turni più vecchi, mantieni il system prompt e gli ultimi scambi. La funzione trim qui sopra fa esattamente questo. Per un agente, taglia anche il volume: output di tool da 5.000 righe raramente devono restare per intero dopo che l'agente li ha usati.
3. Riassumi invece di eliminare. Quando i turni vecchi contano, chiedi una volta al modello di comprimerli in una nota breve, poi sostituisci i vecchi messaggi con quella nota. Paghi una chiamata in più e mantieni il filo.
4. Passa a una finestra più grande. Passare da MiniMax-M2.7 (180K) a GLM-5.3-Flash (390K) o DeepSeek-V4-Flash (380K) è un cambio di una riga dell'id del modello. Se ti servono anche risposte lunghe, DeepSeek-V4-Flash consente fino a 32.768 token di output, e tutti e tre condividono un unico saldo, quindi cambiare non costa nulla in configurazione.
Lista di controllo
Prima di reinviare una richiesta fallita
Quanto costa una cronologia lunga#
Tagliare non riguarda solo gli errori. Ogni passo di un agente reinvia l'intera cronologia, quindi una cronologia gonfia è anche la parte costosa della fattura. Prendi un task di 30 passi in cui ogni passo invia circa 100K token e ne riceve circa 1.500 indietro:
| Modello | Input $/1M | Output $/1M | Per richiesta | 30 richieste | OpenRouter, 30 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
100.000 token di input e 1500 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
La tabella prezza lo stesso task su ogni modello con le tariffe live. Riduci la cronologia a un quarto e il lato input cala di circa tre quarti. Per vedere dove il tuo agente consuma token, traccia l'uso per richiesta in Python; per i meccanismi, perché gli agenti usano così tanti token illustra un esempio di 20 passi.
DeepSeek-V4-Flash costa attualmente $0.015 per 1M token di input e $0.10 per 1M token di output, un unico prezzo a qualsiasi ora. Prova i tuoi numeri:
Calcolatore di costi
Un task di agente di 30 passi con una cronologia di 100K
Token di input per richiesta: 100.000 · Token di output per richiesta: 1500 · Richieste al giorno: 30
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
Se fallisce ancora#
Le richieste lunghe su un collegamento lento hanno un fallimento separato: Anthropic consiglia lo streaming o la Batch API per le richieste lunghe con un max_tokens grande, perché le reti possono chiudere connessioni inattive, e i suoi SDK si aspettano che le richieste non in streaming si completino entro 10 minuti. Se l'errore è un timeout o una connessione interrotta anziché un 400, vedi errori di connessione e imposta stream=True.
Se il messaggio è un 401 o un 404, il problema è invece la chiave, l'URL di base o l'id del modello: errore API 401 o 404. Per l'URL di base esatto, gli id dei modelli e gli esempi, apri la documentazione di CheapTokens.


