AI per principiantiGuida
Cos'è una finestra di contesto nell'IA? Cosa la riempie e cosa fare
La finestra di contesto è la memoria di lavoro di un modello per una richiesta: il tuo prompt, la cronologia della chat e la risposta. Scopri cosa la riempie, come stimarla e tre abitudini.
In questa pagina
La tua chat ha funzionato bene per venti messaggi, e ora le risposte diventano vaghe. Una cosa che cresce con ogni messaggio è la finestra di contesto: la memoria di lavoro del modello per una singola richiesta. Contiene tutto ciò che invii più la risposta che il modello scrive, e ha una dimensione fissa, ad esempio 380K token per DeepSeek-V4-Flash.
Cos'è la finestra di contesto#
Pensa a una scrivania. Il modello può lavorare solo con ciò che è sulla scrivania in questo momento: le tue istruzioni, la conversazione finora, un documento incollato e la risposta che sta scrivendo. Tutto ciò che non è sulla scrivania non esiste per lui. La documentazione di Anthropic sulle finestre di contesto (consultata il 27 ottobre 2026) la mette allo stesso modo: la finestra è tutto il testo che un modello può referenziare quando genera una risposta, inclusa la risposta stessa, ed è separata dai dati su cui il modello è stato addestrato.
La scrivania ha una dimensione fissa, contata in token. Un token è un pezzo di testo, all'incirca ¾ di una parola inglese; cos'è un token nell'IA approfondisce. Ecco i tre modelli su CheapTokens e le loro finestre:
- GLM-5.3-Flash: 390K token
- DeepSeek-V4-Flash: 380K token
- MiniMax-M2.7: 180K token
K significa mille. Una finestra da 380K è circa 285.000 parole inglesi: 380.000 × 0,75 = 285.000. Sono alcuni romanzi su una scrivania, e si esaurisce comunque più in fretta di quanto pensi.
Cosa conta ai fini della finestra#
Tutto nella richiesta conta, non solo il tuo ultimo messaggio:
- il prompt di sistema (le istruzioni permanenti);
- ogni messaggio precedente, tuo e del modello;
- le definizioni degli strumenti e i risultati degli strumenti, se usi un agente o un plugin per editor;
- i documenti e le immagini che alleghi;
- la risposta stessa, incluso qualsiasi ragionamento che il modello fa.
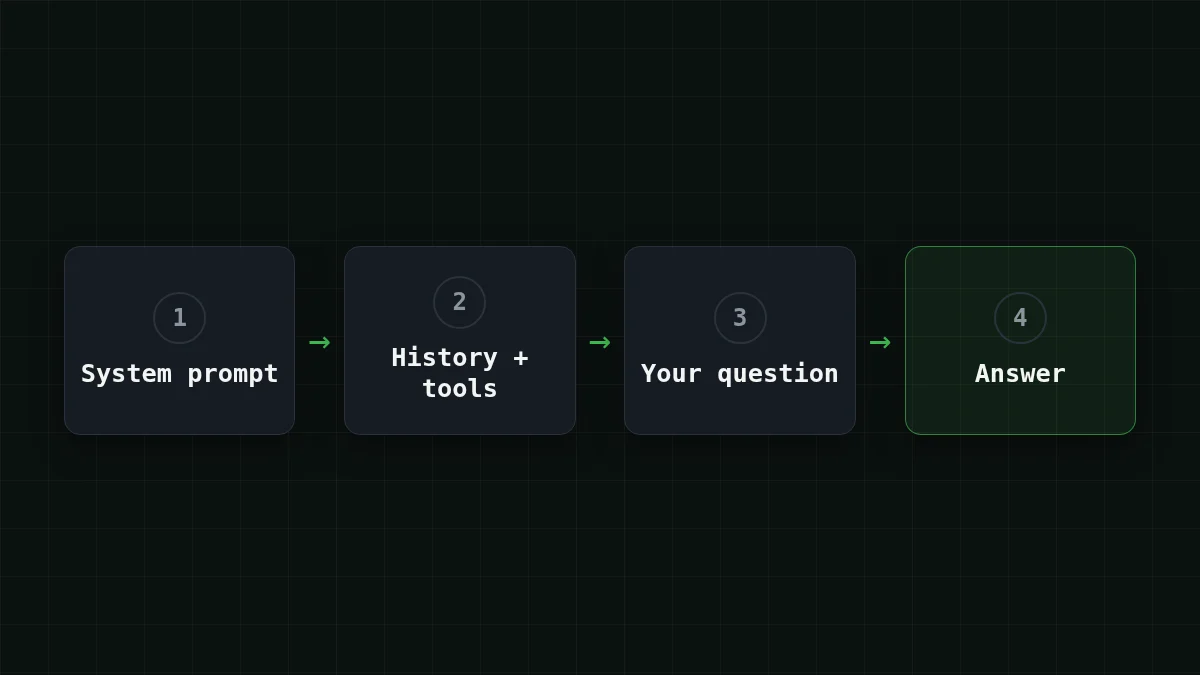
Un agente per editor è il caso subdolo. A ogni passo invia di nuovo la lista degli strumenti più tutto ciò che ha letto finora. Hai digitato una frase; la finestra vede molto di più.
Non devi indovinare la dimensione. Ogni risposta porta un campo usage con i conteggi dei token. Questo ciclo di chat minimale (API compatibile con OpenAI, id del modello dalla documentazione di CheapTokens) mostra entrambe le cose contemporaneamente: l'intera cronologia viene inviata a ogni turno, e i conteggi tornano indietro.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
Chiama ask() dieci volte e guarda il primo numero salire. Quella salita è tutta la storia di questo articolo.
Finestra vs. output massimo: due numeri diversi#
Ogni pagina di modello elenca due dimensioni, e i principianti spesso le confondono. La finestra è l'intera scrivania, input e output insieme. Il limite di output è quanto può essere lunga una risposta: fino a 32.768 token per DeepSeek-V4-Flash, fino a 8.192 per GLM-5.3-Flash e MiniMax-M2.7.
Condividono lo stesso spazio. Qualunque cosa occupi il tuo input, la risposta deve stare in ciò che rimane. Se vuoi vedere come appare una risposta troncata, perché una risposta IA si ferma a metà frase lo spiega.
Verifica rapida
DeepSeek-V4-Flash ha una finestra da 380K e un limite di output di 32.768 token. Invii 375K token di input. Quanto può essere lunga all'incirca la risposta?
Mostra risposta
Risposta: Circa 5K token, tutto ciò che rimane nella finestra
La finestra copre input e output insieme: 380K − 375K lascia circa 5K, che è sotto il tetto di 32.768.
Perché una chat lunga riempie la finestra (e il conto)#
Un modello non ricorda il tuo ultimo messaggio. Per portare avanti una conversazione, l'API riceve di nuovo l'intera cronologia a ogni turno: i turni precedenti vengono conservati completamente, e la risposta del modello diventa parte dell'input successivo. (Le app di chat a volte eliminano silenziosamente i messaggi più vecchi; l'API non lo fa per te.)
Supponiamo che tu chatti con un assistente di supporto per 30 turni. Ipotizza un prompt di sistema di 400 token, 150 token per domanda e 450 per risposta, quindi ogni scambio aggiunge 600 token alla cronologia.
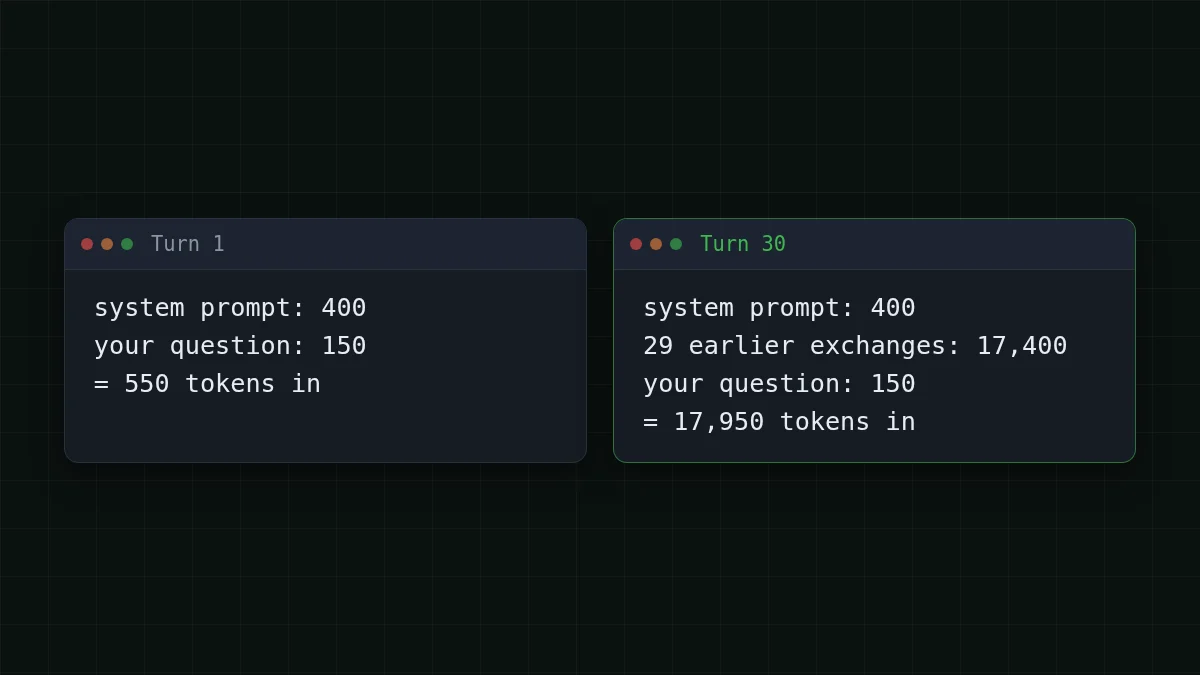
Il turno 1 invia circa 550 token. Il turno 30 invia 400 + 150 + 29 × 600 = 17.950. Sommando su tutta la chat, ogni turno porta i 550 token del proprio inizio, quindi 30 × 550 = 16.500. In più, il turno n re-invia n − 1 scambi precedenti da 600 token ciascuno: 600 × 435 = 261.000, dove 435 = 1 + 2 + … + 29. L'input dell'intera chat è 16.500 + 261.000 = 277.500 token, e le risposte aggiungono 30 × 450 = 13.500.
Su DeepSeek-V4-Flash l'intera chat costa $0.0055. Ecco tutti e tre i modelli, con il prezzo di riferimento di OpenRouter accanto; contando input e output insieme, ciascuno è più economico di OpenRouter per questa chat:
| Modello | Input $/1M | Output $/1M | Costo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
277.500 token di input e 13.500 token di output in totale. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
In media, quella chat è 277.500 ÷ 30 = 9.250 token in input per richiesta e 450 in output.
Vuoi la tua chat? Cambia i numeri qui sotto, ad esempio a 100 turni, e guarda quanto velocemente cresce il totale.
Calcolatore di costi
La stessa chat di 30 turni, in media
Token di input per richiesta: 9250 · Token di output per richiesta: 450 · Richieste al giorno: 30
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
Ora la parte onesta. 17.950 token è sotto il 5% di una finestra da 380K, quindi una chat semplice raramente tocca il muro. Ciò che cresce è il conto e il rumore. La documentazione di Anthropic osserva che accuratezza e richiamo peggiorano man mano che il conteggio dei token cresce (la chiama context rot), quindi una finestra più grande non è automaticamente migliore: ciò che ci metti conta tanto quanto quanto ci sta. Dove il muro appare davvero è con documenti e agenti. Sulla stessa API di Anthropic, una richiesta il cui input da solo è più grande della finestra riceve un errore 400, prompt is too long. Per il lato costo dello stesso effetto, vedi perché una chat IA lunga costa di più.
Il mio documento ci starà?#
Una regola approssimativa per il testo inglese: un token è circa ¾ di una parola, quindi token ≈ parole ÷ 0,75. Altre lingue di solito richiedono più token per parola, quindi lascia un margine extra. Provalo prima di continuare a leggere.
Indovina il numero
Quanti token è un libro di 90.000 parole?
La tua risposta
0300.000
Mostra risposta
Risposta: 120.000
Circa 120.000: 90.000 ÷ 0,75 = 120.000. Ci sta in una qualsiasi delle tre finestre con spazio in abbondanza.
Ora un caso più grande. Supponiamo che tu abbia un archivio di 150.000 parole di email di supporto e voglia un riassunto: 150.000 ÷ 0,75 = 200.000 token. 200.000 token è più di una finestra da 180K, quindi per questo archivio scegli GLM-5.3-Flash (390K) o DeepSeek-V4-Flash (380K). DeepSeek-V4-Flash lascia ancora 380.000 − 200.000 = 180.000 token di spazio su DeepSeek-V4-Flash, più che sufficienti per un riassunto sotto il suo limite di risposta di 32.768 token. Leggere quei 200.000 token e scrivere un riassunto di 2.000 token costa $0.0032.
Un caso più piccolo: un report di 60.000 parole è 60.000 ÷ 0,75 = 80.000 token. MiniMax-M2.7 lo gestisce con 100K di margine, il che rende la sua finestra da 180K sufficiente per chat e documenti di medie dimensioni.
Tre abitudini per una finestra quasi piena#
1. Riassumi e ricomincia. Al turno 30 la richiesta porta 17.950 token. Chiedi al modello di scrivere un riassunto di 200 token delle decisioni finora, poi inizia una nuova chat con esso. La richiesta successiva è 400 + 200 + 150 = 750 token in input, e il modello sa ancora cosa conta.
2. Invia solo la parte che ti serve. Incolla il capitolo di cui stai chiedendo, non l'intero libro; la funzione, non l'intero repository. Meno roba sulla scrivania significa un conto più piccolo e, stando alla nota di Anthropic sul context rot, un modello che ha meno cose in cui perdersi.
3. Mantieni snelle le parti fisse e osserva usage. Il prompt di sistema, le definizioni degli strumenti e i lunghi risultati degli strumenti viaggiano con ogni passo. Taglia ciò che non usi, stampa i conteggi dei token dopo ogni risposta come nel ciclo sopra, e imposta max_tokens alla lunghezza che ti serve davvero.
Quando vuoi provarlo su un modello reale, la documentazione di CheapTokens mostra la prima richiesta in poche righe, e la pagina dei prezzi elenca il prezzo live di ogni modello. Per documenti lunghi e cicli di agenti, DeepSeek-V4-Flash (contesto 380K, fino a 32.768 token di output, un prezzo fisso senza ore di punta) e GLM-5.3-Flash (390K, la finestra più grande dei tre) sono quelli da guardare per primi.


