KI für EinsteigerAnleitung
Was ist ein Kontextfenster in KI? Was es füllt und was zu tun ist
Das Kontextfenster ist das Arbeitsgedächtnis eines Modells für eine Anfrage: dein Prompt, die Chat-Historie und die Antwort. Sieh, was es füllt, wie du es schätzt, und drei Gewohnheiten.
Auf dieser Seite
Dein Chat lief zwanzig Nachrichten lang einwandfrei, und jetzt werden die Antworten vage. Eine Sache, die mit jeder Nachricht wächst, ist das Kontextfenster: das Arbeitsgedächtnis des Modells für eine Anfrage. Es enthält alles, was du sendest, plus die Antwort, die das Modell schreibt, und es hat eine feste Größe, zum Beispiel 380K Token für DeepSeek-V4-Flash.
Was das Kontextfenster ist#
Stell dir einen Schreibtisch vor. Das Modell kann nur mit dem arbeiten, was gerade auf dem Schreibtisch liegt: deine Anweisungen, die bisherige Konversation, ein eingefügtes Dokument und die Antwort, die es gerade schreibt. Alles, was nicht auf dem Schreibtisch liegt, existiert für es nicht. Anthropics Dokumentation zu Kontextfenstern (geprüft am 27. Oktober 2026) formuliert es genauso: Das Fenster ist der gesamte Text, auf den ein Modell verweisen kann, wenn es eine Antwort generiert, einschließlich der Antwort selbst, und es ist getrennt von den Daten, mit denen das Modell trainiert wurde.
Der Schreibtisch hat eine feste Größe, gezählt in Token. Ein Token ist ein Stück Text, ungefähr ¾ eines englischen Wortes; was ein Token in KI ist geht tiefer. Hier sind die drei Modelle auf CheapTokens und ihre Fenster:
- GLM-5.3-Flash: 390K Token
- DeepSeek-V4-Flash: 380K Token
- MiniMax-M2.7: 180K Token
K bedeutet Tausend. Ein 380K-Fenster entspricht etwa 285.000 englischen Wörtern: 380.000 × 0,75 = 285.000. Das sind ein paar Romane auf einem Schreibtisch, und es geht trotzdem schneller zur Neige, als du denkst.
Was dazu zählt#
Alles in der Anfrage zählt, nicht nur deine letzte Nachricht:
- der System-Prompt (die stehenden Anweisungen);
- jede frühere Nachricht, deine und die des Modells;
- Tool-Definitionen und Tool-Ergebnisse, wenn du einen Agenten oder ein Editor-Plugin verwendest;
- Dokumente und Bilder, die du anhängst;
- die Antwort selbst, einschließlich jeglichen Denkens, das das Modell ausführt.
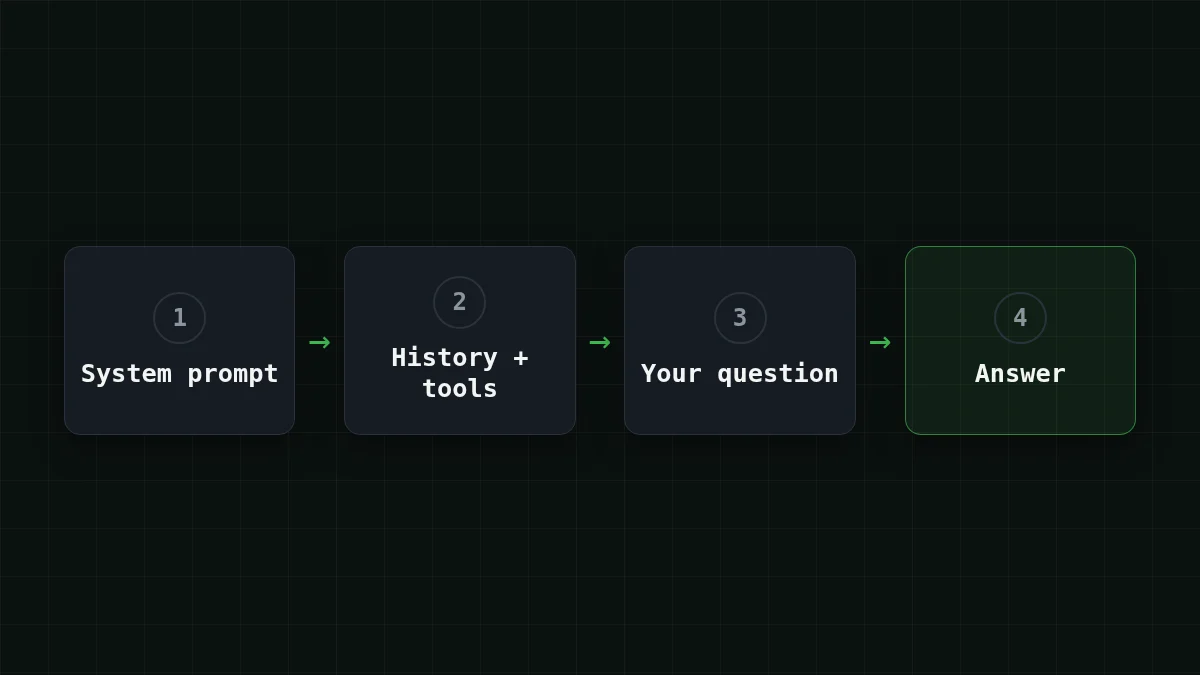
Ein Editor-Agent ist der heimtückische Fall. Bei jedem Schritt sendet er die Tool-Liste erneut plus alles, was er bisher gelesen hat. Du hast einen Satz getippt; das Fenster sieht viel mehr.
Du musst die Größe nicht raten. Jede Antwort trägt ein usage-Feld mit den Token-Zahlen. Diese minimale Chat-Schleife (OpenAI-kompatible API, Modell-ID aus den CheapTokens-Dokumenten) zeigt beides auf einmal: Die gesamte Historie geht bei jeder Runde raus, und die Zahlen kommen zurück.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
Rufe ask() zehnmal auf und beobachte, wie die erste Zahl steigt. Dieser Anstieg ist die ganze Geschichte dieses Artikels.
Fenster vs. maximale Ausgabe: zwei verschiedene Zahlen#
Jede Modellseite listet zwei Größen, und Anfänger verwechseln sie oft. Das Fenster ist der ganze Schreibtisch, Eingabe und Ausgabe zusammen. Das Ausgabelimit ist, wie lang eine Antwort sein darf: bis zu 32.768 Token für DeepSeek-V4-Flash, bis zu 8.192 für GLM-5.3-Flash und MiniMax-M2.7.
Sie teilen sich denselben Platz. Was auch immer deine Eingabe belegt, die Antwort muss in das passen, was übrig bleibt. Wenn du sehen willst, wie eine abgeschnittene Antwort aussieht, warum eine KI-Antwort mitten im Satz stoppt führt dich durch.
Kurzer Check
DeepSeek-V4-Flash hat ein 380K-Fenster und ein Ausgabelimit von 32.768 Token. Du sendest 375K Token Eingabe. Wie lang kann die Antwort ungefähr sein?
Antwort anzeigen
Antwort: Etwa 5K Token, was im Fenster übrig bleibt
Das Fenster umfasst Eingabe und Ausgabe zusammen: 380K − 375K lässt etwa 5K übrig, was unter der Obergrenze von 32.768 liegt.
Warum ein langer Chat das Fenster füllt (und die Rechnung)#
Ein Modell erinnert sich nicht an deine letzte Nachricht. Um eine Konversation am Laufen zu halten, erhält die API bei jeder Runde die gesamte Historie erneut: frühere Runden werden vollständig beibehalten, und die Antwort des Modells wird Teil der nächsten Eingabe. (Chat-Apps lassen manchmal stillschweigend die ältesten Nachrichten weg; die API tut das nicht für dich.)
Angenommen, du chattest 30 Runden lang mit einem Support-Assistenten. Nimm einen System-Prompt von 400 Token an, 150 Token pro Frage und 450 pro Antwort, sodass jeder Austausch 600 Token zur Historie hinzufügt.
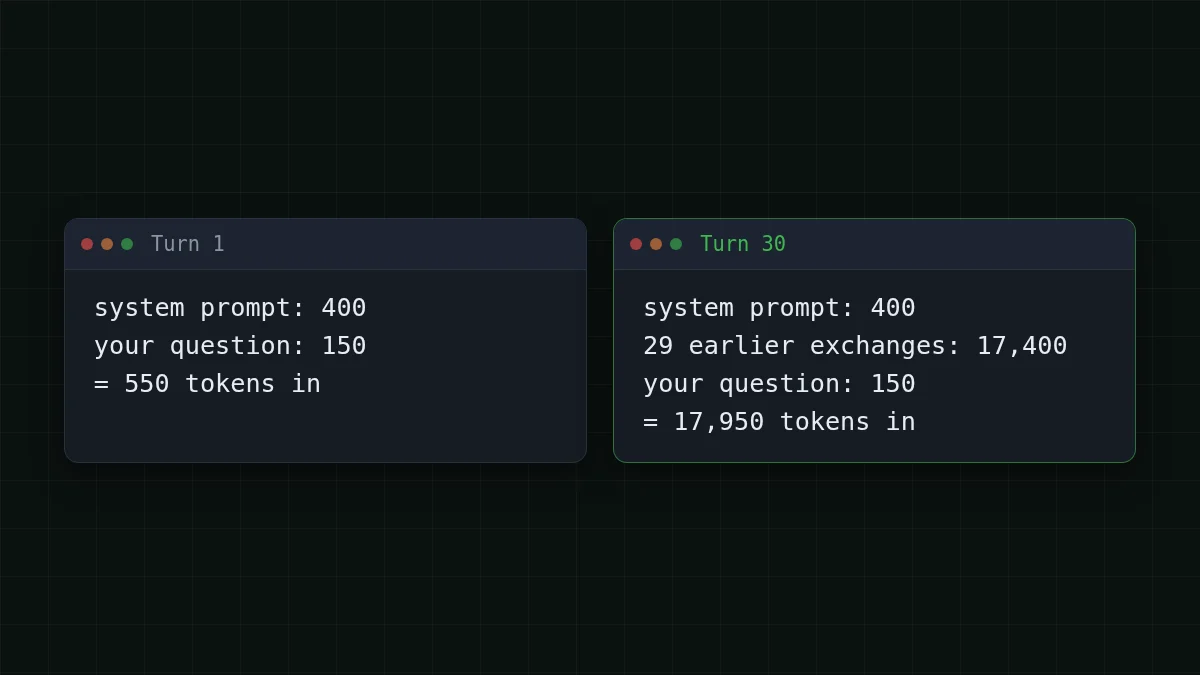
Runde 1 sendet etwa 550 Token. Runde 30 sendet 400 + 150 + 29 × 600 = 17.950. Über den gesamten Chat summiert, trägt jede Runde die 550 Token ihres eigenen Starts, also 30 × 550 = 16.500. Darüber hinaus sendet Runde n erneut n − 1 frühere Austausche von je 600 Token: 600 × 435 = 261.000, wobei 435 = 1 + 2 + … + 29. Die Eingabe des gesamten Chats beträgt 16.500 + 261.000 = 277.500 Token, und die Antworten fügen 30 × 450 = 13.500 hinzu.
Auf DeepSeek-V4-Flash kostet dieser ganze Chat $0.0055. Hier sind alle drei Modelle, mit dem OpenRouter-Referenzpreis daneben; Eingabe und Ausgabe zusammen gezählt, ist jedes für diesen Chat günstiger als OpenRouter:
| Modell | Input $/1M | Output $/1M | Kosten | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
277.500 Input- und 13.500 Output-Tokens insgesamt. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Im Durchschnitt hat dieser Chat 277.500 ÷ 30 = 9.250 Token Eingabe pro Anfrage und 450 Ausgabe.
Willst du deinen eigenen Chat? Ändere die Zahlen unten, zum Beispiel auf 100 Runden, und beobachte, wie schnell die Summe wächst.
Kostenrechner
Derselbe 30-Runden-Chat, gemittelt
Eingabe-Tokens pro Anfrage: 9.250 · Ausgabe-Tokens pro Anfrage: 450 · Anfragen pro Tag: 30
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
Jetzt der ehrliche Teil. 17.950 Token sind unter 5 % eines 380K-Fensters, also stößt ein einfacher Chat selten an die Wand. Was wächst, ist die Rechnung und das Rauschen. Anthropics Dokumentation merkt an, dass Genauigkeit und Erinnerung mit steigender Token-Zahl abnehmen (es nennt das Context Rot), also ist ein größeres Fenster nicht automatisch besser: Was du hineingibst, zählt genauso viel wie das, was hineinpasst. Wo die Wand tatsächlich auftaucht, sind Dokumente und Agenten. Bei Anthropics eigener API erhält eine Anfrage, deren Eingabe allein größer als das Fenster ist, einen 400-Fehler, Prompt zu lang. Für die Kostenseite desselben Effekts siehe warum ein langer KI-Chat mehr kostet.
Passt mein Dokument hinein?#
Eine grobe Regel für englischen Text: Ein Token ist etwa ¾ eines Wortes, also Token ≈ Wörter ÷ 0,75. Andere Sprachen brauchen normalerweise mehr Token pro Wort, also lass extra Spielraum. Probier es aus, bevor du weiterliest.
Zahl erraten
Wie viele Token ist ein Buch mit 90.000 Wörtern?
Deine Schätzung
0300.000
Antwort anzeigen
Antwort: 120.000
Etwa 120.000: 90.000 ÷ 0,75 = 120.000. Es passt in jedes der drei Fenster mit reichlich Platz.
Jetzt ein größerer Fall. Angenommen, du hast ein Archiv von Support-E-Mails mit 150.000 Wörtern und möchtest eine Zusammenfassung: 150.000 ÷ 0,75 = 200.000 Token. 200.000 Token sind mehr als ein 180K-Fenster, also wähle für dieses Archiv GLM-5.3-Flash (390K) oder DeepSeek-V4-Flash (380K). DeepSeek-V4-Flash lässt auf DeepSeek-V4-Flash noch 380.000 − 200.000 = 180.000 Token Platz, mehr als genug für eine Zusammenfassung unter seinem 32.768-Token-Antwortlimit. Diese 200.000 Token zu lesen und eine 2.000-Token-Zusammenfassung zu schreiben kostet $0.0032.
Ein kleinerer Fall: Ein Bericht mit 60.000 Wörtern ist 60.000 ÷ 0,75 = 80.000 Token. MiniMax-M2.7 bewältigt ihn mit 100K übrig, was sein 180K-Fenster für Chats und mittelgroße Dokumente ausreichend macht.
Drei Gewohnheiten für ein fast volles Fenster#
1. Zusammenfassen und neu starten. In Runde 30 trägt die Anfrage 17.950 Token. Bitte das Modell, eine 200-Token-Zusammenfassung der bisherigen Entscheidungen zu schreiben, und starte dann einen frischen Chat damit. Die nächste Anfrage hat 400 + 200 + 150 = 750 Token Eingabe, und das Modell weiß immer noch, was wichtig ist.
2. Sende nur den Teil, den du brauchst. Füge das Kapitel ein, nach dem du fragst, nicht das ganze Buch; die Funktion, nicht das ganze Repository. Weniger auf dem Schreibtisch bedeutet eine kleinere Rechnung und, nach Anthropics Context-Rot-Hinweis, ein Modell, das weniger hat, worin es sich verlieren kann.
3. Halte die festen Teile schlank und beobachte usage. Der System-Prompt, Tool-Definitionen und lange Tool-Ergebnisse laufen bei jedem Schritt mit. Kürze, was du nicht verwendest, gib die Token-Zahlen nach jeder Antwort aus wie in der Schleife oben, und setze max_tokens auf die Länge, die du tatsächlich brauchst.
Wenn du das an einem echten Modell ausprobieren möchtest, zeigen die CheapTokens-Dokumente die erste Anfrage in ein paar Zeilen, und die Preisseite listet den aktuellen Preis jedes Modells. Für lange Dokumente und Agenten-Schleifen sind DeepSeek-V4-Flash (380K Kontext, bis zu 32.768 Ausgabe-Token, ein Festpreis ohne Stoßzeiten) und GLM-5.3-Flash (390K, das größte Fenster der drei) diejenigen, die du zuerst ansehen solltest.


