¿Qué es una ventana de contexto en IA? Qué la llena y qué hacer
La ventana de contexto es la memoria de trabajo de un modelo para una solicitud: tu prompt, el historial del chat y la respuesta. Mira qué la llena, cómo estimarla y tres hábitos.
En esta página
Tu chat funcionó bien durante veinte mensajes, y ahora las respuestas se vuelven vagas. Una cosa que crece con cada mensaje es la ventana de contexto: la memoria de trabajo del modelo para una solicitud. Contiene todo lo que envías más la respuesta que el modelo escribe, y tiene un tamaño fijo, por ejemplo 380K tokens para DeepSeek-V4-Flash.
Qué es la ventana de contexto#
Piensa en un escritorio. El modelo solo puede trabajar con lo que está en el escritorio en ese momento: tus instrucciones, la conversación hasta ahora, un documento pegado y la respuesta que está escribiendo. Todo lo que no está en el escritorio no existe para él. La documentación de Anthropic sobre ventanas de contexto (consultada el 27 de octubre de 2026) lo plantea igual: la ventana es todo el texto que un modelo puede referenciar cuando genera una respuesta, incluida la respuesta misma, y es independiente de los datos con los que se entrenó el modelo.
El escritorio tiene un tamaño fijo, contado en tokens. Un token es un fragmento de texto, aproximadamente ¾ de una palabra en inglés; qué es un token en IA profundiza más. Aquí están los tres modelos en CheapTokens y sus ventanas:
- GLM-5.3-Flash: 390K tokens
- DeepSeek-V4-Flash: 380K tokens
- MiniMax-M2.7: 180K tokens
K significa mil. Una ventana de 380K es aproximadamente 285,000 palabras en inglés: 380,000 × 0.75 = 285,000. Eso son unas cuantas novelas en un escritorio, y aun así se agota más rápido de lo que pensarías.
Qué cuenta para ella#
Todo en la solicitud cuenta, no solo tu último mensaje:
- el prompt del sistema (las instrucciones permanentes);
- cada mensaje anterior, tuyo y del modelo;
- definiciones de herramientas y resultados de herramientas, si usas un agente o un plugin de editor;
- documentos e imágenes que adjuntas;
- la respuesta misma, incluido cualquier razonamiento que haga el modelo.
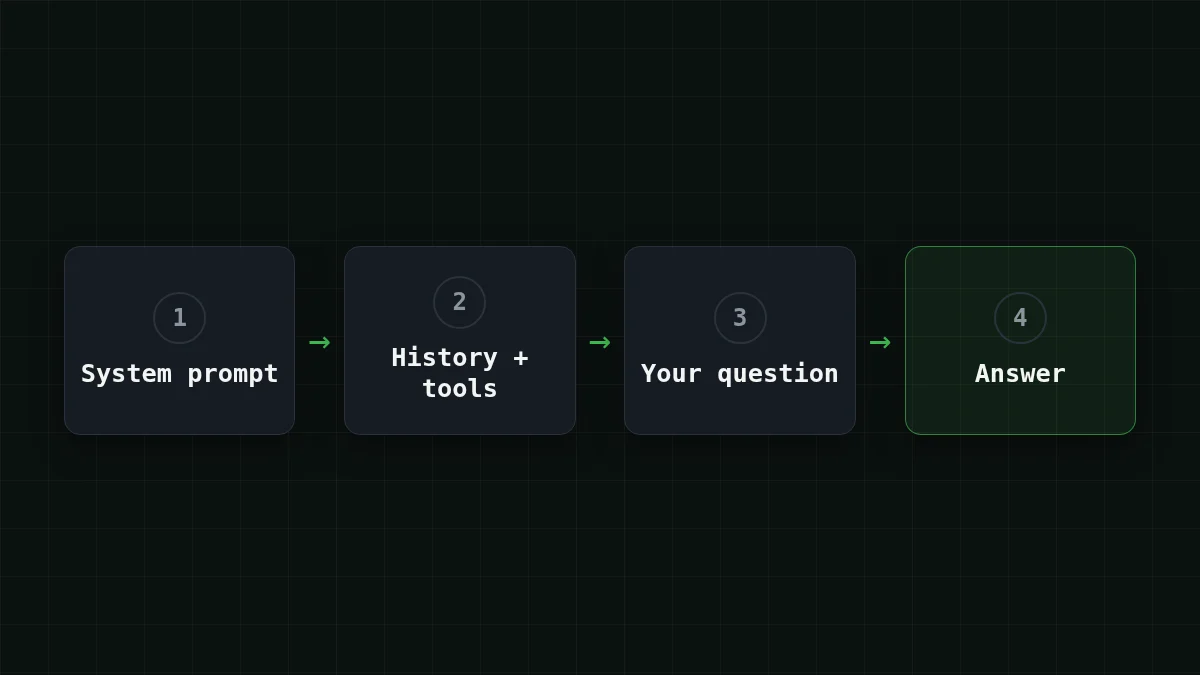
Un agente de editor es el caso engañoso. En cada paso envía de nuevo la lista de herramientas más todo lo que ha leído hasta ahora. Tú escribiste una frase; la ventana ve mucho más.
No tienes que adivinar el tamaño. Cada respuesta lleva un campo usage con los recuentos de tokens. Este bucle de chat mínimo (API compatible con OpenAI, id de modelo de los docs de CheapTokens) muestra ambas cosas a la vez: todo el historial sale en cada turno, y los recuentos vuelven.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
Llama a ask() diez veces y observa cómo sube el primer número. Esa subida es toda la historia de este artículo.
Ventana vs. salida máxima: dos números diferentes#
Cada página de modelo lista dos tamaños, y los principiantes a menudo los confunden. La ventana es todo el escritorio, entrada y salida juntas. El límite de salida es cuánto puede medir una respuesta: hasta 32,768 tokens para DeepSeek-V4-Flash, hasta 8,192 para GLM-5.3-Flash y MiniMax-M2.7.
Comparten el mismo espacio. Lo que sea que ocupe tu entrada, la respuesta tiene que caber en lo que queda. Si quieres ver cómo se ve una respuesta cortada, por qué una respuesta de IA se detiene a mitad de frase lo recorre.
Verificación rápida
DeepSeek-V4-Flash tiene una ventana de 380K y un límite de salida de 32,768 tokens. Envías 375K tokens de entrada. ¿Aproximadamente cuánto puede medir la respuesta?
Mostrar respuesta
Respuesta: Unos 5K tokens, lo que quede en la ventana
La ventana cubre entrada y salida juntas: 380K − 375K deja unos 5K, que está por debajo del tope de 32,768.
Por qué un chat largo llena la ventana (y la factura)#
Un modelo no recuerda tu último mensaje. Para mantener una conversación, la API recibe todo el historial de nuevo en cada turno: los turnos anteriores se conservan completos, y la respuesta del modelo pasa a formar parte de la siguiente entrada. (Las apps de chat a veces descartan los mensajes más antiguos en silencio; la API no hace eso por ti.)
Digamos que chateas con un asistente de soporte durante 30 turnos. Supón un prompt del sistema de 400 tokens, 150 tokens por pregunta y 450 por respuesta, así que cada intercambio añade 600 tokens al historial.
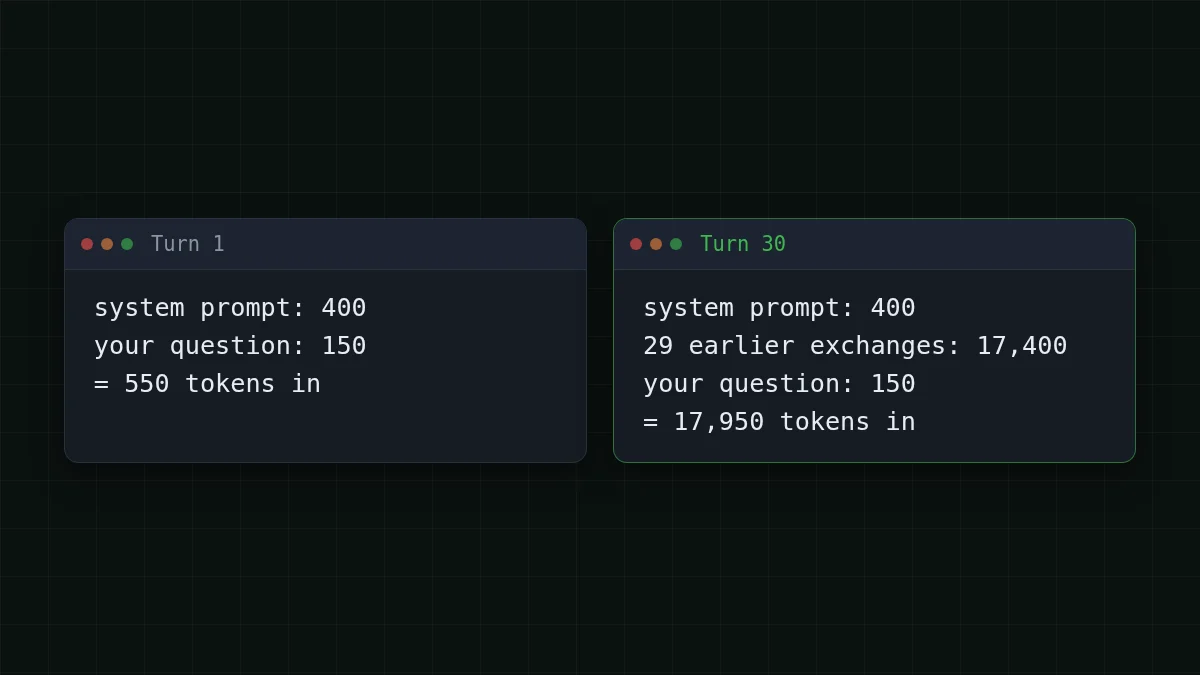
El turno 1 envía unos 550 tokens. El turno 30 envía 400 + 150 + 29 × 600 = 17,950. Sumado a lo largo de todo el chat, cada turno lleva los 550 tokens de su propio inicio, así que 30 × 550 = 16,500. Encima de eso, el turno n reenvía n − 1 intercambios anteriores de 600 tokens cada uno: 600 × 435 = 261,000, donde 435 = 1 + 2 + … + 29. La entrada de todo el chat es 16,500 + 261,000 = 277,500 tokens, y las respuestas añaden 30 × 450 = 13,500.
En DeepSeek-V4-Flash ese chat completo cuesta $0.0055. Aquí están los tres modelos, con el precio de referencia de OpenRouter al lado; contando entrada y salida juntas, cada uno es más barato que OpenRouter para este chat:
| Modelo | Entrada $/1M | Salida $/1M | Costo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
277.500 tokens de entrada y 13.500 tokens de salida en total. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
En promedio, ese chat es 277,500 ÷ 30 = 9,250 tokens de entrada por solicitud y 450 de salida.
¿Quieres tu propio chat? Cambia los números de abajo, por ejemplo a 100 turnos, y observa qué rápido crece el total.
Calculadora de costos
El mismo chat de 30 turnos, en promedio
Tokens de entrada por solicitud: 9250 · Tokens de salida por solicitud: 450 · Solicitudes por día: 30
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
Ahora la parte honesta. 17,950 tokens está por debajo del 5% de una ventana de 380K, así que un chat simple rara vez choca con el muro. Lo que crece es la factura y el ruido. La documentación de Anthropic señala que la precisión y el recuerdo se degradan a medida que crece el recuento de tokens (lo llama putrefacción de contexto), así que una ventana más grande no es automáticamente mejor: lo que pones importa tanto como cuánto cabe. Donde sí aparece el muro es en documentos y agentes. En la propia API de Anthropic, una solicitud cuya entrada sola es mayor que la ventana recibe un error 400, prompt is too long. Para el lado del costo del mismo efecto, consulta por qué un chat de IA largo cuesta más.
¿Cabe mi documento?#
Una regla aproximada para texto en inglés: un token es aproximadamente ¾ de una palabra, así que tokens ≈ palabras ÷ 0.75. Otros idiomas suelen necesitar más tokens por palabra, así que deja margen extra. Pruébalo antes de seguir leyendo.
Adivina el número
¿Cuántos tokens es un libro de 90,000 palabras?
Tu respuesta
0300.000
Mostrar respuesta
Respuesta: 120.000
Unos 120,000: 90,000 ÷ 0.75 = 120,000. Cabe en cualquiera de las tres ventanas con espacio de sobra.
Ahora un caso más grande. Digamos que tienes un archivo de 150,000 palabras de correos de soporte y quieres un resumen: 150,000 ÷ 0.75 = 200,000 tokens. 200,000 tokens es más que una ventana de 180K, así que para este archivo elige GLM-5.3-Flash (390K) o DeepSeek-V4-Flash (380K). DeepSeek-V4-Flash todavía deja 380,000 − 200,000 = 180,000 tokens de espacio en DeepSeek-V4-Flash, más que suficiente para un resumen bajo su límite de respuesta de 32,768 tokens. Leer esos 200,000 tokens y escribir un resumen de 2,000 tokens cuesta $0.0032.
Un caso más pequeño: un informe de 60,000 palabras es 60,000 ÷ 0.75 = 80,000 tokens. MiniMax-M2.7 lo maneja con 100K de sobra, lo que hace que su ventana de 180K sea suficiente para chats y documentos de tamaño medio.
Tres hábitos para una ventana casi llena#
1. Resume y reinicia. En el turno 30 la solicitud lleva 17,950 tokens. Pídele al modelo que escriba un resumen de 200 tokens de las decisiones hasta ahora, luego inicia un chat nuevo con él. La siguiente solicitud es 400 + 200 + 150 = 750 tokens de entrada, y el modelo todavía sabe lo que importa.
2. Envía solo la parte que necesitas. Pega el capítulo por el que preguntas, no el libro entero; la función, no el repositorio completo. Menos en el escritorio significa una factura más pequeña y, según la nota de putrefacción de contexto de Anthropic, un modelo en el que hay menos cosas que perder.
3. Mantén las partes fijas ligeras y vigila usage. El prompt del sistema, las definiciones de herramientas y los resultados largos de herramientas viajan en cada paso. Recorta lo que no uses, imprime los recuentos de tokens después de cada respuesta como en el bucle de arriba, y establece max_tokens a la longitud que realmente necesitas.
Cuando quieras probar esto en un modelo real, los docs de CheapTokens muestran la primera solicitud en unas pocas líneas, y la página de precios lista el precio en vivo de cada modelo. Para documentos largos y bucles de agentes, DeepSeek-V4-Flash (contexto de 380K, hasta 32,768 tokens de salida, un precio fijo sin horas pico) y GLM-5.3-Flash (390K, la ventana más grande de los tres) son los que hay que mirar primero.


