Coste del traspaso multiagente: qué usa en tokens una cadena de 3 agentes
Descubre por qué cada agente de una cadena vuelve a leer todos los traspasos anteriores, cuánto cuesta eso en tokens y tres cambios que reducen la entrada.
En esta página
- Dónde se acumulan los tokens
- Cuánto cuestan 100 tareas al día
- Tres formas de reducir la factura
- 1. Haz que el traspaso sea una nota corta y estructurada
- 2. Pasa a cada agente solo lo que necesita
- 3. Da un modelo barato a los roles cortos
- ¿Por qué no pasar simplemente la caché KV?
- Antes de escalar a cientos de ejecuciones
Tus tres agentes terminaron el trabajo, y la factura es más grande de lo que parece el trabajo. La razón es simple: con traspasos de texto, cada agente paga por leer todo lo que escribieron los agentes anteriores. Un plan de 1.500 tokens se paga una vez cuando el planificador lo escribe, luego otra vez el programador, y otra vez el revisor. Recorta el traspaso, entrega a cada agente solo lo que necesita, y la entrada de cada agente posterior se hace más pequeña.
A continuación: un ejemplo resuelto de 3 agentes con su cálculo de tokens, una estimación de coste para 100 tareas al día con precios en vivo, y tres cambios que puedes hacer hoy. Las APIs de chat-completions son sin estado, así que cada petición vuelve a llevar su contexto completo (por qué un chat largo cuesta más y cómo funciona el array de mensajes cubren lo básico).
Dónde se acumulan los tokens#
Supón que ejecutas un planificador, un programador y un revisor. La tarea más las instrucciones son 1.000 tokens. El planificador escribe un plan de 1.500 tokens, el programador escribe 3.000 tokens de código y notas, el revisor escribe un veredicto de 800 tokens. Son cifras redondas para el ejemplo, no una medición; sustituye las tuyas desde el campo usage (cómo leerlo).
Adivina el número
¿Cuántos tokens lee el revisor como entrada?
Tu respuesta
08000
Mostrar respuesta
Respuesta: 5500
5.500: la tarea (1.000), el plan (1.500) y el código (3.000) llegan todos en su petición.
La entrada de cada agente es la tarea más cada traspaso que recibe:
Desplaza la tabla hacia la derecha →
| Agente | Lee (entrada) | Escribe (salida) |
|---|---|---|
| Planificador | 1.000 (tarea) | 1.500 |
| Programador | 1.000 + 1.500 = 2.500 | 3.000 |
| Revisor | 1.000 + 1.500 + 3.000 = 5.500 | 800 |
| Cadena completa | 1.000 + 2.500 + 5.500 = 9.000 | 1.500 + 3.000 + 800 = 5.300 |
La cadena lee 9.000 tokens para producir 5.300. Añade un cuarto agente y leería la tarea más los tres traspasos, así que la entrada crece con cada salto, no solo con un traspaso.
Cuánto cuestan 100 tareas al día#
Un token de traspaso se factura una vez como salida, cuando el agente lo escribe, y luego como entrada para cada agente posterior que lo lee. Los tokens de salida tienen un precio mayor que los de entrada, así que en este ejemplo las respuestas son la mayor parte de la factura aunque la cadena lea más de lo que escribe (tokens de entrada vs salida).
Una tarea son 9.000 tokens de entrada y 5.300 de salida. En MiniMax-M2.7 eso es $0.0012 por tarea. Para 100 tareas al día, estos son los precios en vivo de nuestros modelos, junto a OpenRouter:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 100 solicitudes | OpenRouter, 100 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
9000 tokens de entrada y 5300 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
En total, contando entrada y salida juntas, los modelos de CheapTokens de arriba salen más baratos que OpenRouter para esta cadena.
¿Quieres el cálculo para tu propia cadena? Pon la petición media de un agente en la calculadora: unos 3.000 tokens de entrada y 1.800 de salida, repetido 300 veces, son 100 tareas de tres agentes.
Calculadora de costos
100 tareas al día, tres agentes cada una
Tokens de entrada por solicitud: 3000 · Tokens de salida por solicitud: 1800 · Solicitudes por día: 300
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
Tres formas de reducir la factura#
1. Haz que el traspaso sea una nota corta y estructurada#
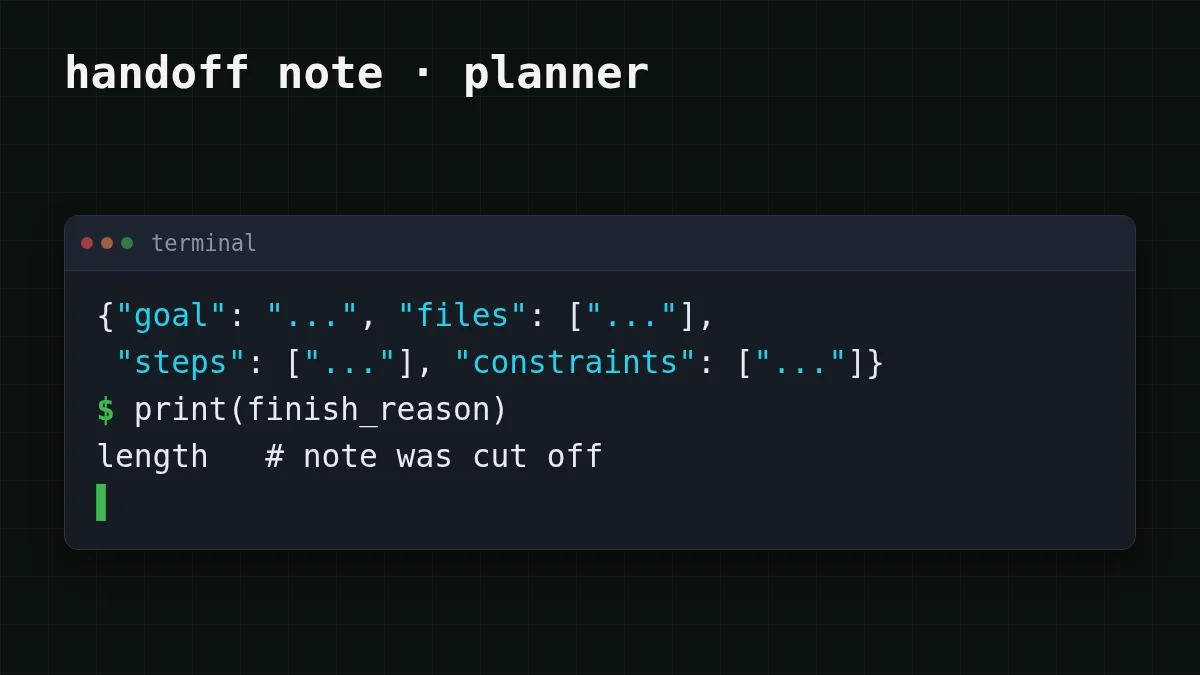
El planificador no necesita escribir un ensayo para el programador. Pide campos: objetivo, archivos, pasos, restricciones. Digamos que una nota corta de ocho pasos de una línea ocupa unos 400 tokens en lugar de 1.500 (una suposición: pon tu propia cifra desde usage), y cada agente posterior lee esa nota más pequeña. Limita la respuesta con max_tokens, fijado un poco por encima de la nota esperada, para que un modelo charlatán no pueda colar el ensayo de nuevo.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)
Si finish_reason es length, la nota se cortó por el límite: sube max_tokens un poco o acorta el esquema (cómo se ve ese error). El id del modelo y la URL base están en la documentación de CheapTokens.
2. Pasa a cada agente solo lo que necesita#
Si el revisor comprueba el código contra la tarea, no necesita el plan: la tarea y el código bastan. Si además comprueba el código contra el plan, mantén el plan. Quitar el plan de su contexto es un cambio de una línea en tu orquestador:
Comparar
Lo que lee el revisor
Antes: todo
Tarea 1.000 + plan 1.500 + código 3.000 = 5.500 tokens de entrada.
Después: tarea y código
Tarea 1.000 + código 3.000 = 4.000 tokens de entrada.
Con ambos cambios (y la nota de 400 tokens, que es nuestra suposición), la cadena del ejemplo pasa a ser planificador 1.000 de entrada y 400 de salida, programador 1.000 + 400 = 1.400 de entrada y 3.000 de salida, revisor 1.000 + 3.000 = 4.000 de entrada y 800 de salida. Eso es 1.000 + 1.400 + 4.000 = 6.400 tokens de entrada y 400 + 3.000 + 800 = 4.200 de salida, frente a 9.000 y 5.300 antes. Las mismas 100 tareas al día:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 100 solicitudes | OpenRouter, 100 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
6400 tokens de entrada y 4200 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Para una tarea en MiniMax-M2.7 la cadena recortada es $0.00095, frente a $0.0012.
3. Da un modelo barato a los roles cortos#
El planificador escribe respuestas cortas, así que empieza por ahí: prueba GLM-5.3-Flash (contexto de 390K, hasta 8.192 tokens de salida por respuesta) y compara el resultado en 10–20 de tus propias tareas. El programador escribe las respuestas más largas: DeepSeek-V4-Flash permite hasta 32.768 tokens de salida por respuesta. Como cada modelo se apoya en un único saldo con un único precio a cualquier hora, mezclarlos en una cadena solo requiere una cadena model distinta por agente. Los precios actuales de ambos están en la tabla de precios y en la página de DeepSeek.
¿Por qué no pasar simplemente la caché KV?#
El artículo SwaT (arXiv:2610.15095), enviado el 10 de octubre de 2026 por Alabdulkareem, Tenison, Zhang, Zhu, Katz y Gutfreund, propone exactamente eso: los agentes se pasan entre sí el estado de la caché KV en lugar de texto, para que el receptor se salte volver a leer el texto. Según la página del resumen (leída el 31 de octubre de 2026), los autores reportan un 40% más de precisión media (con compactación de la caché KV) que la comunicación texto a texto y un tiempo medio de reloj 4x más rápido en 17 benchmarks, 12 LLMs y 6 familias de modelos. El 40% es precisión, no un ahorro en tokens o precio.
Un método de investigación como este necesita acceso a la caché interna del modelo. Una petición de chat-completions recibe texto y devuelve texto, así que con una API tu palanca es el texto: los tres cambios de arriba.
Antes de escalar a cientos de ejecuciones#
Lista de verificación
Lista de comprobación del traspaso
Para una visión más amplia de los presupuestos de agentes, consulta cómo estimar el coste de un agente de IA y por qué los agentes usan tantos tokens.


