Optymalizacja kosztówPrzewodnik
Koszt przekazania w multi-agentach: ile tokenów zużywa łańcuch 3 agentów
Zobacz, dlaczego każdy agent w łańcuchu ponownie odczytuje wszystkie wcześniejsze przekazania, ile to kosztuje w tokenach i jakie trzy zmiany zmniejszają wejście.
Na tej stronie
- Gdzie gromadzą się tokeny
- Ile kosztuje 100 zadań dziennie
- Trzy sposoby na zmniejszenie rachunku
- 1. Zrób z przekazania krótką, ustrukturyzowaną notatkę
- 2. Przekazuj każdemu agentowi tylko to, czego potrzebuje
- 3. Daj krótkim rolom tani model
- Dlaczego nie przekazać po prostu pamięci podręcznej KV?
- Zanim skalibrujesz do setek uruchomień
Twoi trzej agenci skończyli pracę, a rachunek jest większy, niż wygląda sama praca. Powód jest prosty: przy przekazywaniu tekstu każdy agent płaci za odczytanie wszystkiego, co napisali agenci przed nim. Plan o długości 1 500 tokenów jest opłacany raz, gdy pisze go planista, potem ponownie przez programistę, a potem jeszcze raz przez recenzenta. Skróć przekazanie, daj każdemu agentowi tylko to, czego potrzebuje, a wejście każdego późniejszego agenta się zmniejszy.
Poniżej: rozpisany przykład z 3 agentami wraz z obliczeniami tokenów, szacunek kosztów dla 100 zadań dziennie na podstawie aktualnych cen oraz trzy zmiany, które możesz wprowadzić już dziś. API chat-completions są bezstanowe, więc każde żądanie ponownie niesie swój pełny kontekst (dlaczego długi czat kosztuje więcej i jak działa tablica messages omawiają podstawy).
Gdzie gromadzą się tokeny#
Załóżmy, że uruchamiasz planistę, programistę i recenzenta. Zadanie plus instrukcje to 1 000 tokenów. Planista pisze plan o długości 1 500 tokenów, programista pisze 3 000 tokenów kodu i notatek, recenzent pisze werdykt o długości 800 tokenów. To okrągłe liczby dla przykładu, a nie pomiar; podstaw własne z pola usage (jak je odczytać).
Zgadnij liczbę
Ile tokenów recenzent odczytuje jako wejście?
Twoje przypuszczenie
08000
Pokaż odpowiedź
Odpowiedź: 5500
5 500: zadanie (1 000), plan (1 500) i kod (3 000) wszystkie trafiają do jego żądania.
Wejście każdego agenta to zadanie plus każde przekazanie, które otrzymuje:
Przewiń tabelę w prawo →
| Agent | Odczytuje (wejście) | Zapisuje (wyjście) |
|---|---|---|
| Planista | 1 000 (zadanie) | 1 500 |
| Programista | 1 000 + 1 500 = 2 500 | 3 000 |
| Recenzent | 1 000 + 1 500 + 3 000 = 5 500 | 800 |
| Cały łańcuch | 1 000 + 2 500 + 5 500 = 9 000 | 1 500 + 3 000 + 800 = 5 300 |
Łańcuch odczytuje 9 000 tokenów, aby wyprodukować 5 300. Dodaj czwartego agenta, a odczyta on zadanie plus wszystkie trzy przekazania, więc wejście rośnie z każdym krokiem, a nie tylko o jedno przekazanie.
Ile kosztuje 100 zadań dziennie#
Token przekazania jest rozliczany raz jako wyjście, gdy agent go zapisuje, a następnie jako wejście dla każdego późniejszego agenta, który go odczytuje. Tokeny wyjściowe są wyceniane wyżej niż tokeny wejściowe, więc w tym przykładzie odpowiedzi stanowią większą część rachunku, mimo że łańcuch odczytuje więcej, niż zapisuje (tokeny wejściowe vs wyjściowe).
Jedno zadanie to 9 000 tokenów na wejściu i 5 300 na wyjściu. Na MiniMax-M2.7 to $0.0012 za zadanie. Dla 100 zadań dziennie oto aktualne ceny naszych modeli w porównaniu z OpenRouter:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 100 żądań | OpenRouter, 100 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
9000 tokenów wejściowych i 5300 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Łącznie, licząc wejście i wyjście razem, modele CheapTokens powyżej wypadają taniej niż OpenRouter dla tego łańcucha.
Chcesz obliczenia dla własnego łańcucha? Wpisz średnie żądanie jednego agenta do kalkulatora: około 3 000 tokenów na wejściu i 1 800 na wyjściu, powtórzone 300 razy, to 100 zadań po trzech agentów.
Kalkulator kosztów
100 zadań dziennie, po trzech agentów każde
Tokeny wejściowe na żądanie: 3000 · Tokeny wyjściowe na żądanie: 1800 · Żądania dziennie: 300
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
Trzy sposoby na zmniejszenie rachunku#
1. Zrób z przekazania krótką, ustrukturyzowaną notatkę#
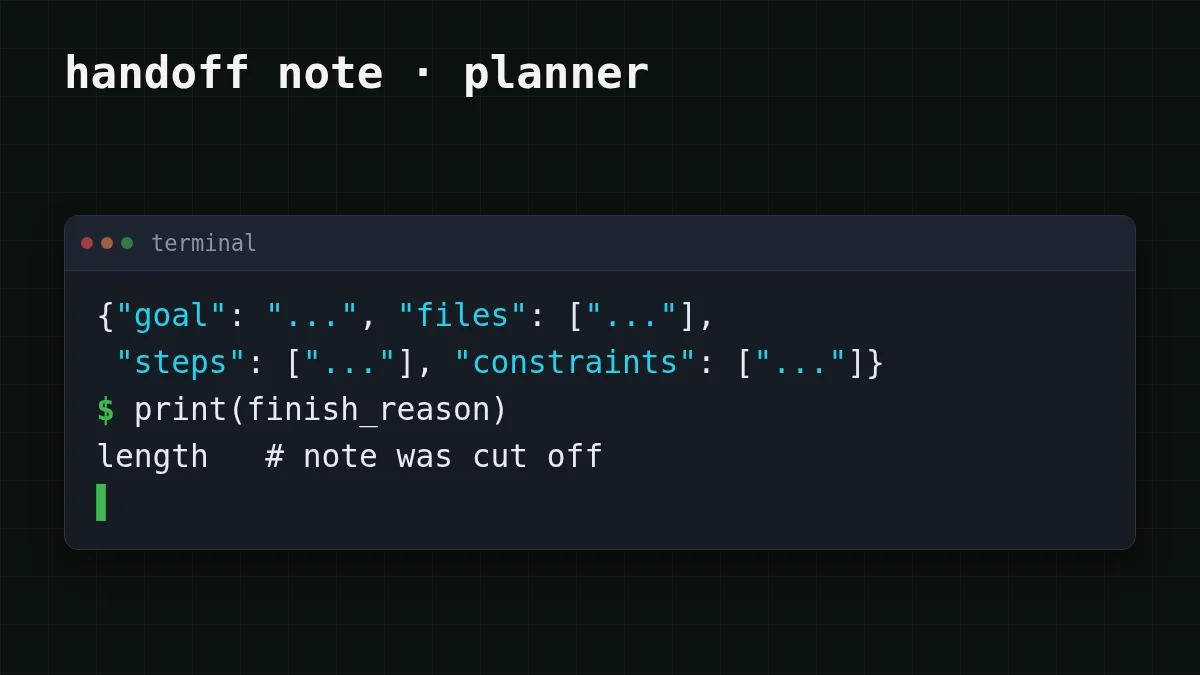
Planista nie musi pisać eseju dla programisty. Poproś o pola: cel, pliki, kroki, ograniczenia. Powiedzmy, że krótka notatka z ośmiu jednolinijkowych kroków zajmuje około 400 tokenów zamiast 1 500 (założenie: podstaw własną liczbę z usage), a każdy późniejszy agent odczytuje tę mniejszą notatkę. Ogranicz odpowiedź za pomocą max_tokens, ustawionego nieco powyżej oczekiwanej notatki, aby gadatliwy model nie mógł przemycić z powrotem eseju.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)
Jeśli finish_reason to length, notatka została ucięta przez limit: zwiększ nieco max_tokens lub skróć schemat (jak wygląda ten błąd). Identyfikator modelu i bazowy URL są w dokumentacji CheapTokens.
2. Przekazuj każdemu agentowi tylko to, czego potrzebuje#
Jeśli recenzent sprawdza kod względem zadania, nie potrzebuje planu: zadanie i kod wystarczą. Jeśli sprawdza też kod względem planu, zachowaj plan. Wycięcie planu z jego kontekstu to zmiana jednej linii w twoim orkiestratorze:
Porównaj
Co odczytuje recenzent
Przed: wszystko
Zadanie 1 000 + plan 1 500 + kod 3 000 = 5 500 tokenów na wejściu.
Po: zadanie i kod
Zadanie 1 000 + kod 3 000 = 4 000 tokenów na wejściu.
Przy obu zmianach (oraz notatce 400 tokenów, co jest naszym założeniem) przykładowy łańcuch staje się następujący: planista 1 000 na wejściu i 400 na wyjściu, programista 1 000 + 400 = 1 400 na wejściu i 3 000 na wyjściu, recenzent 1 000 + 3 000 = 4 000 na wejściu i 800 na wyjściu. To daje 1 000 + 1 400 + 4 000 = 6 400 tokenów na wejściu i 400 + 3 000 + 800 = 4 200 na wyjściu, w porównaniu z 9 000 i 5 300 wcześniej. Te same 100 zadań dziennie:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 100 żądań | OpenRouter, 100 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
6400 tokenów wejściowych i 4200 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Dla jednego zadania na MiniMax-M2.7 skrócony łańcuch to $0.00095, w dół z $0.0012.
3. Daj krótkim rolom tani model#
Planista pisze krótkie odpowiedzi, więc zacznij od tego: wypróbuj GLM-5.3-Flash (kontekst 390K, do 8 192 tokenów wyjściowych na odpowiedź) i porównaj wynik na 10–20 własnych zadaniach. Programista pisze najdłuższe odpowiedzi: DeepSeek-V4-Flash pozwala na do 32 768 tokenów wyjściowych na odpowiedź. Ponieważ każdy model korzysta z jednego salda z jedną ceną o każdej porze, mieszanie ich w jednym łańcuchu wymaga tylko innego ciągu model dla każdego agenta. Aktualne ceny obu są w tabeli cen oraz na stronie DeepSeek.
Dlaczego nie przekazać po prostu pamięci podręcznej KV?#
Praca SwaT (arXiv:2610.15095), przesłana 10 października 2026 przez Alabdulkareem, Tenison, Zhang, Zhu, Katz i Gutfreund, proponuje dokładnie to: agenci przekazują sobie nawzajem stan pamięci podręcznej KV zamiast tekstu, więc odbiorca pomija ponowne odczytywanie tekstu. Według strony streszczenia (odczytanej 31 października 2026) autorzy raportują o 40% wyższą średnią dokładność (z kompakcją pamięci podręcznej KV) niż przy komunikacji tekst-do-tekstu oraz 4x szybszy średni czas rzeczywisty na 17 benchmarkach, 12 LLM-ach i 6 rodzinach modeli. Te 40% to dokładność, a nie oszczędność na tokenach czy cenie.
Metoda badawcza taka jak ta wymaga dostępu do wewnętrznej pamięci podręcznej modelu. Żądanie chat-completions przyjmuje tekst na wejściu i zwraca tekst na wyjściu, więc w przypadku API twoją dźwignią jest tekst: trzy powyższe zmiany.
Zanim skalibrujesz do setek uruchomień#
Lista kontrolna
Lista kontrolna przekazania
Aby zobaczyć szerszy obraz budżetów agentów, zobacz jak oszacować koszt agenta AI i dlaczego agenci zużywają tak wiele tokenów.


