Coût des transferts multi-agents : ce qu'une chaîne de 3 agents utilise en tokens
Voyez pourquoi chaque agent d'une chaîne relit tous les transferts précédents, ce que cela coûte en tokens, et trois changements qui réduisent l'entrée.
Sur cette page
- Où les tokens s'accumulent
- Ce que coûtent 100 tâches par jour
- Trois façons de réduire la facture
- 1. Faites du transfert une courte note structurée
- 2. Ne passez à chaque agent que ce dont il a besoin
- 3. Donnez un modèle bon marché aux rôles courts
- Pourquoi ne pas simplement passer le cache KV ?
- Avant de passer à des centaines d'exécutions
Vos trois agents ont terminé le travail, et la facture est plus grosse que le travail n'y paraît. La raison est simple : avec des transferts en texte, chaque agent paie pour lire tout ce que les agents précédents ont écrit. Un plan de 1 500 tokens est payé une fois quand le planificateur l'écrit, puis à nouveau par le codeur, puis à nouveau par le relecteur. Réduisez le transfert, ne donnez à chaque agent que ce dont il a besoin, et l'entrée de chaque agent suivant diminue.
Ci-dessous : un exemple concret à 3 agents avec son calcul de tokens, une estimation de coût pour 100 tâches par jour aux prix actuels, et trois changements que vous pouvez faire dès aujourd'hui. Les API de chat-completions sont sans état, donc chaque requête transporte à nouveau tout son contexte (pourquoi un long chat coûte plus cher et comment fonctionne le tableau messages couvrent les bases).
Où les tokens s'accumulent#
Disons que vous avez un planificateur, un codeur et un relecteur. La tâche plus les instructions font 1 000 tokens. Le planificateur écrit un plan de 1 500 tokens, le codeur écrit 3 000 tokens de code et de notes, le relecteur écrit un verdict de 800 tokens. Ce sont des chiffres ronds pour l'exemple, pas une mesure ; remplacez-les par les vôtres depuis le champ usage (comment le lire).
Devinez le nombre
Combien de tokens le relecteur lit-il en entrée ?
Votre estimation
08 000
Afficher la réponse
Réponse: 5 500
5 500 : la tâche (1 000), le plan (1 500) et le code (3 000) arrivent tous dans sa requête.
L'entrée de chaque agent est la tâche plus chaque transfert qu'il reçoit :
Faites défiler le tableau vers la droite →
| Agent | Lit (entrée) | Écrit (sortie) |
|---|---|---|
| Planificateur | 1 000 (tâche) | 1 500 |
| Codeur | 1 000 + 1 500 = 2 500 | 3 000 |
| Relecteur | 1 000 + 1 500 + 3 000 = 5 500 | 800 |
| Chaîne entière | 1 000 + 2 500 + 5 500 = 9 000 | 1 500 + 3 000 + 800 = 5 300 |
La chaîne lit 9 000 tokens pour produire 5 300. Ajoutez un quatrième agent et il lirait la tâche plus les trois transferts, donc l'entrée augmente à chaque saut, pas seulement d'un transfert.
Ce que coûtent 100 tâches par jour#
Un token de transfert est facturé une fois en sortie, quand l'agent l'écrit, puis en entrée pour chaque agent suivant qui le lit. Les tokens de sortie sont facturés plus cher que les tokens d'entrée, donc dans cet exemple les réponses représentent la plus grosse part de la facture même si la chaîne lit plus qu'elle n'écrit (tokens d'entrée vs sortie).
Une tâche fait 9 000 tokens en entrée et 5 300 en sortie. Sur MiniMax-M2.7, cela fait $0.0012 par tâche. Pour 100 tâches par jour, voici les prix actuels de nos modèles, à côté d'OpenRouter :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 100 requêtes | OpenRouter, 100 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
9 000 tokens d'entrée et 5 300 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Au total, en comptant l'entrée et la sortie ensemble, les modèles CheapTokens ci-dessus reviennent moins cher qu'OpenRouter pour cette chaîne.
Vous voulez le calcul pour votre propre chaîne ? Mettez la requête moyenne d'un agent dans le calculateur : environ 3 000 tokens en entrée et 1 800 en sortie, répété 300 fois, cela fait 100 tâches de trois agents.
Calculateur de coût
100 tâches par jour, trois agents chacune
Tokens d'entrée par requête: 3 000 · Tokens de sortie par requête: 1 800 · Requêtes par jour: 300
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
Trois façons de réduire la facture#
1. Faites du transfert une courte note structurée#
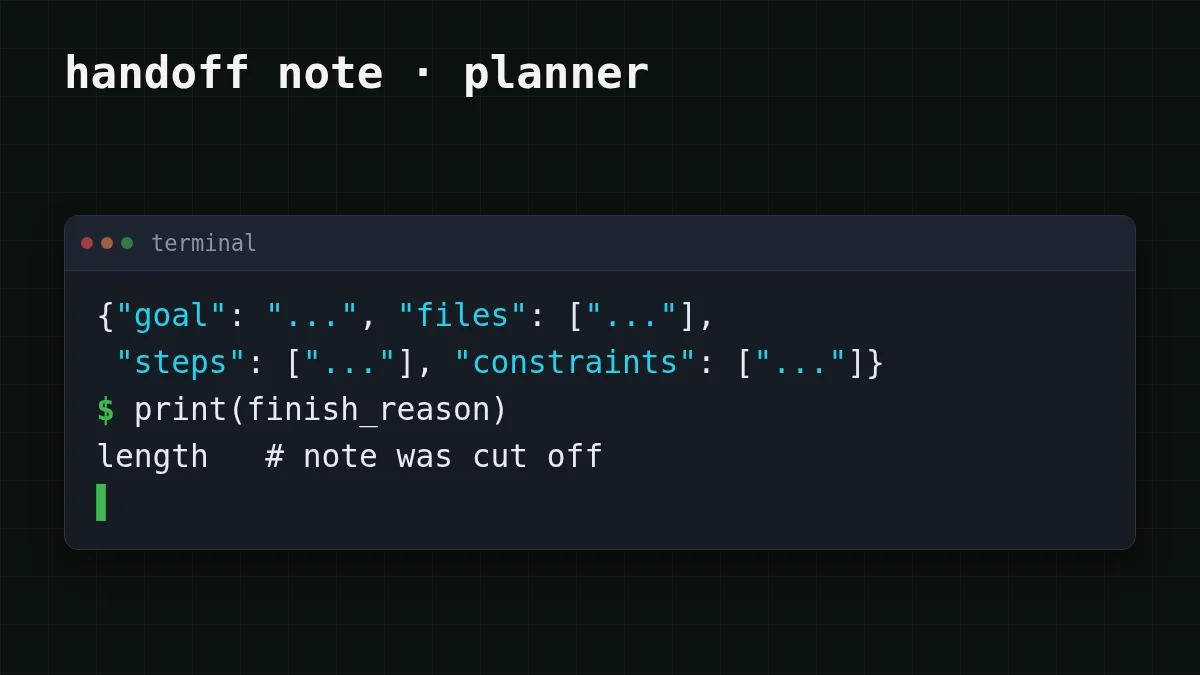
Le planificateur n'a pas besoin d'écrire une dissertation pour le codeur. Demandez des champs : objectif, fichiers, étapes, contraintes. Disons qu'une courte note de huit étapes d'une ligne prend environ 400 tokens au lieu de 1 500 (une hypothèse : mettez votre propre chiffre depuis usage), et chaque agent suivant lit cette note plus petite. Limitez la réponse avec max_tokens, réglé un peu au-dessus de la note attendue, pour qu'un modèle bavard ne puisse pas réintroduire la dissertation.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)
Si finish_reason vaut length, la note a été coupée par la limite : augmentez un peu max_tokens ou raccourcissez le schéma (à quoi ressemble cette erreur). L'identifiant du modèle et l'URL de base sont dans la documentation CheapTokens.
2. Ne passez à chaque agent que ce dont il a besoin#
Si le relecteur vérifie le code par rapport à la tâche, il n'a pas besoin du plan : la tâche et le code suffisent. S'il vérifie aussi le code par rapport au plan, gardez le plan. Retirer le plan de son contexte est un changement d'une ligne dans votre orchestrateur :
Comparer
Ce que lit le relecteur
Avant : tout
Tâche 1 000 + plan 1 500 + code 3 000 = 5 500 tokens en entrée.
Après : tâche et code
Tâche 1 000 + code 3 000 = 4 000 tokens en entrée.
Avec les deux changements (et la note de 400 tokens, qui est notre hypothèse), la chaîne de l'exemple devient : planificateur 1 000 en entrée et 400 en sortie, codeur 1 000 + 400 = 1 400 en entrée et 3 000 en sortie, relecteur 1 000 + 3 000 = 4 000 en entrée et 800 en sortie. Cela fait 1 000 + 1 400 + 4 000 = 6 400 tokens en entrée et 400 + 3 000 + 800 = 4 200 en sortie, contre 9 000 et 5 300 avant. Mêmes 100 tâches par jour :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 100 requêtes | OpenRouter, 100 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
6 400 tokens d'entrée et 4 200 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Pour une tâche sur MiniMax-M2.7, la chaîne réduite coûte $0.00095, contre $0.0012.
3. Donnez un modèle bon marché aux rôles courts#
Le planificateur écrit des réponses courtes, alors commencez par là : essayez GLM-5.3-Flash (contexte de 390K, jusqu'à 8 192 tokens de sortie par réponse) et comparez le résultat sur 10 à 20 de vos propres tâches. Le codeur écrit les réponses les plus longues : DeepSeek-V4-Flash autorise jusqu'à 32 768 tokens de sortie par réponse. Comme chaque modèle est sur un seul solde avec un seul prix à toute heure, les mélanger dans une chaîne ne demande qu'une chaîne model différente par agent. Les prix actuels des deux sont dans le tableau des tarifs et sur la page DeepSeek.
Pourquoi ne pas simplement passer le cache KV ?#
L'article SwaT (arXiv:2610.15095), soumis le 10 octobre 2026 par Alabdulkareem, Tenison, Zhang, Zhu, Katz et Gutfreund, propose exactement cela : les agents s'échangent l'état du cache KV au lieu de texte, ainsi le destinataire évite de relire le texte. D'après la page de l'abstract (consultée le 31 octobre 2026), les auteurs rapportent une précision moyenne supérieure de 40 % (avec compactage du cache KV) par rapport à la communication texte-à-texte et un temps réel moyen 4 fois plus rapide sur 17 benchmarks, 12 LLMs et 6 familles de modèles. Les 40 % concernent la précision, pas une économie de tokens ou de prix.
Une méthode de recherche comme celle-ci nécessite l'accès au cache interne du modèle. Une requête chat-completions prend du texte en entrée et donne du texte en sortie, donc avec une API votre levier est le texte : les trois changements ci-dessus.
Avant de passer à des centaines d'exécutions#
Liste de contrôle
Liste de contrôle des transferts
Pour une vue d'ensemble des budgets d'agents, voir comment estimer le coût d'un agent IA et pourquoi les agents utilisent autant de tokens.


