Actus IAMise à jour
Mistral Large 4 à poids ouverts : prix de l'API et coût par tâche d'agent
Mistral Large 4 est désormais à poids ouverts, avec les tarifs d'API de Mistral. Découvrez ce que coûte une tâche d'agent de codage et quand un modèle moins cher convient.
Sur cette page
Mistral Large 4 est désormais à poids ouverts : Mistral a publié les poids le 29 octobre 2026 et a fixé le prix de l'API à 0,70 $ par 1M de tokens d'entrée et 2,10 $ par 1M de tokens de sortie (0,07 $ pour l'entrée mise en cache). Si vous faites tourner des agents de codage, la question utile n'est pas le prix par token mais ce que coûte au total une longue tâche.
Ce que Mistral a annoncé#
D'après la page de publication de Mistral (consultée le 30 octobre 2026), Mistral Large 4 est un modèle d'environ 1T de paramètres, un hybride d'instruct et de raisonnement construit comme un mélange d'experts. Il est nativement multimodal en entrée, couvre plus de 160 langues et propose trois modes de raisonnement, Low, Medium et High, avec High par défaut. Le dépôt Hugging Face est Mistral- ; l'id de l'API est mistral-.
Les poids sont distribués sous la licence Mistral Ecosystem Open-Weight, une MIT modifiée. L'usage commercial et le fine-tuning sont autorisés. Vendre le modèle comme service hébergé nécessite une licence commerciale séparée de Mistral. Vous pouvez l'exécuter avec vLLM ou SGLang, via NVIDIA NIM ou TensorRT-LLM, ou utiliser l'API de Mistral, Microsoft Foundry et Mistral Vibe Code.
Sur les benchmarks, Mistral rapporte ses propres chiffres : 41 % sur Terminal-Bench 4.0 (la preview obtenait 28 %), 19,7 % sur FrontierCode 2.0, 84,5 % sur BrowseComp, et 48 % sur l'Artificial Analysis Coding Agent Index, que Mistral dit au niveau de GLM-5.3 avec 47 % de tokens en moins par tâche. Ce sont les résultats de l'éditeur, pas des résultats indépendants : traitez-les comme une raison de tester sur votre propre dépôt plutôt que comme un verdict.
Ce que coûte une tâche d'agent au prix de Mistral#
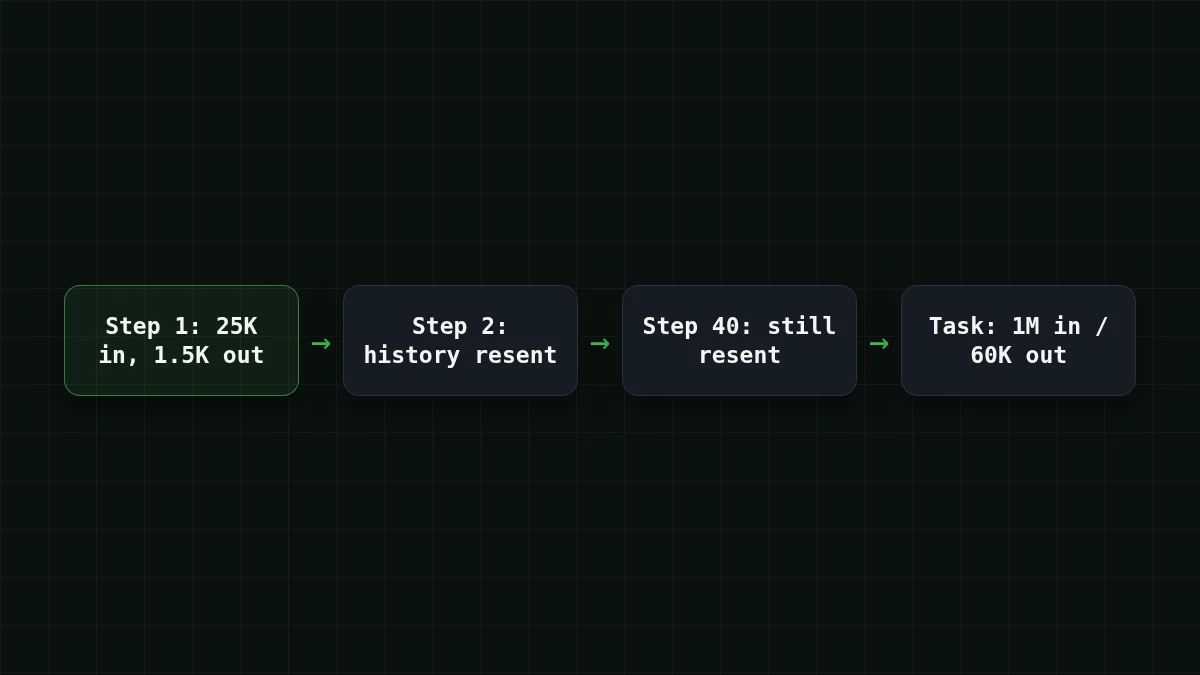
Commencez par la façon dont un agent dépense réellement des tokens. Chaque étape renvoie la conversation jusqu'ici, donc l'entrée s'accumule tandis que chaque réponse reste courte. Supposons qu'un agent de codage en terminal fasse 40 étapes sur une tâche, avec environ 25 000 tokens d'entrée et 1 500 tokens de sortie par étape. C'est une hypothèse à titre d'illustration ; remplacez-la par vos propres chiffres.
Devinez le nombre
40 étapes à environ 25 000 tokens d'entrée chacune : combien de milliers de tokens d'entrée la tâche envoie-t-elle au total ?
Votre estimation
02 000
Afficher la réponse
Réponse: 1 000
25 000 × 40 = 1 000 000 de tokens d'entrée, donc 1 000 milliers. L'agent renvoie son contexte à chaque étape, c'est pourquoi le volume d'entrée domine les factures d'agent.
Au prix publié par Mistral (30 octobre 2026), cette tâche coûte 1 000 000 × 0,70 $ / 1M = 0,70 $ pour l'entrée et 60 000 × 2,10 $ / 1M = 0,126 $ pour la sortie, soit 0,70 $ + 0,126 $ = 0,826 $ par tâche. Le côté entrée représente l'essentiel de la facture.
Le cache change la donne. Si 20 000 des 25 000 tokens d'entrée de chaque étape sont servis depuis le cache à 0,07 $ par 1M, une étape coûte 20 000 × 0,07 $ / 1M = 0,0014 $ pour l'entrée en cache, 5 000 × 0,70 $ / 1M = 0,0035 $ pour l'entrée fraîche et 1 500 × 2,10 $ / 1M = 0,00315 $ pour la sortie. Soit 0,00805 $ par étape, et 0,00805 $ × 40 = 0,322 $ par tâche. Le taux de 80 % de succès du cache est une autre hypothèse, donc vérifiez ce que rapporte votre outil.
Voici la même charge de travail sur un calculateur que vous pouvez déplacer :
Calculateur de coût
Une tâche d'agent de codage : 40 étapes
Tokens d'entrée par requête: 25 000 · Tokens de sortie par requête: 1 500 · Requêtes par jour: 40
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
Et la même tâche tarifée sur les modèles CheapTokens, en direct, à côté d'OpenRouter :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 40 requêtes | OpenRouter, 40 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
25 000 tokens d'entrée et 1 500 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Pour cette boucle d'agent, DeepSeek-V4-Flash sur CheapTokens revient à $0.021 pour toute la tâche, au total avec l'entrée et la sortie comptées ensemble, et c'est moins cher que le prix de référence d'OpenRouter au total. Il dispose d'une fenêtre de contexte de 380K et de jusqu'à 32 768 tokens de sortie par réponse, à un prix unique à toute heure de la journée.
Poids ouverts ou API#
Les poids sont la partie intéressante de cette publication. Si vos données ne peuvent pas quitter votre réseau, ou si vous voulez faire du fine-tuning, vous pouvez désormais le faire avec un modèle de cette classe. Le coût de cette voie, c'est le matériel. Un modèle de 1T de paramètres nécessite un serveur multi-GPU même si seule une partie est active par token, et la page de Mistral n'indique pas le nombre de paramètres actifs (le A52B dans le nom du dépôt suggère 52B, mais c'est une déduction à partir du nom). La page de Mistral n'indique pas non plus la taille du contexte.
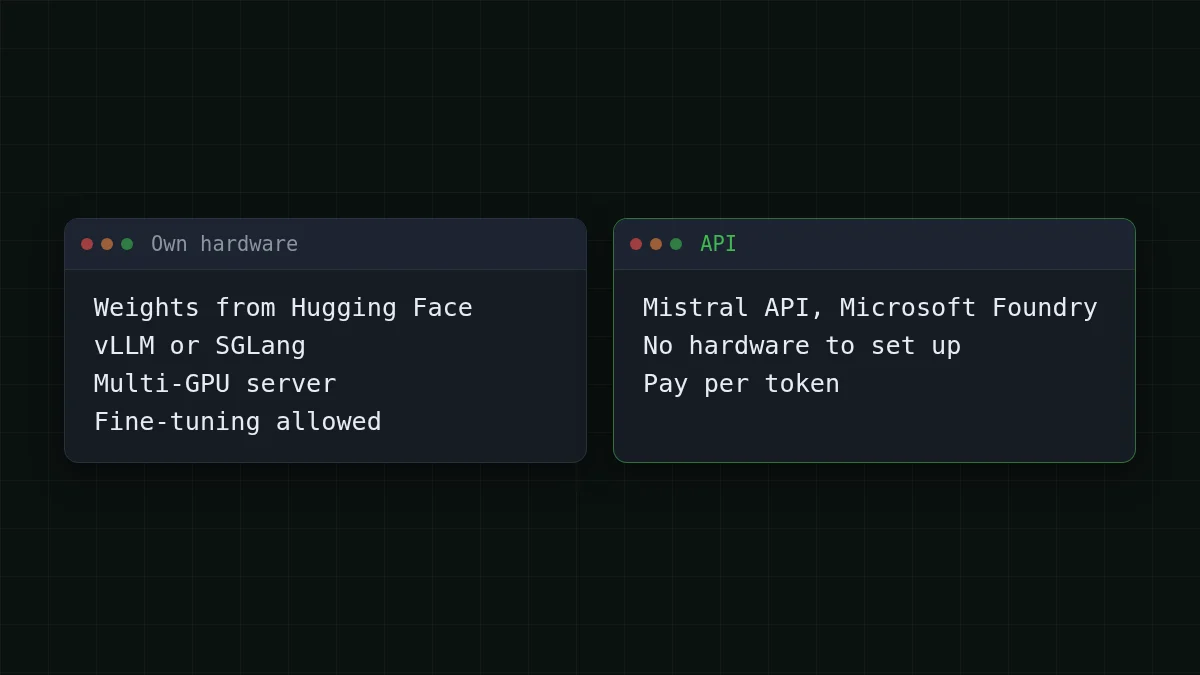
Pour la plupart des équipes qui veulent simplement qu'un agent termine des tickets, la voie API évite cette installation. Si vous voulez le contexte sur ce que signifient les poids ouverts en pratique, voir ce que sont les poids ouverts et la quantification.
La même tâche sur un modèle d'agent que vous pouvez appeler dès aujourd'hui#
Si votre objectif est un agent de terminal ou d'IDE qui exécute de nombreuses étapes à moindre coût, vous pouvez essayer la même boucle sur DeepSeek-V4-Flash ou GLM-5.3-Flash via CheapTokens. L'API est compatible OpenAI Chat Completions et Anthropic Messages, avec un seul solde pour tous les modèles. Utilisez l'id de modèle complet des docs CheapTokens ; les noms de modèles diffèrent selon les fournisseurs.
Une requête, deux clients
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
Le champ usage de la réponse indique les tokens d'entrée et de sortie, ce qui vous permet de mesurer l'étape de votre propre agent et de l'injecter dans le calculateur ci-dessus. Notre guide des coûts Cline montre comment budgéter une session entière, et les docs expliquent comment connecter d'autres outils. Pages des modèles : DeepSeek pas cher, et tarifs en direct.
Lequel pour quel usage#
Les poids ouverts sur votre propre matériel, et le fine-tuning, constituent une voie distincte, et c'est ce que cette publication ouvre. Pour une longue boucle d'étapes courtes, utilisez DeepSeek-V4-Flash sur CheapTokens : contexte de 380K, jusqu'à 32 768 tokens de sortie par réponse, un prix unique à toute heure de la journée, et moins cher qu'OpenRouter au total, avec l'entrée et la sortie comptées ensemble. GLM-5.3-Flash a un contexte de 390K. Le benchmark de Mistral se compare à GLM-5.3, et il ne précise pas quelle variante de GLM-5.3, donc ne transposez pas ses chiffres sur GLM-5.3-Flash. Lancez dix de vos propres tâches sur chacun et comparez les nombres de tokens ; la même approche est décrite dans comment le prix de GPT-6.1 Terra se traduit par tâche.


