AI 뉴스업데이트
Mistral Large 4 오픈 웨이트: API 가격과 에이전트 작업당 비용
Mistral Large 4가 이제 오픈 웨이트이며 Mistral의 API 가격이 책정되었습니다. 코딩 에이전트 작업 하나의 비용과 더 저렴한 모델이 적합한 경우를 확인하세요.
이 페이지의 내용
Mistral Large 4가 이제 오픈 웨이트가 되었습니다: Mistral은 2026년 10월 29일 가중치를 공개했고 API 가격을 100만 입력 토큰당 $0.70, 100만 출력 토큰당 $2.10(캐시된 입력은 $0.07)으로 책정했습니다. 코딩 에이전트를 운영한다면 유용한 질문은 토큰당 가격이 아니라 긴 작업 하나가 총 얼마가 되는가입니다.
Mistral이 발표한 내용#
Mistral의 릴리스 페이지(2026년 10월 30일 확인)에 따르면 Mistral Large 4는 약 1T 파라미터 모델로, instruct와 reasoning을 결합한 전문가 혼합(mixture of experts) 구조입니다. 입력에서 네이티브 멀티모달이며 160개 이상의 언어를 지원하고 Low, Medium, High 세 가지 추론 모드를 제공하며 High가 기본값입니다. Hugging Face 저장소는 Mistral-이고 API id는 mistral-입니다.
가중치는 수정된 MIT인 Mistral Ecosystem Open-Weight 라이선스로 배포됩니다. 상업적 사용과 파인튜닝이 허용됩니다. 모델을 호스팅 서비스로 판매하려면 Mistral의 별도 상업 라이선스가 필요합니다. vLLM이나 SGLang으로, NVIDIA NIM이나 TensorRT-LLM을 통해, 또는 Mistral 자체 API, Microsoft Foundry, Mistral Vibe Code를 사용해 실행할 수 있습니다.
벤치마크에서 Mistral은 자체 수치를 보고합니다: Terminal-Bench 4.0에서 41%(프리뷰는 28%), FrontierCode 2.0에서 19.7%, BrowseComp에서 84.5%, Artificial Analysis Coding Agent Index에서 48%이며, Mistral은 이것이 작업당 토큰을 47% 적게 쓰면서 GLM-5.3과 동등한 수준이라고 말합니다. 이는 벤더의 결과이지 독립적인 결과가 아니므로, 판결로 받아들이기보다는 자신의 저장소에서 테스트할 이유로 받아들이세요.
Mistral 가격에서 에이전트 작업 하나의 비용#
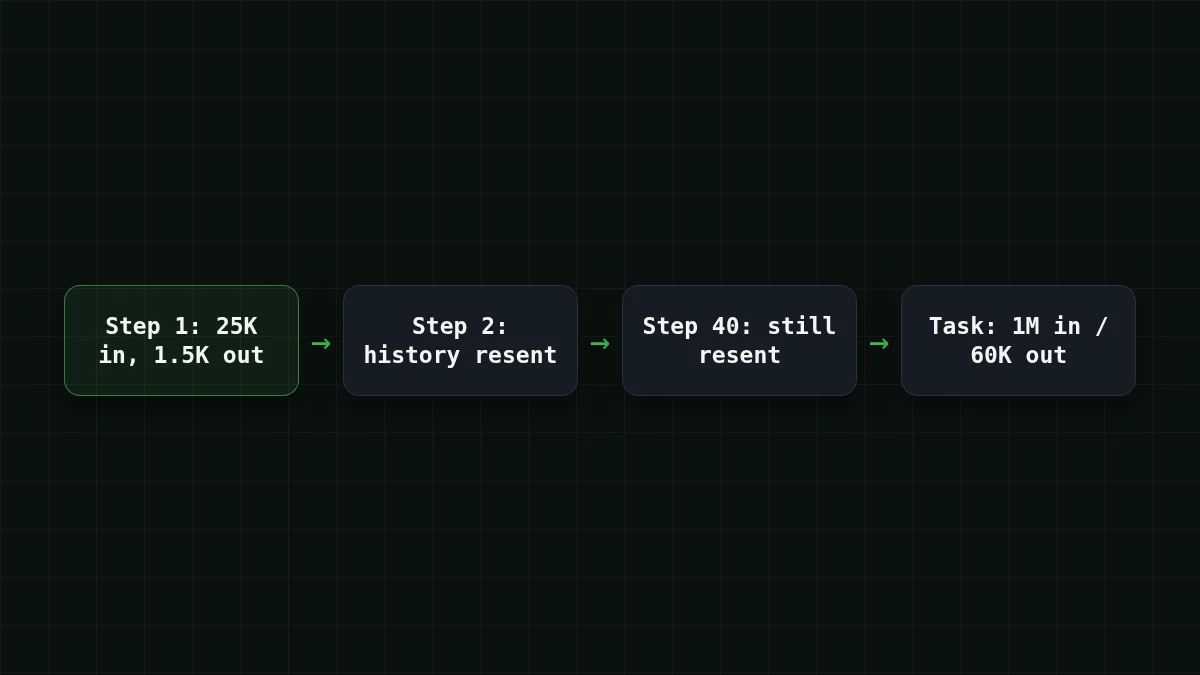
에이전트가 실제로 토큰을 어떻게 쓰는지부터 시작하겠습니다. 매 단계마다 지금까지의 대화를 다시 보내므로 입력이 쌓이는 반면 각 답변은 짧게 유지됩니다. 터미널 코딩 에이전트가 한 작업에서 40단계를 수행하고, 단계당 약 25,000 입력 토큰과 1,500 출력 토큰을 쓴다고 가정해 봅시다. 이는 설명을 위한 가정이니 자신의 수치로 바꿔 보세요.
숫자 맞히기
각 약 25,000 입력 토큰으로 40단계: 이 작업은 총 몇 천 입력 토큰을 보내는가?
내 추측
02,000
정답 보기
정답: 1,000
25,000 × 40 = 1,000,000 입력 토큰, 즉 1,000천. 에이전트는 매 단계마다 컨텍스트를 다시 보내므로 입력량이 에이전트 청구서를 지배합니다.
Mistral의 공개 가격(2026년 10월 30일)에서 그 작업은 입력에 1,000,000 × $0.70 / 1M = $0.70, 출력에 60,000 × $2.10 / 1M = $0.126이므로 작업당 $0.70 + $0.126 = $0.826입니다. 청구서의 대부분은 입력 쪽입니다.
캐싱은 그림을 바꿉니다. 각 단계의 25,000 입력 토큰 중 20,000개가 100만 토큰당 $0.07로 캐시에서 제공된다면, 한 단계는 캐시된 입력에 20,000 × $0.07 / 1M = $0.0014, 새 입력에 5,000 × $0.70 / 1M = $0.0035, 출력에 1,500 × $2.10 / 1M = $0.00315입니다. 즉 단계당 $0.00805이고, $0.00805 × 40 = 작업당 $0.322입니다. 80% 캐시 적중률 역시 또 다른 가정이므로 자신의 도구가 보고하는 값을 확인하세요.
다음은 움직일 수 있는 계산기에서 같은 워크로드를 계산한 것입니다:
비용 계산기
코딩 에이전트 작업 하나: 40단계
요청당 입력 토큰: 25,000 · 요청당 출력 토큰: 1,500 · 일일 요청 수: 40
| 모델 | 일일 | 월간 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
그리고 같은 작업을 CheapTokens 모델들에 걸쳐 실시간으로 가격을 매긴 것으로, OpenRouter와 나란히 비교한 것입니다:
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 40회 요청 | OpenRouter, 40회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
요청당 입력 25,000개 및 출력 1,500개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
이 에이전트 루프에서 CheapTokens의 DeepSeek-V4-Flash는 작업 전체에 $0.021이며, 입력과 출력을 합산한 총액 기준으로 OpenRouter의 참조 가격보다 저렴합니다. 380K 컨텍스트 윈도우와 답변당 최대 32,768 출력 토큰을 제공하며, 하루 중 어느 시간이든 단일 가격입니다.
오픈 웨이트 또는 API#
이번 릴리스에서 흥미로운 부분은 가중치입니다. 데이터가 네트워크를 떠날 수 없거나 파인튜닝을 원한다면 이제 이 등급의 모델로 그렇게 할 수 있습니다. 그 경로의 비용은 하드웨어입니다. 1T 파라미터 모델은 토큰당 일부만 활성화되더라도 멀티 GPU 서버가 필요하며, Mistral의 페이지는 활성 파라미터 수를 명시하지 않습니다(저장소 이름의 A52B은 52B를 시사하지만 이는 이름에서 추론한 것입니다). Mistral의 페이지는 컨텍스트 크기도 명시하지 않습니다.
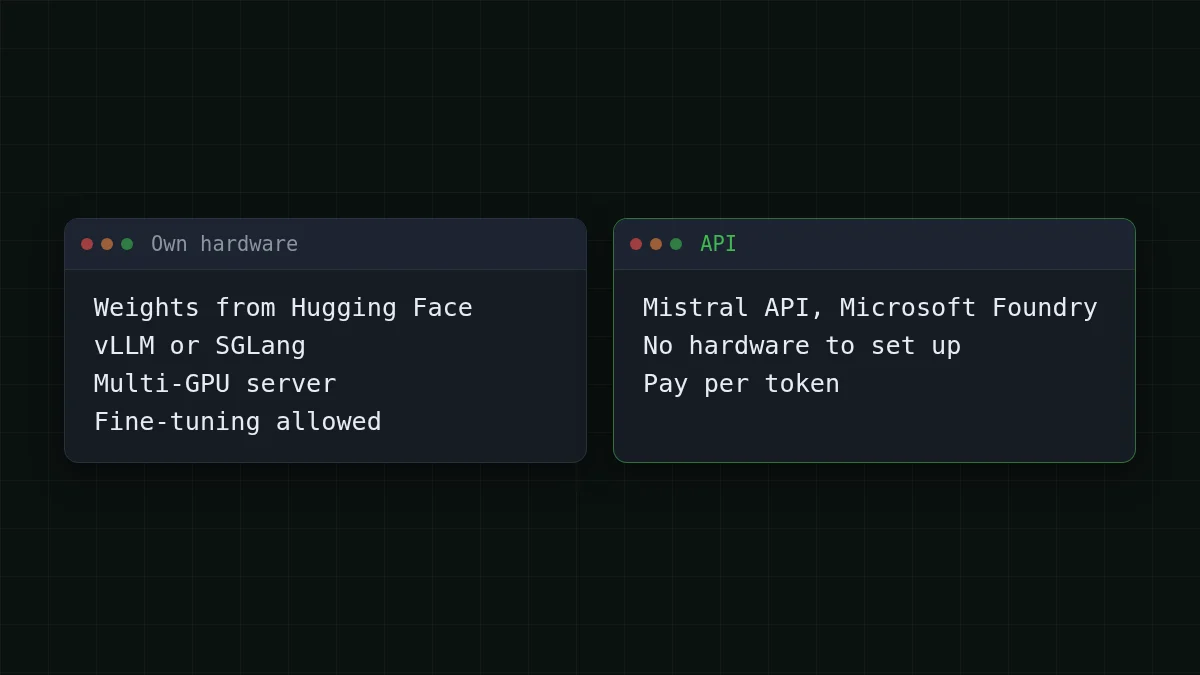
티켓을 끝내는 에이전트를 원하는 대부분의 팀에게 API 경로는 그런 설정을 피하게 해줍니다. 오픈 웨이트가 실제로 무엇을 의미하는지 배경을 원한다면 오픈 웨이트와 양자화란 무엇인가를 참고하세요.
오늘 호출할 수 있는 에이전트 모델에서 같은 작업#
목표가 많은 단계를 저렴하게 실행하는 터미널 또는 IDE 에이전트라면, CheapTokens를 통해 DeepSeek-V4-Flash나 GLM-5.3-Flash에서 같은 루프를 시도해 볼 수 있습니다. API는 OpenAI Chat Completions 및 Anthropic Messages와 호환되며, 모든 모델에 하나의 잔액을 사용합니다. 제공자마다 모델 이름이 다르므로 CheapTokens 문서의 전체 모델 id를 사용하세요.
요청 하나, 클라이언트 둘
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
응답의 usage 필드는 입력 및 출력 토큰을 보여주므로 자신의 에이전트 단계를 측정해 위 계산기에 넣을 수 있습니다. Cline 비용 가이드는 세션 전체의 예산을 잡는 방법을 보여주고, 문서는 다른 도구 연결을 다룹니다. 모델 페이지: 저렴한 DeepSeek, 실시간 가격.
어떤 작업에 무엇을 쓸까#
자체 하드웨어에서의 오픈 웨이트와 파인튜닝은 별개의 경로이며, 이번 릴리스가 열어주는 것이 바로 그것입니다. 짧은 단계가 긴 루프로 이어지는 경우에는 CheapTokens의 DeepSeek-V4-Flash를 사용하세요: 380K 컨텍스트, 답변당 최대 32,768 출력 토큰, 하루 중 어느 시간이든 단일 가격, 입력과 출력을 합산한 총액 기준으로 OpenRouter보다 저렴합니다. GLM-5.3-Flash는 390K 컨텍스트를 가집니다. Mistral의 벤치마크는 GLM-5.3과 비교하며 어느 GLM-5.3 변형인지 밝히지 않으므로 그 수치를 GLM-5.3-Flash에 그대로 적용하지 마세요. 자신의 작업 열 개를 각각에서 실행하고 토큰 수를 비교하세요; 같은 접근 방식이 GPT-6.1 Terra 가격이 작업당 어떻게 계산되는지에 있습니다.


