AI 입문가이드
AI 에이전트는 어떻게 동작하나: API 키 없이 실행하는 루프
AI 에이전트는 루프입니다. 모델이 도구를 요청하면 코드가 실행하고, 결과가 다시 돌아갑니다. 키 없이 Python 데모를 실행한 뒤 실제 모델에 연결해 보세요.
코딩 에이전트에게 오타 하나를 고쳐 달라고 했을 뿐인데 로그가 스크롤됩니다. 파일 읽기, 검색, 다른 파일 읽기, 편집, 테스트 실행. 작은 요청 하나에 모델 호출이 열 번 넘게 일어납니다. 이 호출들은 어디서 오는 걸까요?
AI 에이전트는 루프입니다. 프로그램이 대화를 모델에 보내면, 모델은 답하거나 도구를 요청합니다("이 파일을 읽어 줘"). 그러면 프로그램이 도구를 실행하고, 결과를 대화에 추가한 뒤 모델을 다시 호출합니다. 모델이 일반 텍스트로 답할 때까지 이 과정이 반복됩니다. Claude Code, Codex, Cursor의 에이전트 모드 같은 코딩 에이전트도 같은 루프를 중심으로 만들어졌으며, 도구가 더 많고 더 세심할 뿐입니다. 아래에서는 키 없이 40줄짜리 버전을 실행해 보고, 그다음 실제 모델에 연결해 보겠습니다.
한 장으로 보는 루프#
아무것도 직접 만질 수 없는 매니저를 떠올려 보세요. 매니저는 쪽지만 씁니다. "todo.txt를 가져다 주세요". 조수(여러분의 프로그램)가 선반으로 가서 파일을 가져다 책상 위에 놓습니다. 매니저는 그것을 읽고 다음 쪽지를 쓰거나 최종 답을 냅니다.
이게 전부입니다. 모델은 파일을 열지도, 명령을 실행하지도 않습니다. 어떤 도구를 어떤 인자로 호출할지만 텍스트로 씁니다. 여러분의 코드가 실제 작업을 하고 결과를 보고합니다. 함수 호출을 본 적이 있다면, 이것은 같은 메커니즘을 작업이 끝날 때까지 반복하는 것입니다.
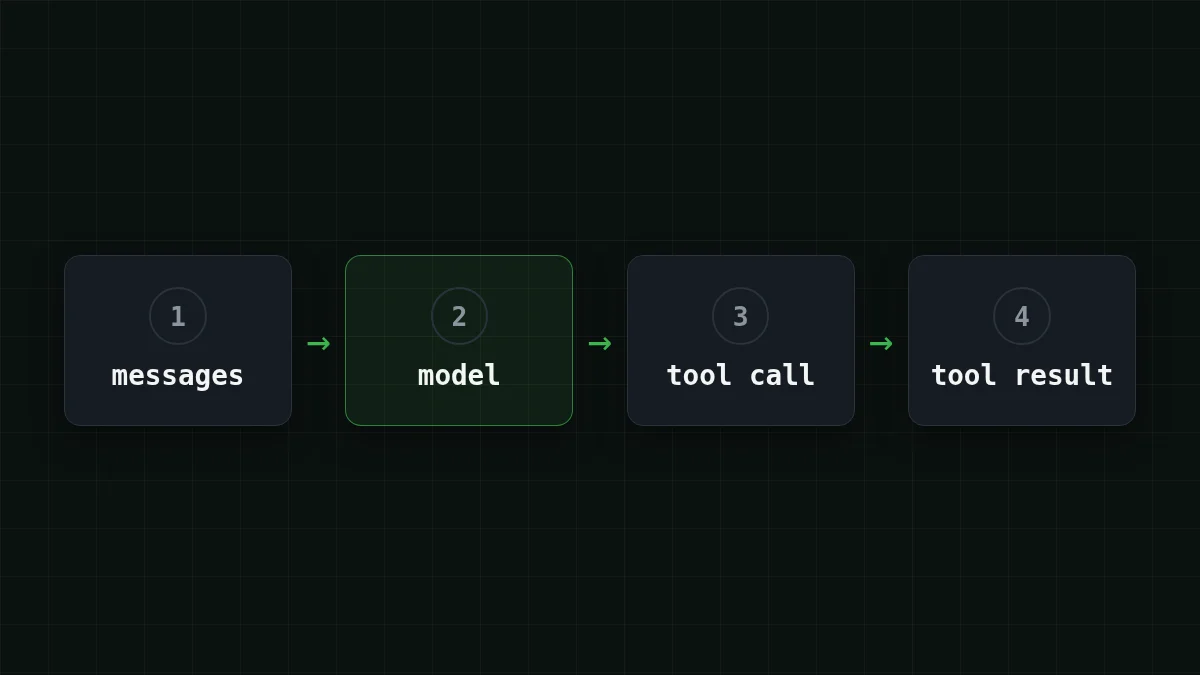
에이전트 루프의 한 바퀴를 올바른 순서로 맞출 수 있나요?
순서대로 배열하기
에이전트 루프의 한 바퀴를 순서대로 맞추기
항목을 드래그하거나 화살표를 사용하세요
- 작업과 도구 목록을 모델에 보낸다
- 모델이 텍스트가 아니라 도구 호출로 답한다
- 프로그램이 그 도구를 직접 실행한다
- 결과가 "tool" 메시지로 messages에 들어간다
- 결과와 함께 모델을 다시 호출하고, 일반 텍스트로 답할 때까지 반복한다
키 없이 실행하기#
작업이 "todo.txt에 항목이 몇 개 있나요?"라고 해 봅시다. 도구는 디스크 대신 작은 딕셔너리를 조회하는 read_file 함수입니다. 그리고 실제 모델 대신 항상 같은 두 가지를 하는 스크립트 모델이 있습니다. 파일을 요청하고, 답합니다. 이것만으로도 모든 구성 요소를 볼 수 있습니다. agent_loop.py로 저장하세요(Python 3.10+, 표준 라이브러리만 사용):
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
python agent_을 실행하세요. 환경에 LLM_API_KEY이 없으면 스크립트 모델이 나오고, 화면에는 정확히 두 바퀴가 표시됩니다:
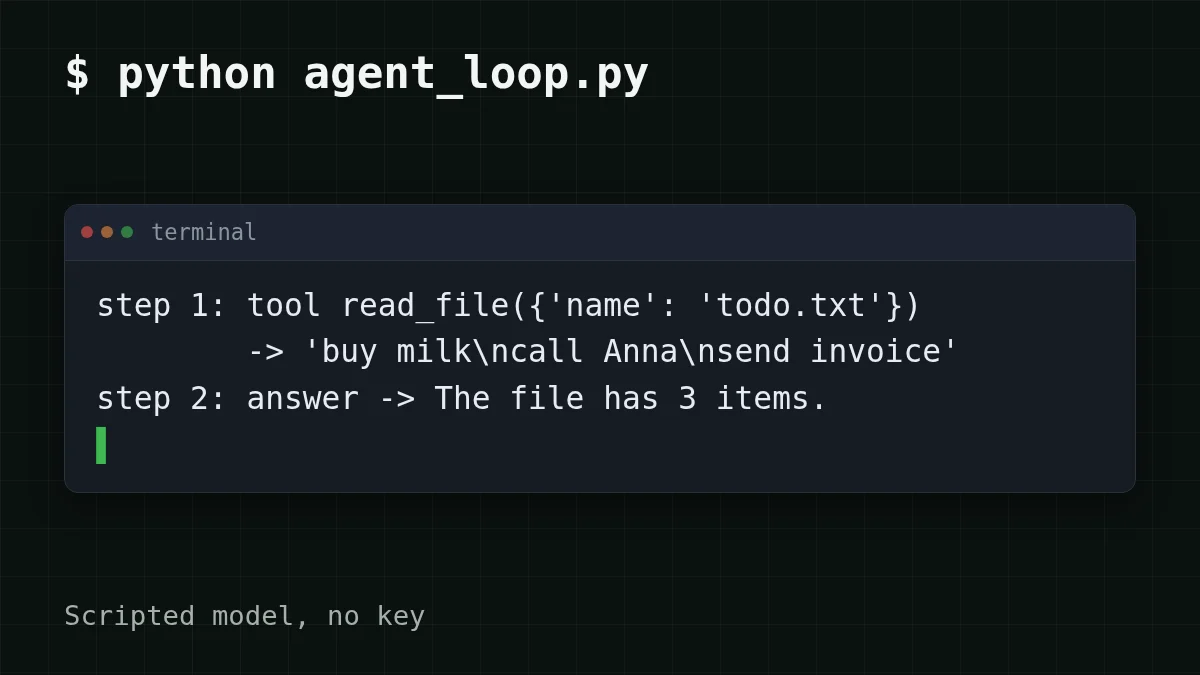
세 줄만 보세요. 전체 아이디어가 거기에 있습니다:
messages.은 모델 자신의 턴을 보존합니다. 이것을 빼면 다음 호출에 API가 본 적 없는 요청에 답하는 도구 결과가 들어가고, 대부분의 API는 이를 400으로 거부합니다.append(reply) arguments은 JSON 문자열로 오므로, 함수를 호출하기 전에json.loads를 거칩니다.max_steps은 비상 브레이크입니다. 모델은 영원히 도구를 요청할 수 있으므로, 모든 실제 에이전트에는 이런 제한이 있습니다.
같은 루프를 실제 모델에 연결하기#
바뀌는 것은 하나뿐입니다. 누가 모델 역할을 하느냐입니다. 스크립트는 세 개의 환경 변수를 읽고, 키가 있으면 같은 messages를 OpenAI 호환 엔드포인트로 보냅니다. CheapTokens 주소는 https:/이며(OpenAI Chat Completions 및 Anthropic Messages 호환), 모델 id는 문서에 있는 전체 id여야 합니다: deepseek-.
루프를 세 가지 방식으로 실행하기
키 없음
python agent_loop.py스크립트 모델이 두 바퀴를 모두 수행합니다. 어떤 것도 여러분의 컴퓨터를 떠나지 않습니다.
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
380K 컨텍스트 윈도우와 답변당 최대 32,768 출력 토큰: 긴 루프를 돌리기에 충분합니다.
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
다단계 루프를 처음 실행해 보기에 좋은 390K 컨텍스트 윈도우의 가벼운 모델입니다.
보게 될 것은 이전과 같은 모양입니다: step 1: tool read_, 그다음 step 2: answer -, 각 모델 호출 아래에 usage: 줄이 있습니다. 답의 문구는 스크립트 모델과 다를 수 있고, 말이 많은 모델은 한 바퀴를 더 돌 수도 있습니다. 정상입니다. 모델이 결정하고, 루프는 따를 뿐입니다. 키는 스크립트 자체에 넣지 마세요. 환경 변수가 안전한 곳입니다(저장 방법은 여기 있습니다).
usage: 줄이 유용한 부분입니다. 더 긴 실행의 in 숫자를 더해 보면 비용이 어디로 가는지 알 수 있습니다.
왜 매 바퀴가 이전보다 더 비싼가#
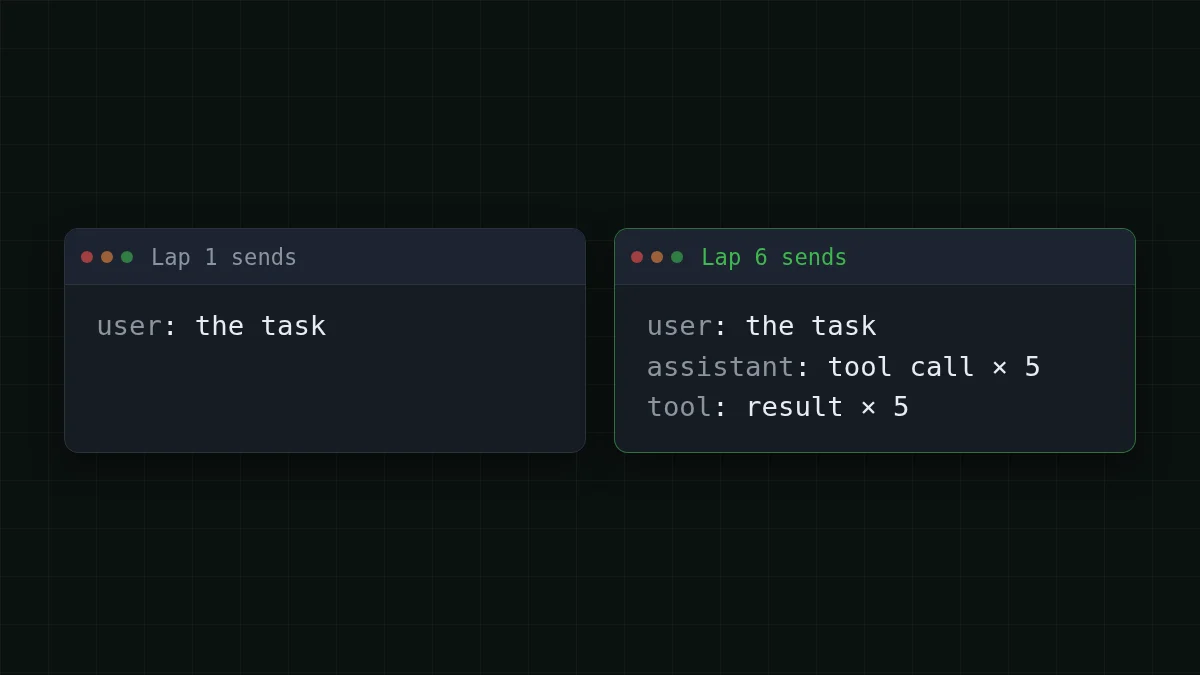
모델은 호출 사이에 아무것도 기억하지 않습니다. 매 바퀴는 전체 messages 목록을 다시 보냅니다: 작업, 이전의 모든 도구 호출, 모든 도구 결과. (같은 규칙 때문에 긴 채팅도 비싸집니다. 멀티턴 채팅은 일반 대화에서 이를 보여 줍니다.)
1바퀴는 메시지 하나를 보냅니다. 루프가 계속되면 6바퀴는 열하나를 보냅니다.
실제 작업이 10바퀴 걸린다고 해 봅시다. 약 2,000 토큰으로 시작하고(지시사항, 도구 목록, 요청), 매 바퀴 약 1,500 토큰이 추가되며(도구 결과와 모델의 메모), 모델은 바퀴당 약 300 토큰을 씁니다. 1바퀴는 2,000, 2바퀴는 3,500, 10바퀴는 15,500을 보냅니다. 첫 부분의 합은 10 × 2,000 = 20,000 토큰이고, 증가분은 1,500 × 45 = 67,500을 더합니다(45는 0+1+…+9). 따라서 작업 전체의 입력은 20,000 + 67,500 = 87,500 토큰입니다. 출력은 10 × 300 = 3,000 토큰입니다.
작업 텍스트 자체는 몇 문장에 불과하지만 입력 쪽은 87,500 토큰입니다. 1M 입력 토큰당 $0.015이라면, DeepSeek-V4-Flash에서 작업 전체는 $0.0016입니다. 참고로 OpenRouter를 포함해 모델별로 같은 부하를 계산하면 다음과 같습니다. 입력과 출력을 합친 총액에서 이 부하 기준으로 CheapTokens가 OpenRouter보다 저렴합니다:
| 모델 | 입력 $/1M | 출력 $/1M | 비용 | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
총 입력 87,500개 및 출력 3,000개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
시간대와 무관하게 하나의 가격인 것도 여기서 도움이 됩니다. 밤새 도는 에이전트도 정오에 도는 에이전트와 비용이 같으며, 모든 가격은 가격 페이지에서 볼 수 있습니다. 이런 작업을 하루치 돌린다면 슬라이더를 움직여 보세요:
비용 계산기
하루: 각 10바퀴인 작업 20개
요청당 입력 토큰: 8,750 · 요청당 출력 토큰: 300 · 일일 요청 수: 200
| 모델 | 일일 | 월간 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
필드는 모델 호출당입니다. 8,750은 위 예시에서 한 바퀴의 평균 입력(87,500 ÷ 10)이고, 200회 호출은 20개 작업 × 10바퀴입니다. 에이전트 청구서가 질문이 아니라 히스토리에 달려 있는 이유가 여기 있습니다. 20단계 예시는 같은 효과를 더 깊이 다룹니다.
빠른 확인
에이전트 루프의 3바퀴는 새로 물어본 것이 없는데도 1바퀴보다 비쌉니다. 왜일까요?
정답 보기
정답: messages 목록에 이제 두 개의 도구 호출과 두 개의 결과가 있고, 그것이 전부 다시 전송된다
API는 상태가 없습니다. 모든 호출이 전체 히스토리를 담으므로, 출력은 거의 그대로인데 입력 토큰은 바퀴마다 늘어납니다.
40줄에서 더 나아가기#
위 스크립트는 학습용 스케치입니다. 긴 버전을 원한다면 GitHub에 공개 강좌가 있습니다. justxor/agent-harness-course(README는 러시아어, 2026년 10월 31일 확인). 의존성 없는 순수 Python 3.10+이며, 코드는 MIT 라이선스, 텍스트는 CC BY 4.0입니다. 클론한 뒤 python examples/는 스크립트 모델로 오프라인에서 루프를 실행하고, python -는 네트워크 없이 19개의 테스트를 실행합니다. 강좌는 컨텍스트 압축, 메모리, 서브에이전트, 위험한 작업에 대한 사람 승인, 비용 추적 등으로 이어집니다. 실제 모델을 위해서는 LLM_PROVIDER, LLM_MODEL, LLM_API_KEY을 읽고, OpenAI 호환 엔드포인트의 경우 LLM_BASE_URL을 읽습니다. 정확한 LLM_PROVIDER 값은 README에서 가져오세요.
루프가 동작하면 다음 단계는 실제 키와 실제 작업입니다. 문서에는 1분 안에 할 수 있는 첫 요청이 있고, DeepSeek-V4-Flash는 루프를 돌리기에 좋은 모델입니다.


