একটি AI এজেন্ট কীভাবে কাজ করে: লুপ, কোনো API কী ছাড়াই চালান
একটি AI এজেন্ট একটি লুপ: মডেল একটি টুল চায়, আপনার কোড এটি চালায়, ফলাফল ফিরে যায়। একটি কী-মুক্ত Python ডেমো চালান, তারপর এটি একটি বাস্তব মডেলের দিকে নির্দেশ করুন।
এই পৃষ্ঠায়
আপনি একটি কোডিং এজেন্টকে একটি টাইপো ঠিক করতে বললেন এবং লগ স্ক্রল হতে দেখলেন: একটি ফাইল পড়ুন, অনুসন্ধান করুন, আরেকটি ফাইল পড়ুন, সম্পাদনা করুন, পরীক্ষাগুলি চালান। একটি ছোট অনুরোধ, ডজনখানেক মডেল কল। এগুলি কোথা থেকে আসে?
একটি AI এজেন্ট একটি লুপ। আপনার প্রোগ্রাম কথোপকথনটি মডেলে পাঠায়; মডেল হয় উত্তর দেয় অথবা একটি টুল চায় ("এই ফাইলটি পড়ুন"); আপনার প্রোগ্রাম টুলটি চালায়, ফলাফলটি কথোপকথনে যোগ করে এবং আবার মডেলকে কল করে। মডেল প্লেইন টেক্সটে উত্তর না দেওয়া পর্যন্ত এটি পুনরাবৃত্তি করে। Claude Code, Codex এবং Cursor-এর এজেন্ট মোডের মতো কোডিং এজেন্টগুলি এই একই লুপের চারপাশে তৈরি, আরও টুল এবং আরও যত্ন সহ। নিচে আপনি কোনো কী ছাড়াই একটি 40-লাইনের সংস্করণ চালাবেন, তারপর এটি একটি বাস্তব মডেলের দিকে নির্দেশ করবেন।
এক ছবিতে লুপ#
এমন একজন ম্যানেজারের কথা ভাবুন যিনি কিছুই স্পর্শ করতে পারেন না। ম্যানেজার শুধু নোট লেখেন: "অনুগ্রহ করে আমার কাছে todo.txt আনুন"। একজন সহকারী (আপনার প্রোগ্রাম) তাকে shelf-এ যায়, ফাইলটি আনে এবং ডেস্কে রাখে। ম্যানেজার এটি পড়েন এবং পরবর্তী নোট বা চূড়ান্ত উত্তর লেখেন।
এটাই পুরো কৌশল। মডেল কখনো ফাইল খোলে না বা কমান্ড চালায় না। এটি টেক্সট লেখে যা বলে কোন টুল কল করতে হবে এবং কোন আর্গুমেন্ট দিয়ে। আপনার কোড কাজটি করে এবং রিপোর্ট করে। আপনি যদি function calling দেখে থাকেন, এটি একই প্রক্রিয়া, কাজ শেষ না হওয়া পর্যন্ত পুনরাবৃত্তি করা হয়।
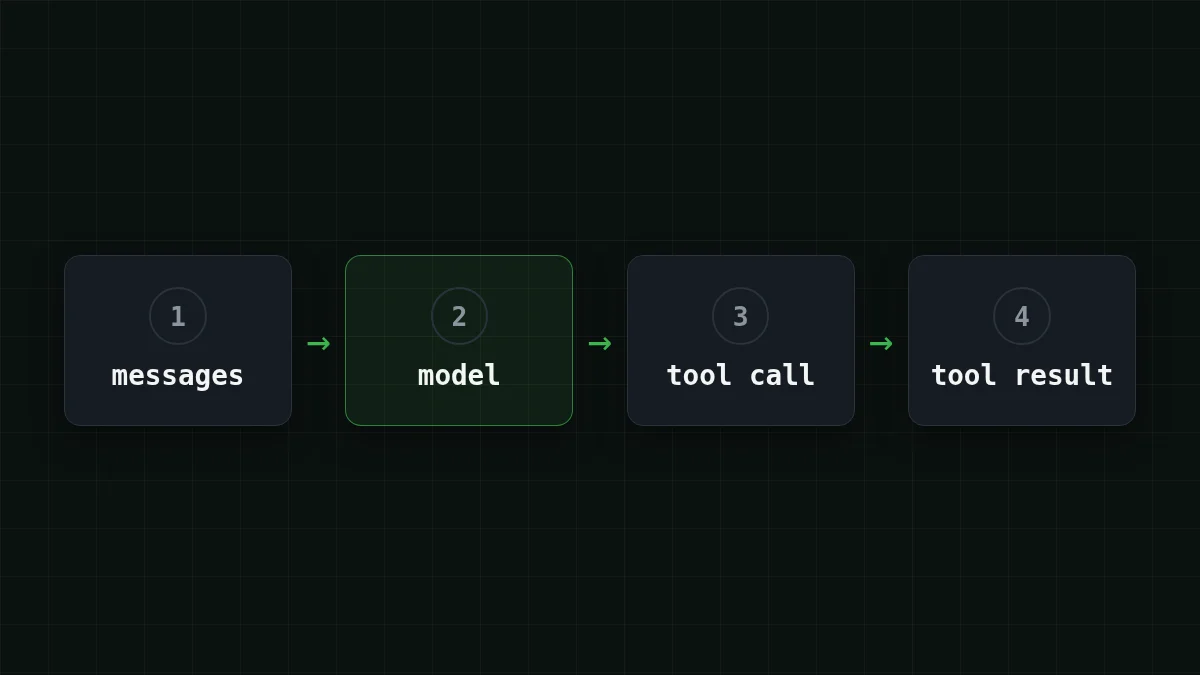
আপনি কি লুপের একটি ল্যাপ সঠিক ক্রমে রাখতে পারেন?
ক্রমে সাজান
এজেন্ট লুপের একটি ল্যাপ ক্রমানুসারে রাখুন
আইটেমগুলো ড্র্যাগ করুন বা তীর ব্যবহার করুন
- কাজ এবং টুল তালিকা মডেলে পাঠান
- মডেল একটি টুল কল দিয়ে উত্তর দেয়, টেক্সট নয়
- আপনার প্রোগ্রাম নিজেই সেই টুলটি চালায়
- ফলাফলটি একটি "tool" বার্তা হিসাবে বার্তাগুলিতে যায়
- ফলাফল সহ আবার মডেলকে কল করা হয়, যতক্ষণ না এটি প্লেইন টেক্সটে উত্তর দেয়
কোনো কী ছাড়াই এটি চালান#
ধরুন কাজটি হল: "todo.txt-এ কতগুলি আইটেম আছে?"। টুলটি একটি ফাংশন read_file যা ডিস্কের পরিবর্তে একটি ছোট অভিধানে খোঁজে। এবং একটি বাস্তব মডেলের পরিবর্তে একটি স্ক্রিপ্টেড মডেল রয়েছে যা সর্বদা একই দুটি কাজ করে: ফাইলটি চায়, তারপর উত্তর দেয়। প্রতিটি চলমান অংশ দেখতে এটি যথেষ্ট। এটি agent_loop.py হিসাবে সংরক্ষণ করুন (Python 3.10+, শুধুমাত্র স্ট্যান্ডার্ড লাইব্রেরি):
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
python agent_ চালান। আপনার পরিবেশে LLM_API_KEY না থাকলে আপনি স্ক্রিপ্টেড মডেল পাবেন, এবং স্ক্রিনে ঠিক দুটি ল্যাপ দেখাবে:
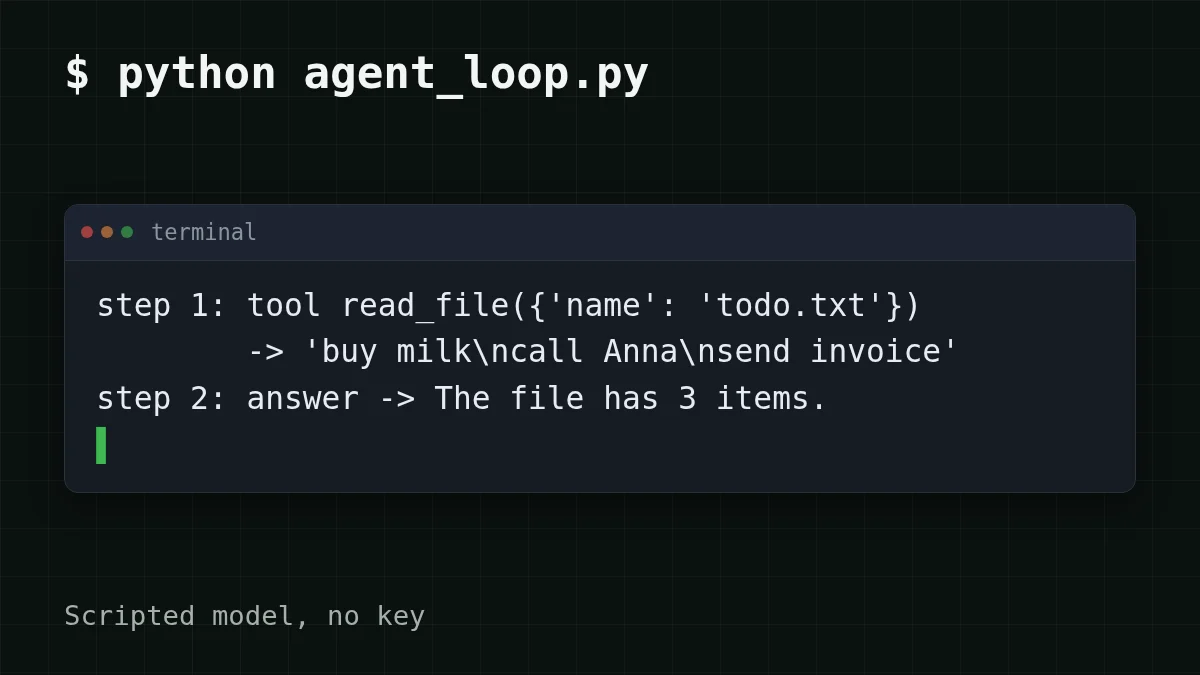
তিনটি লাইন দেখুন, কারণ সেগুলিতে পুরো ধারণাটি রয়েছে:
messages.মডেলের নিজের টার্ন রাখে। এটি বাদ দিন, এবং পরবর্তী কলে একটি টুল ফলাফল থাকে যা এমন একটি অনুরোধের উত্তর দেয় যা API কখনো দেখেনি; বেশিরভাগ API এটি 400 দিয়ে প্রত্যাখ্যান করে।append(reply) argumentsএকটি JSON স্ট্রিং হিসাবে আসে, তাই ফাংশনটি কল করার আগে এটিjson.loadsএর মধ্য দিয়ে যায়।max_stepsহল জরুরি ব্রেক। একটি মডেল চিরকাল টুল চাইতে পারে, তাই প্রতিটি বাস্তব এজেন্টের এই ধরনের একটি সীমা থাকে।
একই লুপকে একটি বাস্তব মডেলের দিকে নির্দেশ করুন#
শুধু একটি জিনিস পরিবর্তন হয়: কে মডেলের ভূমিকা পালন করে। স্ক্রিপ্টটি তিনটি পরিবেশ ভেরিয়েবল পড়ে, এবং যদি একটি কী উপস্থিত থাকে তবে এটি একই messages একটি OpenAI-সামঞ্জস্যপূর্ণ এন্ডপয়েন্টে পাঠায়। CheapTokens ঠিকানা হল https:/ (OpenAI Chat Completions এবং Anthropic Messages সামঞ্জস্যপূর্ণ), এবং মডেল আইডি অবশ্যই ডক্স থেকে সম্পূর্ণ হতে হবে: deepseek-।
লুপটি তিনভাবে চালান
কোনো কী নেই
python agent_loop.pyস্ক্রিপ্টেড মডেল উভয় ল্যাপ খেলে। আপনার মেশিন থেকে কিছুই বের হয় না।
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
একটি 380K কনটেক্সট উইন্ডো এবং প্রতি উত্তরে 32,768 আউটপুট টোকেন পর্যন্ত: একটি দীর্ঘ লুপের জন্য জায়গা।
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
একটি মাল্টি-স্টেপ লুপের প্রথম রানের জন্য 390K কনটেক্সট উইন্ডো সহ একটি হালকা মডেল।
আপনার যা দেখা উচিত তা আগের মতোই একই আকার: step 1: tool read_, তারপর step 2: answer -, প্রতিটি মডেল কলের নিচে একটি usage: লাইন সহ। উত্তরের শব্দচয়ন স্ক্রিপ্টেড থেকে আলাদা হবে, এবং একটি কথাবহুল মডেল একটি অতিরিক্ত ল্যাপ নিতে পারে। এটি স্বাভাবিক: মডেল সিদ্ধান্ত নেয়, লুপ শুধু মেনে চলে। কীটি স্ক্রিপ্টের ভিতরে রাখবেন না; একটি পরিবেশ ভেরিয়েবল নিরাপদ জায়গা (এখানে এটি কীভাবে সংরক্ষণ করবেন)।
usage: লাইনগুলি হল দরকারী অংশ। একটি দীর্ঘ রানের in সংখ্যাগুলি যোগ করুন এবং আপনি দেখতে পাবেন টাকা কোথায় যায়।
কেন প্রতিটি ল্যাপ আগেরটির চেয়ে বেশি খরচ করে#
মডেল কলের মধ্যে কিছুই মনে রাখে না। প্রতিটি ল্যাপ সম্পূর্ণ messages তালিকা আবার পাঠায়: কাজ, প্রতিটি পূর্ববর্তী টুল কল, প্রতিটি টুল ফলাফল। (একই নিয়ম একটি দীর্ঘ চ্যাট ব্যয়বহুল করে তোলে; multi-turn chat একটি সাধারণ কথোপকথনে এটি দেখায়।)
ল্যাপ 1 একটি বার্তা পাঠায়। যদি লুপ চলতে থাকে, ল্যাপ 6 এগারোটি পাঠায়।
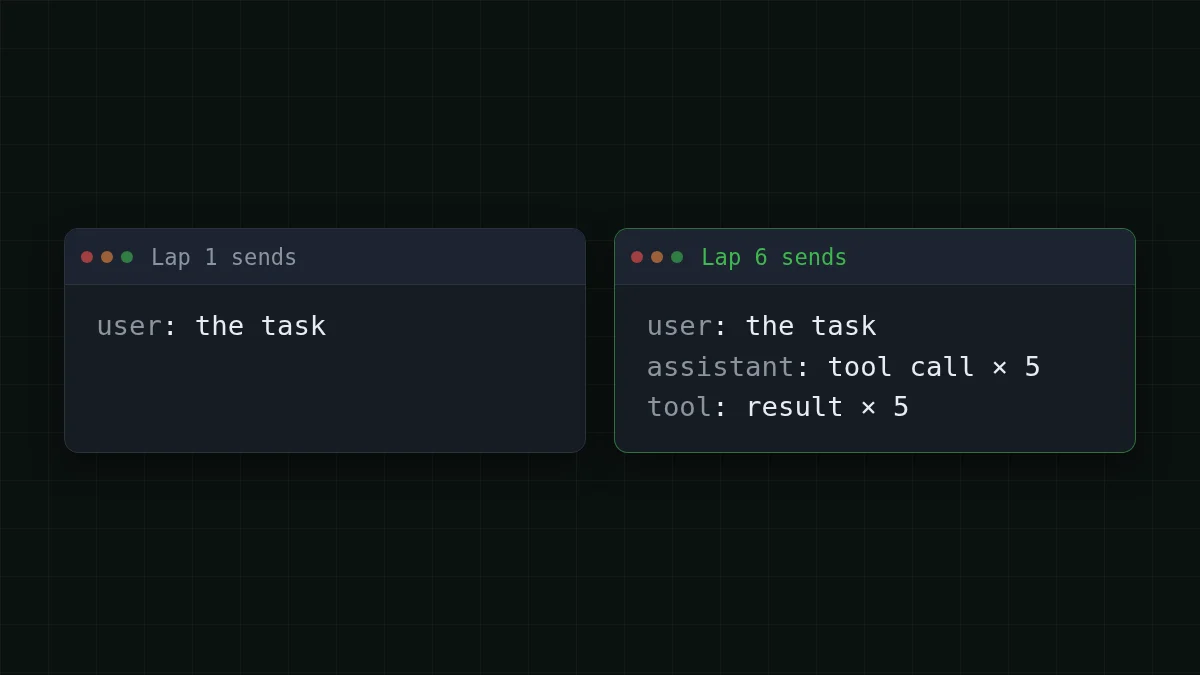
ধরুন একটি বাস্তব কাজ 10 ল্যাপ নেয়। এটি প্রায় 2,000 টোকেন দিয়ে শুরু হয় (নির্দেশাবলী, টুল তালিকা, আপনার অনুরোধ), প্রতিটি ল্যাপ প্রায় 1,500 যোগ করে (একটি টুল ফলাফল প্লাস মডেলের নোট), এবং মডেল প্রতি ল্যাপে প্রায় 300 টোকেন লেখে। ল্যাপ 1 পাঠায় 2,000, ল্যাপ 2 পাঠায় 3,500, ল্যাপ 10 পাঠায় 15,500। প্রথম অংশের যোগফল হল 10 × 2,000 = 20,000 টোকেন; বৃদ্ধি যোগ করে 1,500 × 45 = 67,500 (45 হল 0+1+…+9), তাই কাজের উপর ইনপুট হল 20,000 + 67,500 = 87,500 টোকেন। আউটপুট হল 10 × 300 = 3,000 টোকেন।
কাজের টেক্সট নিজেই কয়েকটি বাক্য, তবুও ইনপুট দিকটি 87,500 টোকেন। প্রতি 1M ইনপুট টোকেনে $0.015 হারে, DeepSeek-V4-Flash-এ পুরো কাজটি $0.0016 হয়। এখানে OpenRouter রেফারেন্স হিসাবে একই লোড মডেল জুড়ে। মোট, ইনপুট এবং আউটপুট একসাথে গণনা করলে, এই লোডে CheapTokens OpenRouter-এর চেয়ে সস্তা হয়:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | খরচ | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
মোট ৮৭,৫০০ ইনপুট এবং ৩,০০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
দিনের যেকোনো সময় একই দাম এখানেও সাহায্য করে: রাতভর চলা একটি এজেন্টের খরচ দুপুরের একটির মতোই, এবং আপনি প্রাইসিং পেজে সমস্ত দাম দেখতে পারেন। এই ধরনের কাজের একদিনের জন্য, স্লাইডারগুলি সরান:
খরচ ক্যালকুলেটর
একদিন: প্রতিটি 10 ল্যাপের 20টি কাজ
প্রতি অনুরোধে ইনপুট টোকেন: ৮,৭৫০ · প্রতি অনুরোধে আউটপুট টোকেন: ৩০০ · প্রতিদিন অনুরোধ: ২০০
| মডেল | প্রতিদিন | প্রতি মাসে |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
ক্ষেত্রগুলি প্রতি মডেল কলে: 8,750 হল উপরের উদাহরণ থেকে একটি ল্যাপের গড় ইনপুট (87,500 ÷ 10), এবং 200 কল হল 20 কাজ × 10 ল্যাপ। এই কারণেই এজেন্ট বিল ইতিহাস সম্পর্কে, প্রশ্ন সম্পর্কে নয়। 20-ধাপের উদাহরণ একই প্রভাবের গভীরে যায়।
দ্রুত যাচাই
এজেন্ট লুপের ল্যাপ 3 ল্যাপ 1-এর চেয়ে বেশি খরচ করে, যদিও আপনি নতুন কিছু জিজ্ঞাসা করেননি। কেন?
উত্তর দেখান
উত্তর: বার্তা তালিকায় এখন দুটি টুল কল এবং দুটি ফলাফল রয়েছে, এবং এর সবকিছু আবার পাঠানো হয়
API স্টেটলেস। প্রতিটি কলে সম্পূর্ণ ইতিহাস বহন করে, তাই প্রতিটি ল্যাপের সাথে ইনপুট টোকেন বাড়ে যখন আউটপুট প্রায় একই থাকে।
40 লাইন থেকে কোথায় যাবেন#
উপরের স্ক্রিপ্টটি শেখার জন্য একটি স্কেচ। আপনি যদি দীর্ঘ সংস্করণ চান, GitHub-এ একটি ওপেন কোর্স রয়েছে, justxor/agent-harness-course (README রাশিয়ান ভাষায়, 31 অক্টোবর 2026-এ পরীক্ষিত)। এটি সাধারণ Python 3.10+ কোনো নির্ভরতা ছাড়াই, কোডটি MIT-লাইসেন্সপ্রাপ্ত, টেক্সটটি CC BY 4.0। ক্লোন করার পরে, python examples/ একটি স্ক্রিপ্টেড মডেল দিয়ে অফলাইনে লুপ চালায়, এবং python - নেটওয়ার্ক ছাড়াই এর 19টি পরীক্ষা চালায়। কোর্সটি কনটেক্সট কম্প্যাকশন, মেমরি, সাবএজেন্ট, ঝুঁকিপূর্ণ কাজের মানব অনুমোদন এবং খরচ ট্র্যাকিং দিয়ে চলতে থাকে। একটি বাস্তব মডেলের জন্য এটি LLM_PROVIDER, LLM_MODEL, LLM_API_KEY এবং OpenAI-সামঞ্জস্যপূর্ণ এন্ডপয়েন্টের জন্য LLM_BASE_URL পড়ে: এর README থেকে সঠিক LLM_PROVIDER মান নিন।
লুপ কাজ করলে, পরবর্তী ধাপ হল একটি বাস্তব কী এবং একটি বাস্তব কাজ: ডক্স এক মিনিটে একটি প্রথম অনুরোধ আছে, এবং DeepSeek-V4-Flash লুপ চালানোর জন্য একটি ভাল মডেল।


