AI สำหรับผู้เริ่มต้นคู่มือ
AI agent ทำงานอย่างไร: ลูป รันโดยไม่ใช้ API key
AI agent คือลูป: โมเดลขอใช้เครื่องมือ โค้ดของคุณรันมัน ผลลัพธ์กลับไป รันเดโม Python ที่ไม่ใช้คีย์ แล้วชี้ไปที่โมเดลจริง
ในหน้านี้
คุณขอให้ coding agent แก้ไขคำผิดคำเดียว แล้วดู log เลื่อน: อ่านไฟล์, ค้นหา, อ่านไฟล์อื่น, แก้ไข, รันเทสต์ คำขอเล็กๆ ครั้งเดียว เรียกโมเดลเป็นสิบครั้ง สิ่งเหล่านี้มาจากไหน?
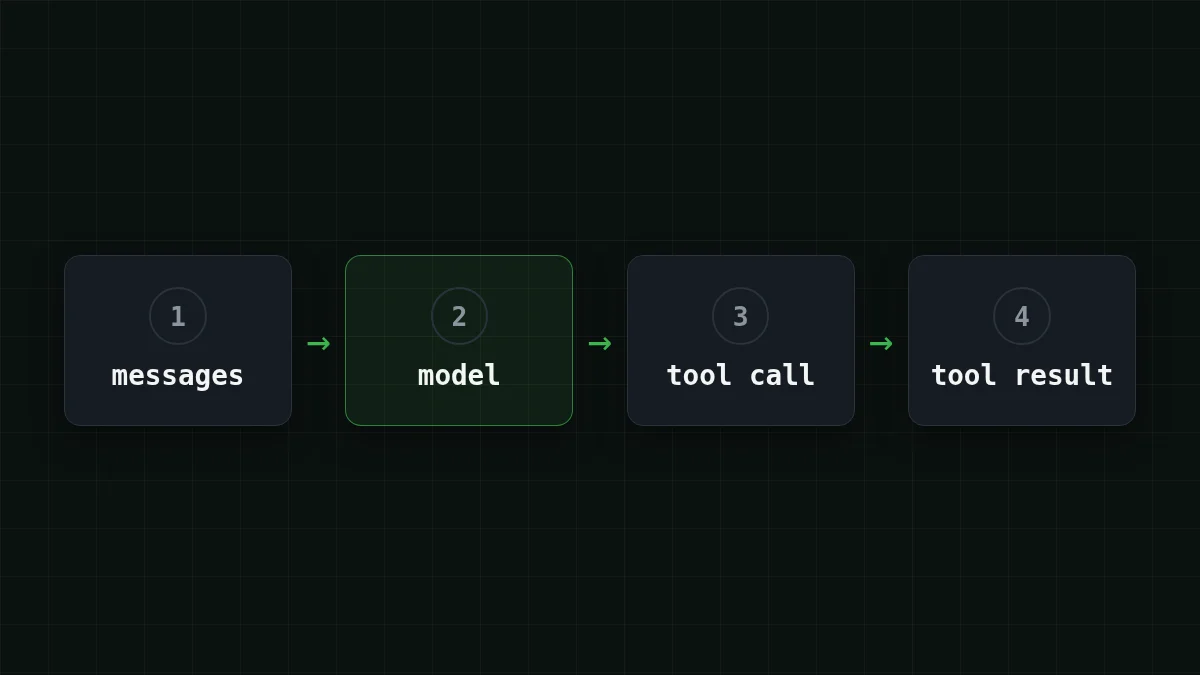
AI agent คือลูป โปรแกรมของคุณส่งบทสนทนาไปยังโมเดล; โมเดลตอบกลับหรือขอใช้เครื่องมือ ("อ่านไฟล์นี้"); โปรแกรมของคุณรันเครื่องมือนั้น เพิ่มผลลัพธ์ลงในบทสนทนา แล้วเรียกโมเดลอีกครั้ง ทำซ้ำจนกว่าโมเดลจะตอบเป็นข้อความธรรมดา Coding agent อย่าง Claude Code, Codex และโหมด agent ของ Cursor สร้างขึ้นรอบลูปเดียวกันนี้ แต่มีเครื่องมือมากกว่าและระมัดระวังมากกว่า ด้านล่างคุณจะได้รันเวอร์ชัน 40 บรรทัดโดยไม่ใช้คีย์เลย จากนั้นชี้ไปที่โมเดลจริง
ลูปในภาพเดียว#
ลองนึกถึงผู้จัดการที่ไม่สามารถแตะต้องอะไรได้ ผู้จัดการเขียนโน้ตเท่านั้น: "ช่วยเอา todo.txt มาให้หน่อย" ผู้ช่วย (โปรแกรมของคุณ) ไปที่ชั้น หยิบไฟล์มาแล้ววางบนโต๊ะ ผู้จัดการอ่านแล้วเขียนโน้ตถัดไป หรือคำตอบสุดท้าย
นั่นคือกลเม็ดทั้งหมด โมเดลไม่เคยเปิดไฟล์หรือรันคำสั่ง มันเขียนข้อความที่บอกว่า เครื่องมือไหน ที่จะเรียกและด้วย อาร์กิวเมนต์อะไร โค้ดของคุณทำงานและรายงานกลับ หากคุณเคยเห็น function calling นี่คือกลไกเดียวกัน ทำซ้ำจนงานเสร็จ
คุณเรียงหนึ่งรอบของลูปให้ถูกต้องได้ไหม?
เรียงลำดับ
เรียงหนึ่งรอบของลูป agent ตามลำดับ
ลากรายการหรือใช้ลูกศร
- ส่งงานและรายการเครื่องมือไปยังโมเดล
- โมเดลตอบกลับด้วยการเรียกเครื่องมือ ไม่ใช่ข้อความ
- โปรแกรมของคุณรันเครื่องมือนั้นเอง
- ผลลัพธ์ไปอยู่ในข้อความในฐานะข้อความ "tool"
- เรียกโมเดลอีกครั้งพร้อมผลลัพธ์ จนกว่าจะตอบเป็นข้อความธรรมดา
รันโดยไม่ใช้คีย์#
สมมติงานคือ: "todo.txt มีกี่รายการ?". เครื่องมือคือฟังก์ชัน read_file ที่ค้นหาในดิกชันนารีเล็กๆ แทนดิสก์ และแทนที่จะเป็นโมเดลจริง มีโมเดลแบบสคริปต์ที่ทำสองสิ่งเดิมเสมอ: ขอไฟล์ แล้วตอบ นั่นเพียงพอที่จะเห็นทุกชิ้นส่วนที่เคลื่อนไหว บันทึกเป็น agent_loop.py (Python 3.10+, ไลบรารีมาตรฐานเท่านั้น):
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
รัน python agent_ หากไม่มี LLM_API_KEY ใน environment ของคุณ คุณจะได้โมเดลแบบสคริปต์ และหน้าจอแสดงสองรอบพอดี:
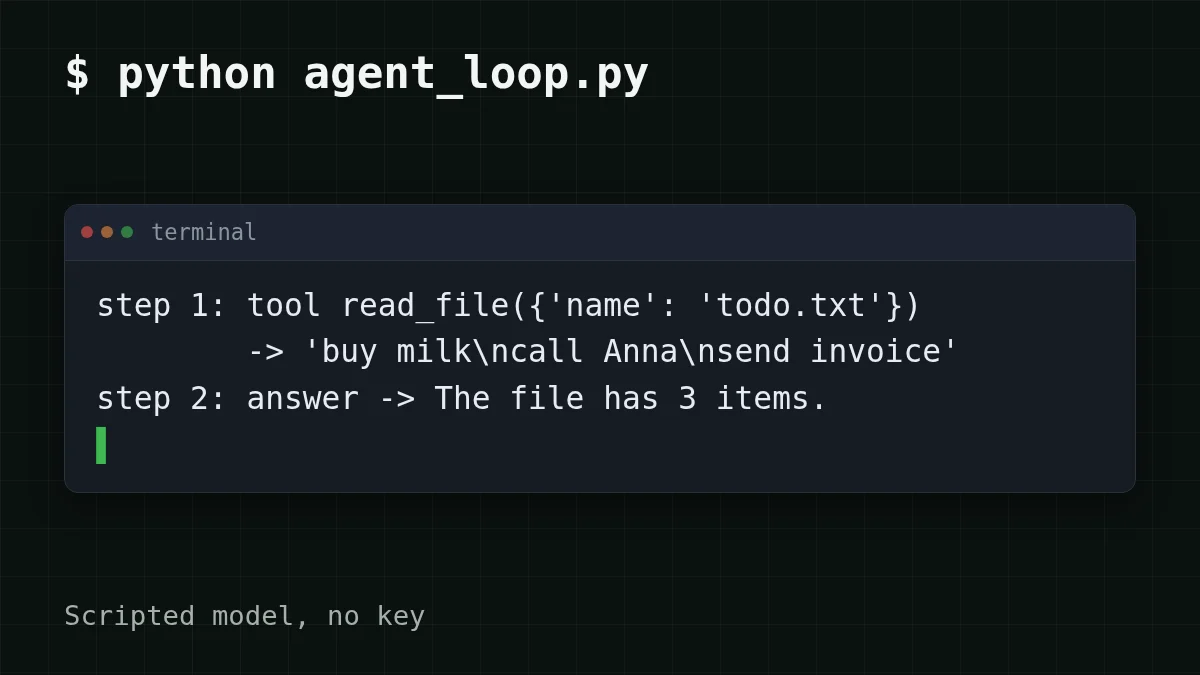
ดูสามบรรทัด เพราะมันเก็บแนวคิดทั้งหมด:
messages.เก็บเทิร์นของโมเดลเอง หากข้ามไป การเรียกครั้งถัดไปจะมีผลลัพธ์เครื่องมือที่ตอบคำขอที่ API ไม่เคยเห็น; API ส่วนใหญ่จะปฏิเสธด้วย 400append(reply) argumentsมาเป็น สตริง JSON ดังนั้นมันจึงผ่านjson.loadsก่อนที่คุณจะเรียกฟังก์ชันmax_stepsคือเบรกฉุกเฉิน โมเดลสามารถขอเครื่องมือไปเรื่อยๆ ได้ ดังนั้น agent จริงทุกตัวจึงมีขีดจำกัดแบบนี้
ชี้ลูปเดียวกันไปที่โมเดลจริง#
มีเพียงสิ่งเดียวที่เปลี่ยน: ใครรับบทเป็นโมเดล สคริปต์อ่าน environment variable สามตัว และหากมีคีย์อยู่ มันจะส่ง messages เดียวกันไปยัง endpoint ที่เข้ากันได้กับ OpenAI ที่อยู่ CheapTokens คือ https:/ (เข้ากันได้กับ OpenAI Chat Completions และ Anthropic Messages) และ model id ต้องเป็นตัวเต็มจาก docs: deepseek-
รันลูปสามวิธี
ไม่ใช้คีย์
python agent_loop.pyโมเดลแบบสคริปต์เล่นทั้งสองรอบ ไม่มีอะไรออกจากเครื่องของคุณ
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
หน้าต่าง context 380K และเอาต์พุตสูงสุด 32,768 โทเค็นต่อคำตอบ: ที่ว่างสำหรับลูปยาว
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
โมเดลเบาที่มีหน้าต่าง context 390K สำหรับการรันลูปหลายขั้นตอนครั้งแรก
สิ่งที่คุณควรเห็นคือรูปร่างเดิม: step 1: tool read_, แล้ว step 2: answer -, โดยมีบรรทัด usage: ใต้การเรียกโมเดลแต่ละครั้ง ถ้อยคำของคำตอบจะต่างจากแบบสคริปต์ และโมเดลที่ช่างพูดอาจใช้รอบเพิ่ม นั่นเป็นเรื่องปกติ: โมเดลตัดสินใจ ลูปแค่ทำตาม เก็บคีย์ออกจากสคริปต์เอง; environment variable คือที่ปลอดภัย (นี่คือ วิธีเก็บมัน)
บรรทัด usage: คือส่วนที่มีประโยชน์ เพิ่มตัวเลข in ของการรันที่ยาวขึ้น แล้วคุณจะเห็นว่าเงินไปไหน
ทำไมแต่ละรอบจึงแพงกว่ารอบก่อน#
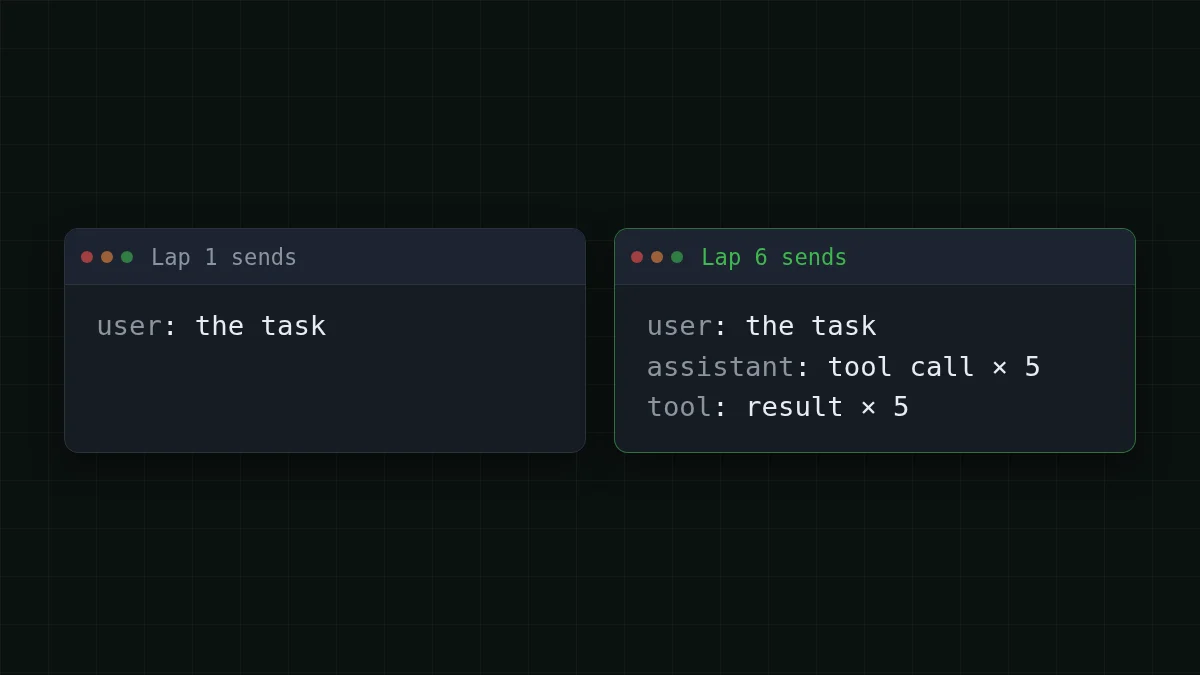
โมเดลไม่จำอะไรระหว่างการเรียก แต่ละรอบส่งรายการ messages ทั้งหมด อีกครั้ง: งาน, การเรียกเครื่องมือก่อนหน้าทุกครั้ง, ผลลัพธ์เครื่องมือทุกครั้ง (กฎเดียวกันทำให้แชทยาวแพง; multi-turn chat แสดงให้เห็นในบทสนทนาธรรมดา)
รอบ 1 ส่งหนึ่งข้อความ หากลูปดำเนินต่อไป รอบ 6 ส่งสิบเอ็ด
สมมติงานจริงใช้ 10 รอบ เริ่มด้วยประมาณ 2,000 โทเค็น (คำสั่ง, รายการเครื่องมือ, คำขอของคุณ) แต่ละรอบเพิ่มประมาณ 1,500 (ผลลัพธ์เครื่องมือบวกโน้ตของโมเดล) และโมเดลเขียนประมาณ 300 โทเค็นต่อรอบ รอบ 1 ส่ง 2,000, รอบ 2 ส่ง 3,500, รอบ 10 ส่ง 15,500 ผลรวมของส่วนแรกคือ 10 × 2,000 = 20,000 โทเค็น; การเติบโตเพิ่ม 1,500 × 45 = 67,500 (45 คือ 0+1+…+9) ดังนั้นอินพุตตลอดงานคือ 20,000 + 67,500 = 87,500 โทเค็น เอาต์พุตคือ 10 × 300 = 3,000 โทเค็น
ข้อความงานเองมีไม่กี่ประโยค แต่ฝั่งอินพุตคือ 87,500 โทเค็น ที่ $0.015 ต่อ 1M อินพุตโทเค็น งานทั้งหมดบน DeepSeek-V4-Flash รวมเป็น $0.0016 นี่คือโหลดเดียวกันข้ามโมเดล โดยมี OpenRouter เป็นข้อมูลอ้างอิง โดยรวม เมื่อนับอินพุตและเอาต์พุตรวมกัน CheapTokens ออกมา cheaper กว่า OpenRouter บนโหลดนี้:
| โมเดล | Input $/1M | Output $/1M | ค่าใช้จ่าย | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
87,500 โทเค็นอินพุตและ 3,000 โทเค็นเอาต์พุตรวมทั้งหมด ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
ราคาเดียวตลอดเวลาก็ช่วยได้เช่นกัน: agent ที่รันข้ามคืนมีค่าใช้จ่ายเท่ากับตอนเที่ยง และคุณสามารถดูราคาทั้งหมดได้ที่ หน้าค่าบริการ สำหรับหนึ่งวันของงานแบบนี้ เลื่อนสไลเดอร์:
เครื่องคำนวณค่าใช้จ่าย
หนึ่งวัน: 20 งาน งานละ 10 รอบ
โทเค็นอินพุตต่อคำขอ: 8,750 · โทเค็นเอาต์พุตต่อคำขอ: 300 · คำขอต่อวัน: 200
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
ฟิลด์เหล่านี้ต่อการเรียกโมเดล: 8,750 คืออินพุตเฉลี่ยของหนึ่งรอบจากตัวอย่างข้างต้น (87,500 ÷ 10) และ 200 การเรียกคือ 20 งาน × 10 รอบ นี่คือเหตุผลที่บิลของ agent เกี่ยวกับ ประวัติ ไม่ใช่คำถาม ตัวอย่าง 20 ขั้นตอน เจาะลึกผลกระทบเดียวกัน
เช็กด่วน
รอบ 3 ของลูป agent แพงกว่ารอบ 1 แม้ว่าคุณไม่ได้ถามอะไรใหม่ ทำไม?
แสดงคำตอบ
คำตอบ: รายการข้อความตอนนี้มีการเรียกเครื่องมือสองครั้งและผลลัพธ์สองรายการ และทั้งหมดถูกส่งอีกครั้ง
API ไม่มีสถานะ ทุกการเรียกพาประวัติเต็มไปด้วย ดังนั้นอินพุตโทเค็นจึงโตขึ้นในแต่ละรอบ enquanto เอาต์พุตยังคงประมาณเดิม
ไปจาก 40 บรรทัด#
สคริปต์ข้างต้นเป็นแบบร่างเพื่อการเรียนรู้ หากคุณต้องการเวอร์ชันยาว มีคอร์สเปิดบน GitHub, justxor/agent-harness-course (README เป็นภาษารัสเซีย ตรวจสอบเมื่อ 31 ตุลาคม 2026) เป็น Python 3.10+ ธรรมดาไม่มี dependencies โค้ดอยู่ภายใต้ MIT license ข้อความอยู่ภายใต้ CC BY 4.0 หลังจากโคลน python examples/ รันลูปแบบออฟไลน์ด้วยโมเดลแบบสคริปต์ และ python - รันเทสต์ 19 ตัวโดยไม่ใช้เครือข่าย คอร์สดำเนินต่อไปด้วยการบีบอัด context, หน่วยความจำ, subagent, การอนุมัติจากมนุษย์สำหรับการกระทำที่มีความเสี่ยง และการติดตามค่าใช้จ่าย สำหรับโมเดลจริง มันอ่าน LLM_PROVIDER, LLM_MODEL, LLM_API_KEY และสำหรับ endpoint ที่เข้ากันได้กับ OpenAI, LLM_BASE_URL: ใช้ค่า LLM_PROVIDER ที่แน่นอนจาก README ของมัน
เมื่อลูปทำงาน ขั้นตอนถัดไปคือคีย์จริงและงานจริง: docs มีคำขอแรกในหนึ่งนาที และ DeepSeek-V4-Flash เป็นโมเดลที่ดีในการรันลูป


