نئے سیکھنے والوں کے لیے AIگائیڈ
AI ایجنٹ کیسے کام کرتا ہے: لوپ، بغیر API کی کے چلائیں
ایک AI ایجنٹ ایک لوپ ہے: ماڈل ٹول مانگتا ہے، آپ کا کوڈ اسے چلاتا ہے، نتیجہ واپس جاتا ہے۔ بغیر کی والا Python ڈیمو چلائیں، پھر اسے حقیقی ماڈل کی طرف اشارہ کریں۔
اس صفحہ پر
آپ ایک کوڈنگ ایجنٹ سے کہتے ہیں کہ ایک ٹائپو ٹھیک کرے اور لاگ اسکرول ہوتا دیکھتے ہیں: ایک فائل پڑھو، تلاش کرو، دوسری فائل پڑھو، ترمیم کرو، ٹیسٹ چلاؤ۔ ایک چھوٹی سی درخواست، درجن بھر ماڈل کالز۔ یہ کہاں سے آتی ہیں؟
ایک AI ایجنٹ ایک لوپ ہے۔ آپ کا پروگرام گفتگو ماڈل کو بھیجتا ہے؛ ماڈل یا تو جواب دیتا ہے یا کسی ٹول کا مطالبہ کرتا ہے ("یہ فائل پڑھو")؛ آپ کا پروگرام ٹول چلاتا ہے، نتیجہ گفتگو میں شامل کرتا ہے اور ماڈل کو دوبارہ کال کرتا ہے۔ یہ اس وقت تک دہرایا جاتا ہے جب تک ماڈل سادہ متن میں جواب نہ دے۔ Claude Code، Codex اور Cursor کے ایجنٹ موڈ جیسے کوڈنگ ایجنٹس اسی لوپ کے گرد بنائے گئے ہیں، مزید ٹولز اور مزید احتیاط کے ساتھ۔ نیچے آپ بغیر کسی کی کے 40 لائنوں کا ورژن چلائیں گے، پھر اسے ایک حقیقی ماڈل کی طرف اشارہ کریں گے۔
ایک تصویر میں لوپ#
ایک ایسے مینیجر کا تصور کریں جو کچھ بھی نہیں چھو سکتا۔ مینیجر صرف نوٹ لکھتا ہے: "براہ کرم مجھے todo.txt لاؤ"۔ ایک اسسٹنٹ (آپ کا پروگرام) شیلف کے پاس جاتا ہے، فائل لاتا ہے اور میز پر رکھ دیتا ہے۔ مینیجر اسے پڑھتا ہے اور اگلا نوٹ، یا حتمی جواب لکھتا ہے۔
یہی پورا راز ہے۔ ماڈل کبھی فائل نہیں کھولتا اور نہ کوئی کمانڈ چلاتا ہے۔ وہ متن لکھتا ہے جو بتاتا ہے کہ کون سا ٹول کال کرنا ہے اور کن دلائل کے ساتھ۔ آپ کا کوڈ کام کرتا ہے اور رپورٹ کرتا ہے۔ اگر آپ نے function calling دیکھا ہے، تو یہ وہی طریقہ کار ہے، جو کام مکمل ہونے تک دہرایا جاتا ہے۔
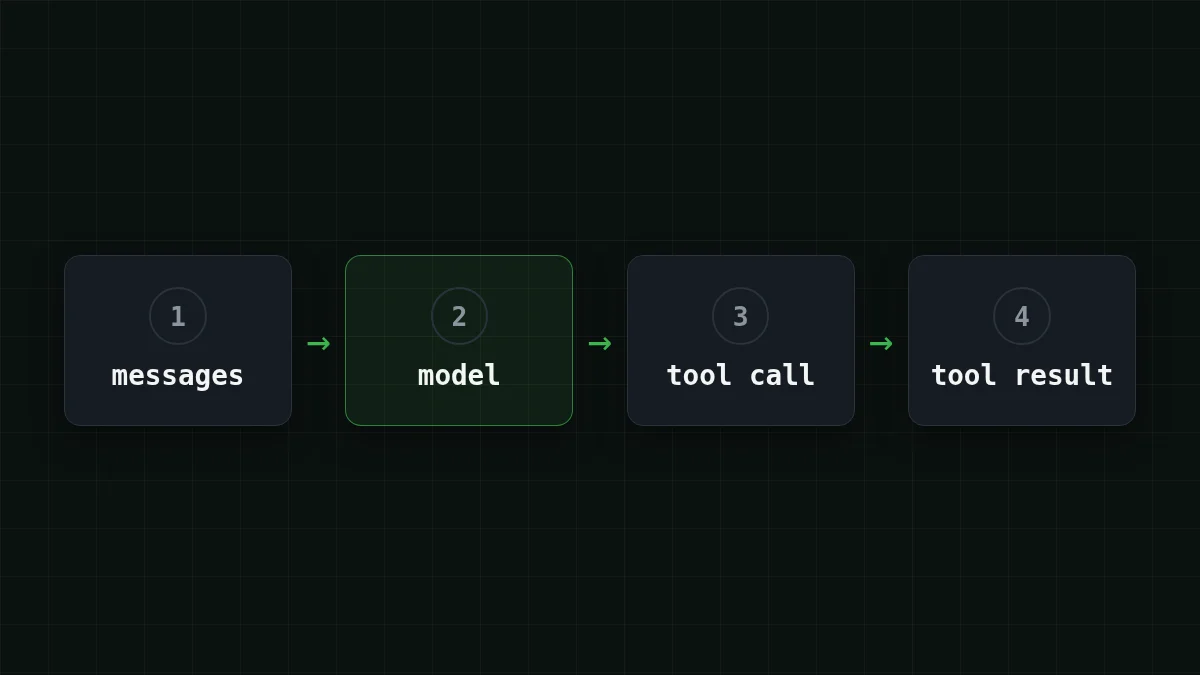
کیا آپ لوپ کا ایک چکر صحیح ترتیب میں رکھ سکتے ہیں؟
ترتیب دیں
ایجنٹ لوپ کا ایک چکر ترتیب دیں
آئٹمز کو گھسیٹیں یا تیروں کا استعمال کریں
- کام اور ٹول کی فہرست ماڈل کو بھیجیں
- ماڈل متن کے بجائے ٹول کال کے ساتھ جواب دیتا ہے
- آپ کا پروگرام خود وہ ٹول چلاتا ہے
- نتیجہ "tool" پیغام کے طور پر messages میں جاتا ہے
- ماڈل کو نتیجے کے ساتھ دوبارہ کال کیا جاتا ہے، جب تک وہ سادہ متن میں جواب نہ دے
اسے بغیر کی کے چلائیں#
فرض کریں کام یہ ہے: "todo.txt میں کتنے آئٹمز ہیں؟"۔ ٹول ایک فنکشن read_file ہے جو ڈسک کے بجائے ایک چھوٹی ڈکشنری میں دیکھتا ہے۔ اور حقیقی ماڈل کے بجائے ایک اسکرپٹ شدہ ماڈل ہے جو ہمیشہ وہی دو کام کرتا ہے: فائل مانگنا، پھر جواب دینا۔ یہ ہر حرکت پذیر حصہ دیکھنے کے لیے کافی ہے۔ اسے agent_loop.py کے طور پر محفوظ کریں (Python 3.10+، صرف معیاری لائبریری):
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
python agent_ چلائیں۔ آپ کے ماحول میں LLM_API_KEY نہ ہونے پر آپ کو اسکرپٹ شدہ ماڈل ملتا ہے، اور اسکرین بالکل دو چکر دکھاتی ہے:
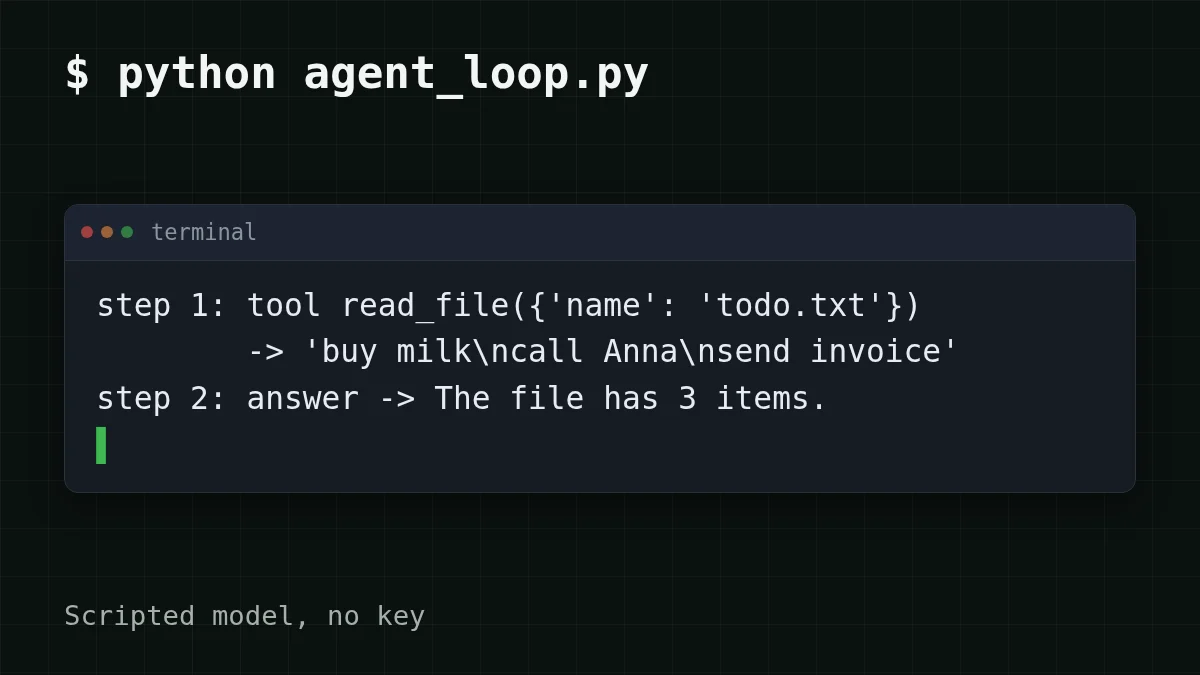
تین لائنیں دیکھیں، کیونکہ ان میں پورا خیال ہے:
messages.ماڈل کی اپنی باری رکھتا ہے۔ اسے چھوڑ دیں، اور اگلی کال میں ایک ٹول نتیجہ ہوگا جو ایسی درخواست کا جواب دیتا ہے جو API نے کبھی نہیں دیکھی؛ زیادہ تر APIs اسے 400 کے ساتھ مسترد کر دیتے ہیں۔append(reply) argumentsایک JSON سٹرنگ کے طور پر آتا ہے، لہذا فنکشن کال کرنے سے پہلے یہjson.loadsسے گزرتا ہے۔max_stepsہنگامی بریک ہے۔ ایک ماڈل ہمیشہ ٹولز مانگتا رہ سکتا ہے، اس لیے ہر حقیقی ایجنٹ کی ایسی حد ہوتی ہے۔
اسی لوپ کو حقیقی ماڈل کی طرف اشارہ کریں#
صرف ایک چیز بدلتی ہے: ماڈل کون ادا کرتا ہے۔ اسکرپٹ تین ماحول متغیرات پڑھتا ہے، اور اگر کی موجود ہو تو یہی messages ایک OpenAI-مطابق اینڈ پوائنٹ کو بھیجتا ہے۔ CheapTokens کا پتہ https:/ ہے (OpenAI Chat Completions اور Anthropic Messages کے مطابق)، اور ماڈل آئی ڈی docs سے مکمل ہونی چاہیے: deepseek-۔
لوپ کو تین طریقوں سے چلائیں
بغیر کی
python agent_loop.pyاسکرپٹ شدہ ماڈل دونوں چکر ادا کرتا ہے۔ کچھ بھی آپ کی مشین سے باہر نہیں جاتا۔
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
380K کانٹیکسٹ ونڈو اور فی جواب 32,768 آؤٹ پٹ ٹوکنز تک: لمبے لوپ کے لیے گنجائش۔
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
ملٹی اسٹیپ لوپ کی پہلی رن کے لیے 390K کانٹیکسٹ ونڈو والا ایک ہلکا ماڈل۔
آپ کو وہی شکل نظر آئے گی جو پہلے تھی: step 1: tool read_، پھر step 2: answer -، ہر ماڈل کال کے نیچے ایک usage: لائن کے ساتھ۔ جواب کی عبارت اسکرپٹ شدہ سے مختلف ہوگی، اور ایک باتونی ماڈل ایک اضافی چکر لے سکتا ہے۔ یہ معمول ہے: ماڈل فیصلہ کرتا ہے، لوپ صرف اطاعت کرتا ہے۔ کی کو خود اسکرپٹ میں نہ رکھیں؛ ماحول متغیر محفوظ جگہ ہے (یہاں اسے کیسے محفوظ کریں)۔
usage: لائنیں مفید حصہ ہیں۔ لمبی رن کے in نمبر شامل کریں اور آپ دیکھیں گے کہ پیسہ کہاں جاتا ہے۔
ہر چکر پچھلے سے زیادہ مہنگا کیوں ہے#
ماڈل کالز کے درمیان کچھ یاد نہیں رکھتا۔ ہر چکر پوری messages فہرست دوبارہ بھیجتا ہے: کام، ہر پچھلی ٹول کال، ہر ٹول نتیجہ۔ (یہی اصول لمبی چیٹ کو مہنگا بناتا ہے؛ multi-turn chat اسے سادہ گفتگو پر دکھاتا ہے۔)
چکر 1 ایک پیغام بھیجتا ہے۔ اگر لوپ جاری رہے، تو چکر 6 گیارہ بھیجتا ہے۔
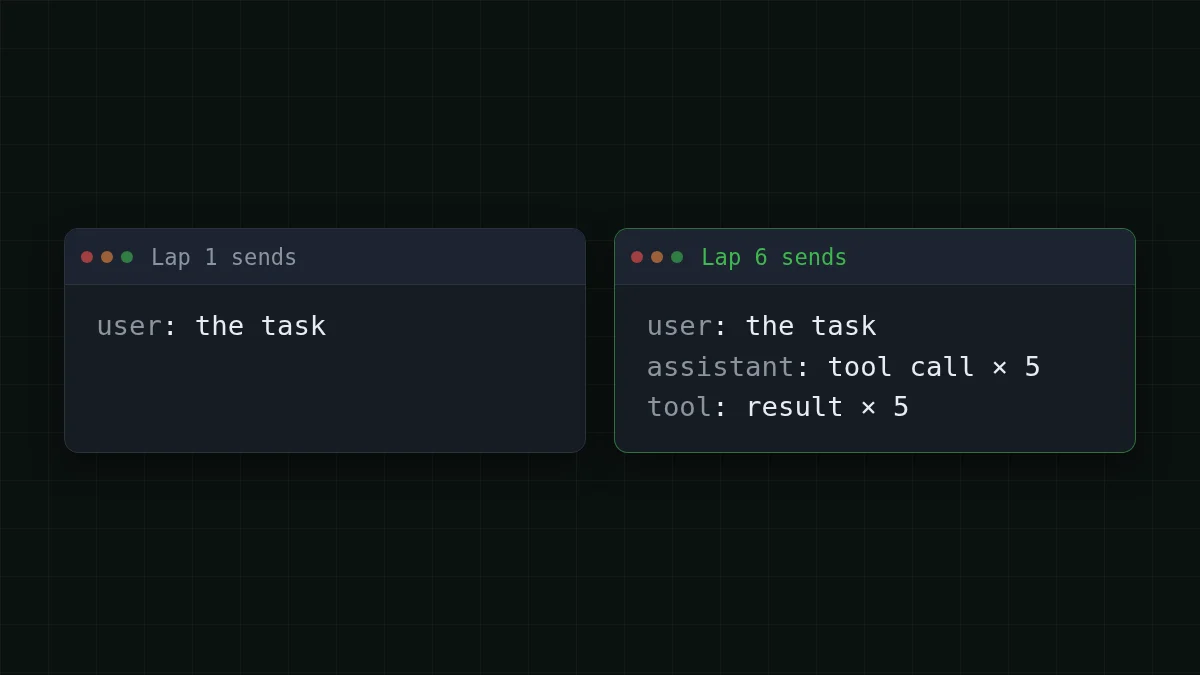
فرض کریں ایک حقیقی کام 10 چکر لیتا ہے۔ یہ تقریباً 2,000 ٹوکنز سے شروع ہوتا ہے (ہدایات، ٹول فہرست، آپ کی درخواست)، ہر چکر تقریباً 1,500 شامل کرتا ہے (ایک ٹول نتیجہ اور ماڈل کا نوٹ)، اور ماڈل فی چکر تقریباً 300 ٹوکنز لکھتا ہے۔ چکر 1 2,000 بھیجتا ہے، چکر 2 3,500، چکر 10 15,500۔ پہلے حصے کا مجموعہ 10 × 2,000 = 20,000 ٹوکنز ہے؛ اضافہ 1,500 × 45 = 67,500 جوڑتا ہے (45 ہے 0+1+…+9)، لہذا کام پر ان پٹ 20,000 + 67,500 = 87,500 ٹوکنز ہے۔ آؤٹ پٹ 10 × 300 = 3,000 ٹوکنز ہے۔
کام کا متن خود چند جملے ہے، پھر بھی ان پٹ کی طرف 87,500 ٹوکنز ہے۔ $0.015 فی 1M ان پٹ ٹوکنز پر، DeepSeek-V4-Flash پر پورا کام $0.0016 بنتا ہے۔ یہاں ماڈلز کے درمیان وہی بوجھ ہے، حوالے کے لیے OpenRouter کے ساتھ۔ مجموعی طور پر، ان پٹ اور آؤٹ پٹ کو ملا کر، اس بوجھ پر CheapTokens OpenRouter سے سستا نکلتا ہے:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | لاگت | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
کل 87,500 ان پٹ اور 3,000 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
دن کے کسی بھی وقت ایک قیمت یہاں بھی مدد کرتی ہے: رات بھر چلنے والے ایجنٹ کی لاگت دوپہر والے جیسی ہوتی ہے، اور آپ تمام قیمتیں pricing page پر دیکھ سکتے ہیں۔ ایسے کاموں کے ایک دن کے لیے، سلائیڈرز حرکت دیں:
لاگت کیلکولیٹر
ایک دن: 10 چکروں کے 20 کام
فی درخواست ان پٹ ٹوکنز: 8,750 · فی درخواست آؤٹ پٹ ٹوکنز: 300 · فی دن درخواستیں: 200
| ماڈل | فی دن | فی ماہ |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
فیلڈز فی ماڈل کال ہیں: 8,750 اوپر کی مثال سے ایک چکر کا اوسط ان پٹ ہے (87,500 ÷ 10)، اور 200 کالز ہیں 20 کام × 10 چکر۔ یہی وجہ ہے کہ ایجنٹ کے بل تاریخ کے بارے میں ہوتے ہیں، سوال کے بارے میں نہیں۔ 20-step example اسی اثر میں مزید گہرائی میں جاتا ہے۔
فوری جانچ
ایجنٹ لوپ کا چکر 3 چکر 1 سے زیادہ مہنگا ہے، حالانکہ آپ نے کچھ نیا نہیں پوچھا۔ کیوں؟
جواب دکھائیں
جواب: messages فہرست میں اب دو ٹول کالز اور دو نتائج ہیں، اور یہ سب دوبارہ بھیجا جاتا ہے
API بے حالت ہے۔ ہر کال پوری تاریخ لے کر چلتی ہے، لہذا ان پٹ ٹوکنز ہر چکر کے ساتھ بڑھتے ہیں جبکہ آؤٹ پٹ تقریباً ویسا ہی رہتا ہے۔
40 لائنوں سے آگے کہاں جائیں#
اوپر کا اسکرپٹ سیکھنے کے لیے ایک خاکہ ہے۔ اگر آپ لمبا ورژن چاہتے ہیں، تو GitHub پر ایک کھلا کورس ہے، justxor/agent-harness-course (README روسی میں، 31 اکتوبر 2026 کو چیک کیا گیا)۔ یہ سادہ Python 3.10+ ہے بغیر کسی ڈیپنڈنسی کے، کوڈ MIT لائسنس یافتہ ہے، متن CC BY 4.0۔ کلون کرنے کے بعد، python examples/ لوپ کو اسکرپٹ شدہ ماڈل کے ساتھ آف لائن چلاتا ہے، اور python - اس کے 19 ٹیسٹ بغیر نیٹ ورک چلاتا ہے۔ کورس کانٹیکسٹ کمپیکشن، میموری، سب ایجنٹس، خطرناک اقدامات کی انسانی منظوری، اور لاگت ٹریکنگ کے ساتھ جاری رہتا ہے۔ حقیقی ماڈل کے لیے یہ LLM_PROVIDER، LLM_MODEL، LLM_API_KEY پڑھتا ہے اور، OpenAI-مطابق اینڈ پوائنٹس کے لیے، LLM_BASE_URL: اس کے README سے عین LLM_PROVIDER ویلیو لیں۔
جب لوپ کام کرے، تو اگلا قدم ایک حقیقی کی اور ایک حقیقی کام ہے: docs میں ایک منٹ میں پہلی درخواست ہے، اور DeepSeek-V4-Flash لوپ چلانے کے لیے ایک اچھا ماڈل ہے۔


