شروعاتگائیڈ
API کے ساتھ multi-turn چیٹ: messages array دوبارہ بھیجیں
ماڈل درخواستوں کے درمیان کچھ یاد نہیں رکھتا۔ ایک Python چیٹ لوپ بنائیں جو messages array دوبارہ بھیجے اور دیکھیں input tokens کیسے بڑھتے ہیں۔
اس صفحہ پر
آپ کے دوسرے سوال کا جواب عجیب آتا ہے کیونکہ API نے آپ کا پہلا سوال کبھی دیکھا ہی نہیں۔ ماڈل درخواستوں کے درمیان کچھ نہیں رکھتا، اس لیے چیٹ کچھ ایسا ہے جو آپ بناتے ہیں: ہر جواب کے بعد آپ اسے messages نامی فہرست میں شامل کرتے ہیں اور پوری فہرست دوبارہ بھیجتے ہیں۔ یہی پورا راز ہے، اور نیچے CheapTokens کی OpenAI-compatible API کے خلاف اس کے لیے ایک کام کرنے والا Python لوپ ہے۔
دو سرکاری دستاویزات اسی چیز کو بیان کرتی ہیں۔ Anthropic کی Messages API reference (30 اکتوبر 2026 کو چیک شدہ) API کو stateless اور multi-turn کہتی ہے: پہلے کے turns messages پیرامیٹر میں جاتے ہیں۔ OpenAI کی text-generation guide (30 اکتوبر 2026 کو چیک شدہ) کہتی ہے کہ سیاق و سباق برقرار رکھنے کے لیے پہلے کے turns کو role-tagged messages کے طور پر بھیجیں اور ہر جواب کو اگلی درخواست سے پہلے شامل کریں۔
دوسرے سوال کو خالی نظروں سے کیوں دیکھا جاتا ہے#
فرض کریں آپ What is a token? ٹائپ کرتے ہیں، جواب پڑھتے ہیں، اور پھر Explain it shorter ٹائپ کرتے ہیں۔ آپ کے لیے "it" واضح ہے۔ API کے لیے، دوسری درخواست ایک اجنبی کا ایک سطری پیغام ہے: کوئی "it" نہیں، مختصر کرنے کے لیے کچھ نہیں۔ آپ کو کوئی اندازہ یا سوال واپس ملے گا، مختصر وضاحت نہیں۔
حل یہ ہے کہ دوسری درخواست میں وہ سب کچھ شامل ہو جو پہلی درخواست میں تھا، پلس جواب، پلس نیا سوال۔ دونوں payloads کا موازنہ کریں:
موازنہ کریں
درخواست 2، تاریخ کے ساتھ اور بغیر
تاریخ کے بغیر
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
ماڈل کو کوئی اندازہ نہیں کہ "it" کیا ہے۔
تاریخ کے ساتھ
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
اب "it" پہلے جواب کی طرف اشارہ کرتا ہے۔
تین roles سارا کام کرتے ہیں۔ system قواعد ایک بار طے کرتا ہے (لہجہ، لمبائی، بوٹ کس لیے ہے)۔ user وہ ہے جو شخص نے ٹائپ کیا۔ assistant وہ ہے جو ماڈل نے پہلے کہا۔ ماڈل فہرست کو اوپر سے نیچے پڑھتا ہے اور اگلا assistant پیغام لکھتا ہے۔
چند سطروں میں چیٹ لوپ#
SDK کو pip install openai سے انسٹال کریں اور اپنی key کو environment variable میں رکھیں، جیسا کہ API key محفوظ طریقے سے کیسے اسٹور کریں میں ہے۔ base URL اور model id CheapTokens docs اور GET /v1/models سے آتے ہیں (مزید درست id تلاش کرنے کے لیے ماڈلز کی فہرست میں)۔ سیکھنے کے لوپ کے لیے، GLM-5.3-Flash اچھا انتخاب ہے: 390K context اور فی جواب زیادہ سے زیادہ 8,192 output tokens۔
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
اسے چلائیں، What is a token? پوچھیں، پھر Explain it shorter۔ دوسرا جواب اب پہلے جواب کا حوالہ دیتا ہے۔ آخری سطر usage. پرنٹ کرتی ہے، اس turn کے بل کا input side؛ دیکھیں کہ ہر سوال کے ساتھ یہ بڑھتا ہے۔
لوپ کے اندر ترتیب اہم ہے، اور یہی وہ حصہ ہے جہاں مبتدی سب سے زیادہ غلطی کرتے ہیں:
ترتیب دیں
لوپ کے ایک turn کو ترتیب دیں
آئٹمز کو گھسیٹیں یا تیروں کا استعمال کریں
- صارف کا سوال messages میں شامل کریں
- پوری messages فہرست بھیجیں
- response سے جواب پڑھیں
- جواب کو assistant message کے طور پر شامل کریں
مرحلہ 4 چھوڑ دیں تو ماڈل اپنے جوابات بھول جاتا ہے، اس لیے "explain it shorter" ایک بار کام کرتا ہے اور پھر تیسرے سوال پر دوبارہ ٹوٹ جاتا ہے۔
دو turns کے بعد فہرست کیسی دکھتی ہے#
What is a token? اور Explain it shorter کے بعد، آپ کے کوڈ کے پاس موجود فہرست میں پانچ entries ہیں: system rule، پہلا سوال، پہلا جواب، دوسرا سوال، دوسرا جواب۔ اگلی درخواست یہ پانچوں پلس تیسرا سوال بھیجے گی۔
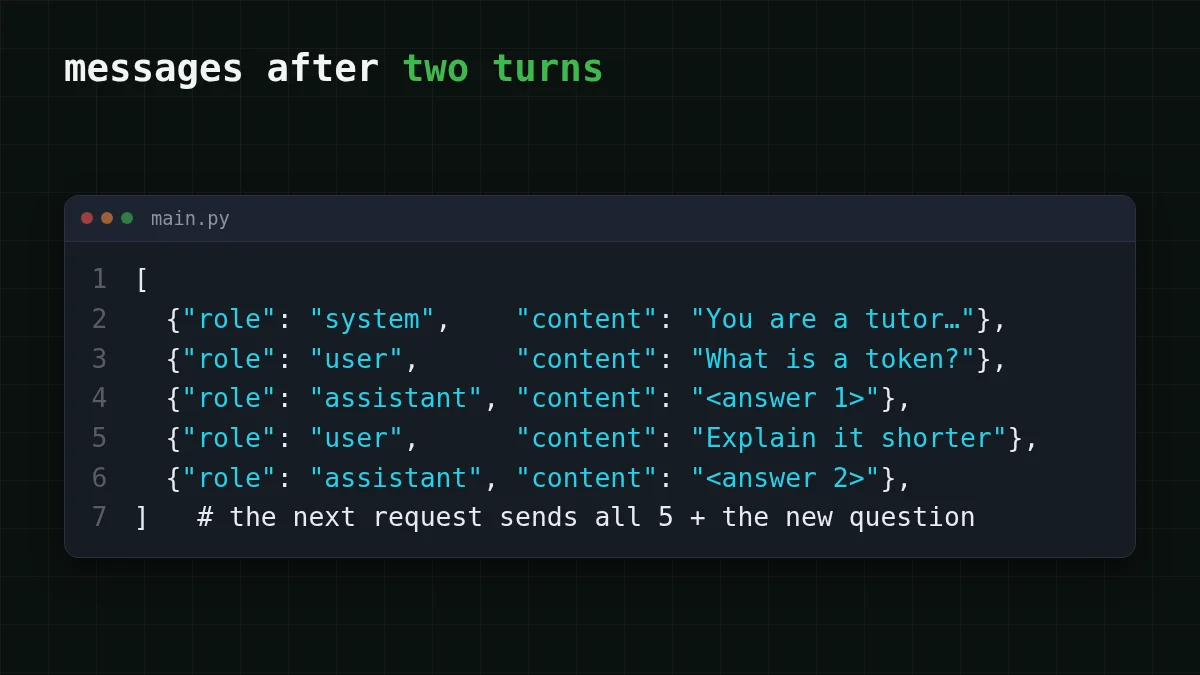
system message ہر بار بھیجا جاتا ہے۔ API اسے اپنی طرف "نہیں رکھتی"؛ یہ صرف فہرست کی پہلی item ہے۔ OpenAI کی guide (30 اکتوبر 2026 کو چیک شدہ) نوٹ کرتی ہے کہ ہدایات صرف موجودہ درخواست پر لاگو ہوتی ہیں، جو دوسری سمت سے وہی خیال ہے۔ اگر آپ اس پہلے پیغام کو ٹیون کرنا چاہتے ہیں، تو system prompt اور temperature کی وضاحت دیکھیں۔
چیٹ بڑھنے کے ساتھ input tokens کا کیا ہوتا ہے#
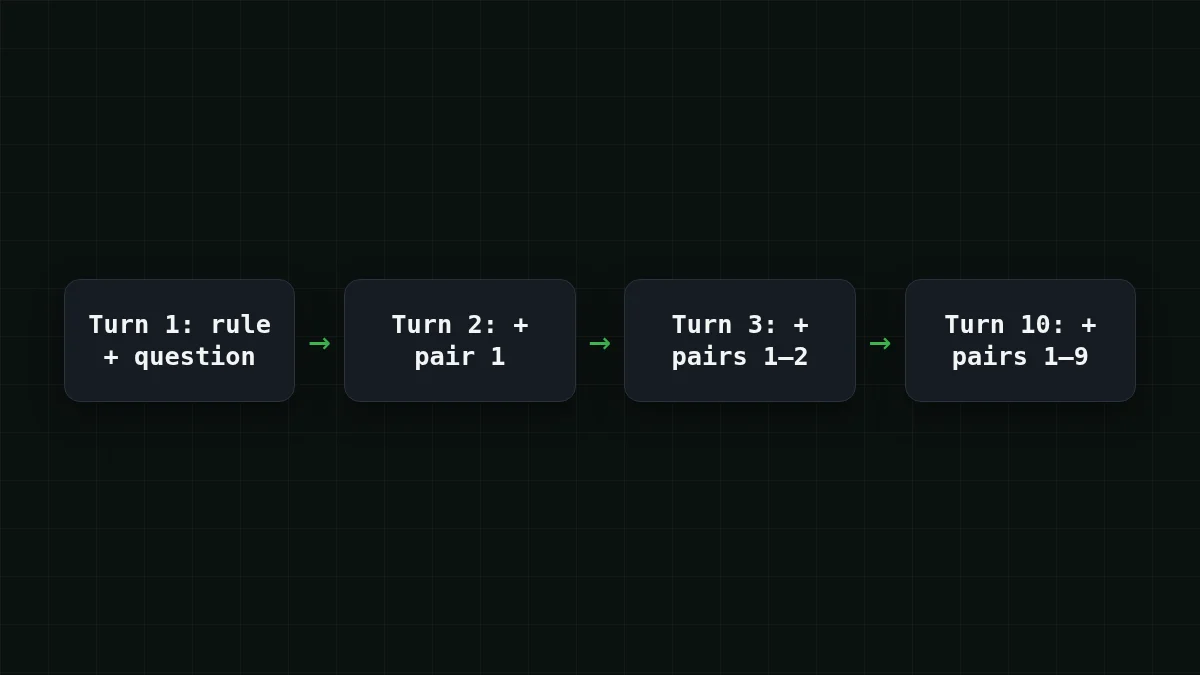
ہر درخواست پوری فہرست کا دوبارہ input کے طور پر ادائیگی کرتی ہے۔ Turn 1 system rule اور ایک سوال بھیجتا ہے؛ turn 10 rule، نو پہلے سوال-جواب جوڑے اور نیا سوال بھیجتا ہے۔ اس لیے input ہر turn کے ساتھ بڑھتا ہے، چاہے آپ کے ہر پیغام مختصر ہوں۔
فرض کریں 10-turn چیٹ ان مفروضوں کے ساتھ: system rule تقریباً 50 tokens، ہر سوال تقریباً 150، ہر جواب تقریباً 250۔ Turn 1 50 + 150 = 200 input tokens بھیجتا ہے۔ ہر بعد کا turn ایک اور 400-token جوڑا (150 + 250 = 400) شامل کرتا ہے، اس لیے دس turns میں کل input 200 × 10 + 400 × 45 = 20,000 tokens ہے، جہاں 45 = 0 + 1 + … + 9۔ Output 250 × 10 = 2,500 tokens ہے۔ آپ کی طرف سے دس پیغامات، اور input output سے آٹھ گنا ہے۔
یہاں وہ پوری چیٹ live rates پر قیمت کی گئی ہے، 20,000 tokens in اور 2,500 out:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | لاگت | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
کل 20,000 ان پٹ اور 2,500 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
کل میں، input اور output ملا کر، GLM-5.3-Flash اور DeepSeek-V4-Flash یہاں OpenRouter سے کم لاگت آتے ہیں، اور دونوں کسی بھی وقت ایک ہی قیمت رکھتے ہیں۔ اگر آپ اسی چیٹ لوپ میں 8,192 tokens سے لمبے جوابات چاہتے ہیں، تو DeepSeek-V4-Flash فی جواب 32,768 output tokens تک اجازت دیتا ہے 380K context کے ساتھ؛ model id کو deepseek- سے بدل دیں اور لوپ میں کچھ اور نہیں بدلتا۔
لاگت کی گہری کہانی لمبی AI چیٹ زیادہ مہنگی کیوں ہے میں ہے؛ input vs output tokens بتاتا ہے کہ دونوں اطراف کی قیمت الگ کیوں ہے۔
فوری جانچ
آپ کی چیٹ turn 8 پر ہے۔ Turn 8 کی درخواست میں کیا ہوتا ہے؟
جواب دکھائیں
جواب: system message اور ہر پہلا سوال اور جواب، پلس تازہ ترین سوال
API کچھ یاد نہیں رکھتی، اس لیے ہر بار پوری فہرست جاتی ہے۔ یہی وجہ ہے کہ input tokens turn در turn بڑھتے ہیں۔
لمبی چیٹ کو قابو میں رکھنا#
فہرست ہمیشہ نہیں بڑھ سکتی: اسے ماڈل کی context window میں فٹ ہونا ہے (context window کیا ہے دیکھیں)، اور ہر اضافی turn input کی لاگت ہے۔ دو عادتیں prototype کے لیے اسے معقول رکھتی ہیں:
- سب سے پرانے turns تراشیں۔ system message اور آخری چند جوڑے رکھیں، مثلاً ہر درخواست سے پہلے
messages = messages[:1] + messages[-۔ جوڑے اکٹھے ہٹائیں تاکہ کسی سوال کا جواب کبھی نہ کھوئے۔8:] - نئے موضوع کے لیے نئی فہرست شروع کریں۔ نئے کام کو پرانے کی تاریخ کی ضرورت نہیں۔
لمبی عمر والے rule set کے ساتھ support bot بھی وہی لوپ ہے: system message قواعد ایک بار طے کرتا ہے، ہر user turn اور جواب شامل ہوتا ہے، اور جب فہرست بھاری ہو جائے تو آپ تراشتے ہیں۔ پہلی درخواست کے لیے، CheapTokens کے ساتھ آپ کی پہلی API درخواست دیکھیں؛ ماڈل کی فہرست اور قیمتیں pricing page پر ہیں۔


