Primeiros passosGuia
Chat multi-turno com uma API: reenvie o array de mensagens
O modelo não lembra de nada entre requisições. Construa um loop de chat em Python que reenvia o array de mensagens e veja como os tokens de entrada crescem.
Nesta página
Sua segunda pergunta recebe uma resposta estranha porque a API nunca viu a primeira. O modelo não guarda nada entre requisições, então um chat é algo que você constrói: após cada resposta você a acrescenta a uma lista chamada messages e envia a lista inteira novamente. É esse o truque todo, e abaixo está um loop Python funcional para isso contra a API compatível com OpenAI da CheapTokens.
Duas documentações oficiais descrevem a mesma coisa. A referência da Messages API da Anthropic (verificada em 30 de outubro de 2026) chama a API de stateless e multi-turn: turnos anteriores viajam no parâmetro messages. O guia de geração de texto da OpenAI (verificado em 30 de outubro de 2026) diz para manter o contexto enviando turnos anteriores como mensagens com papel definido e acrescentando cada resposta antes da próxima requisição.
Por que a segunda pergunta recebe um olhar vazio#
Digamos que você digite What is a token?, leia a resposta e então digite Explain it shorter. Para você, "isso" é óbvio. Para a API, a requisição número dois é a mensagem de uma linha de um estranho: não há "isso", nada a encurtar. Você receberá de volta um palpite ou uma pergunta, não uma explicação mais curta.
A correção é fazer a requisição dois carregar tudo o que a requisição um tinha, mais a resposta, mais a nova pergunta. Compare os dois payloads:
Comparar
Requisição 2, com e sem histórico
Sem histórico
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
O modelo não tem ideia do que é "isso".
Com histórico
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
Agora "isso" aponta para a primeira resposta.
Três papéis fazem todo o trabalho. system define as regras uma vez (tom, comprimento, para que serve o bot). user é o que a pessoa digitou. assistant é o que o modelo disse antes. O modelo lê a lista de cima a baixo e escreve a próxima mensagem assistant.
O loop de chat em poucas linhas#
Instale o SDK com pip install openai e mantenha sua chave em uma variável de ambiente, como em como armazenar uma chave de API com segurança. A URL base e o id do modelo vêm da documentação da CheapTokens e de GET /v1/models (mais em listando modelos para encontrar o id exato). Para um loop de aprendizado, o GLM-5.3-Flash é uma boa escolha: contexto de 390K e até 8.192 tokens de saída por resposta.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
Execute, pergunte What is a token?, depois Explain it shorter. A segunda resposta agora se refere à primeira. A última linha imprime usage., o lado de entrada da conta daquele turno; observe-o subir a cada pergunta.
A ordem dentro do loop importa, e é a parte que os iniciantes mais erram:
Colocar em ordem
Coloque um turno do loop em ordem
Arraste os itens ou use as setas
- Acrescente a pergunta do usuário a messages
- Envie a lista messages inteira
- Leia a resposta da resposta
- Acrescente a resposta como uma mensagem assistant
Pule o passo 4 e o modelo esquece suas próprias respostas, então "explique mais curto" funciona uma vez e depois quebra de novo na terceira pergunta.
Como a lista fica depois de dois turnos#
Depois de What is a token? e Explain it shorter, a lista que seu código mantém tem cinco entradas: a regra do sistema, a primeira pergunta, a primeira resposta, a segunda pergunta, a segunda resposta. A próxima requisição enviará todas as cinco mais a terceira pergunta.
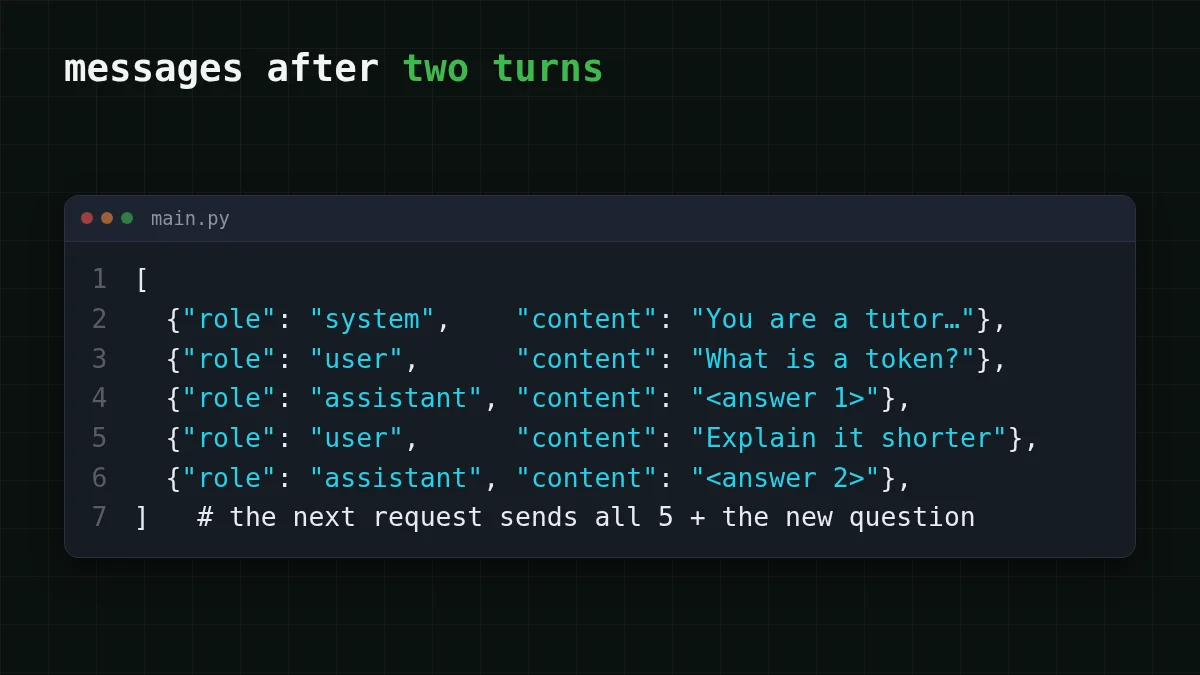
A mensagem de sistema é enviada toda vez. A API não a "mantém" do lado dela; ela é apenas o primeiro item da lista. O guia da OpenAI (verificado em 30 de outubro de 2026) observa que as instruções se aplicam apenas à requisição atual, o que é a mesma ideia pela outra direção. Se você quiser ajustar essa primeira mensagem, veja system prompt e temperature explicados.
O que acontece com os tokens de entrada conforme o chat cresce#
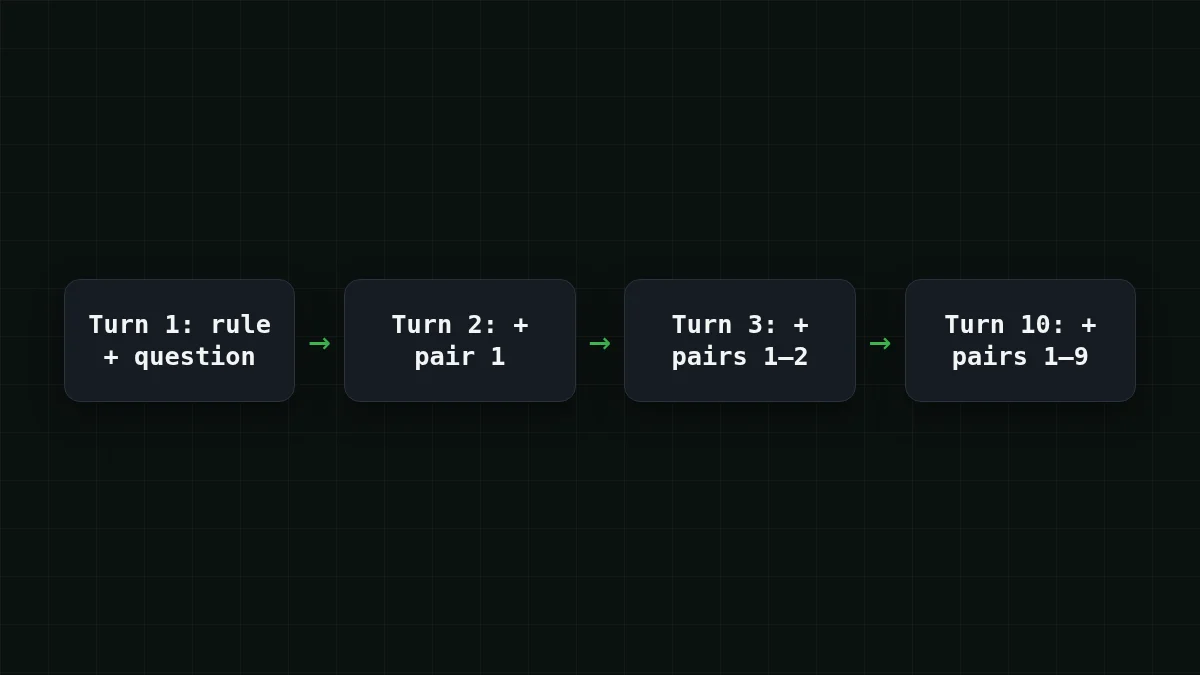
Toda requisição paga pela lista inteira novamente como entrada. O turno 1 envia a regra do sistema e uma pergunta; o turno 10 envia a regra, nove pares pergunta-e-resposta anteriores e a nova pergunta. Então a entrada cresce a cada turno, mesmo que cada uma das suas mensagens seja curta.
Digamos um chat de 10 turnos com estas premissas: a regra do sistema tem cerca de 50 tokens, cada pergunta cerca de 150, cada resposta cerca de 250. O turno 1 envia 50 + 150 = 200 tokens de entrada. Cada turno posterior acrescenta mais um par de 400 tokens (150 + 250 = 400), então o total de entrada ao longo de dez turnos é 200 × 10 + 400 × 45 = 20.000 tokens, onde 45 é 0 + 1 + … + 9. A saída é 250 × 10 = 2.500 tokens. Dez mensagens suas, e a entrada é oito vezes a saída.
Aqui está esse chat inteiro precificado com tarifas ao vivo, 20.000 tokens de entrada e 2.500 de saída:
| Modelo | Entrada $/1M | Saída $/1M | Custo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
20.000 tokens de entrada e 2.500 tokens de saída no total. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
No total, com entrada e saída contadas juntas, GLM-5.3-Flash e DeepSeek-V4-Flash custam aqui menos do que na OpenRouter, e ambos mantêm um preço em qualquer horário. Se você quiser respostas mais longas que 8.192 tokens no mesmo loop de chat, o DeepSeek-V4-Flash permite até 32.768 tokens de saída por resposta com um contexto de 380K; troque o id do modelo por deepseek- e nada mais no loop muda.
A história mais profunda de custos está em por que um chat de IA longo custa mais; tokens de entrada vs saída explica por que os dois lados são precificados separadamente.
Verificação rápida
Seu chat está no turno 8. O que a requisição do turno 8 contém?
Mostrar resposta
Resposta: A mensagem de sistema e todas as perguntas e respostas anteriores, mais a pergunta mais recente
A API não lembra de nada, então a lista completa sai a cada vez. É também por isso que os tokens de entrada sobem turno após turno.
Mantendo um chat longo sob controle#
A lista não pode crescer para sempre: ela precisa caber na janela de contexto do modelo (veja o que é uma janela de contexto), e cada turno extra custa entrada. Dois hábitos a mantêm sensata para um protótipo:
- Corte os turnos mais antigos. Mantenha a mensagem de sistema e os últimos pares, por exemplo
messages = messages[:1] + messages[-antes de cada requisição. Descarte pares juntos para que uma pergunta nunca perca sua resposta.8:] - Comece uma lista nova para um novo tópico. Uma nova tarefa não precisa do histórico da antiga.
Um bot de suporte com um conjunto de regras de longa duração é o mesmo loop: a mensagem de sistema define as regras uma vez, cada turno do usuário e resposta é acrescentado, e você corta quando a lista fica pesada. Para a primeira requisição em si, veja sua primeira requisição de API com a CheapTokens; a lista de modelos e os preços estão na página de preços.


