PagsisimulaGabay
Multi-turn chat gamit ang API: ipadala muli ang messages array
Walang natatandaan ang modelo sa pagitan ng mga kahilingan. Bumuo ng Python chat loop na nagpapadala muli ng messages array at tingnan kung paano lumalaki ang input tokens.
Sa pahinang ito
Ang iyong pangalawang tanong ay nakakakuha ng kakaibang sagot dahil hindi kailanman nakita ng API ang iyong una. Walang itinatago ang modelo sa pagitan ng mga kahilingan, kaya ang isang chat ay isang bagay na ikaw ang bumubuo: pagkatapos ng bawat tugon, idinadagdag mo ito sa isang listahan na tinatawag na messages at ipinapadala muli ang buong listahan. Iyon ang buong lansihin, at nasa ibaba ang isang gumaganang Python loop para dito laban sa CheapTokens OpenAI-compatible API.
Dalawang opisyal na dokumento ang naglalarawan ng parehong bagay. Tinatawag ng Anthropic's Messages API reference (sinuri noong 30 Oktubre 2026) ang API na stateless at multi-turn: ang mga naunang turn ay naglalakbay sa messages parameter. Sinasabi ng OpenAI's text-generation guide (sinuri noong 30 Oktubre 2026) na panatilihin ang konteksto sa pamamagitan ng pagpapadala ng mga naunang turn bilang role-tagged na mga mensahe at pagdaragdag ng bawat tugon bago ang susunod na kahilingan.
Bakit ang pangalawang tanong ay nakakakuha ng blangko na tingin#
Sabihin mong nag-type ka ng What is a token?, binasa ang sagot, at pagkatapos ay nag-type ng Explain it shorter. Para sa iyo, ang "it" ay halata. Para sa API, ang kahilingan bilang dalawa ay isang one-line na mensahe ng estranghero: walang "it", walang dapat paikliin. Makakakuha ka ng hula o tanong pabalik, hindi isang mas maikling paliwanag.
Ang solusyon ay gawing daladala ng kahilingan bilang dalawa ang lahat ng nasa kahilingan bilang isa, kasama ang tugon, at ang bagong tanong. Ihambing ang dalawang payload:
Ihambing
Kahilingan 2, may at walang kasaysayan
Walang kasaysayan
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
Walang ideya ang modelo kung ano ang "it".
May kasaysayan
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
Ngayon ang "it" ay tumutukoy sa unang sagot.
Tatlong role ang gumagawa ng lahat ng trabaho. Ang system ay nagtatakda ng mga patakaran nang isang beses (tono, haba, para saan ang bot). Ang user ay ang itina-type ng tao. Ang assistant ay ang sinabi ng modelo kanina. Binabasa ng modelo ang listahan mula taas hanggang ibaba at isinusulat ang susunod na assistant na mensahe.
Ang chat loop sa ilang linya#
I-install ang SDK gamit ang pip install openai at itago ang iyong key sa isang environment variable, tulad ng sa paano mag-imbak ng API key nang ligtas. Ang base URL at model id ay mula sa CheapTokens docs at GET /v1/models (higit pa sa paglista ng mga modelo upang mahanap ang eksaktong id). Para sa isang learning loop, ang GLM-5.3-Flash ay isang magandang fit: 390K context at hanggang 8,192 output tokens bawat sagot.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
Patakbuhin ito, itanong ang What is a token?, pagkatapos ay Explain it shorter. Ang pangalawang sagot ay tumutukoy na ngayon sa una. Ang huling linya ay nagpi-print ng usage., ang input side ng bill para sa turn na iyon; panoorin itong tumaas sa bawat tanong.
Mahalaga ang pagkakasunod-sunod sa loob ng loop, at ito ang bahaging madalas mali ng mga baguhan:
Ilagay sa tamang pagkakasunod-sunod
Ilagay ang isang turn ng loop sa ayos
I-drag ang mga item o gamitin ang mga arrow
- Idagdag ang tanong ng user sa messages
- Ipadala ang buong messages list
- Basahin ang tugon mula sa response
- Idagdag ang tugon bilang assistant message
Laktawan ang hakbang 4 at makakalimutan ng modelo ang sarili nitong mga sagot, kaya ang "explain it shorter" ay gagana nang isang beses at pagkatapos ay masisira muli sa ikatlong tanong.
Ano ang hitsura ng listahan pagkatapos ng dalawang turn#
Pagkatapos ng What is a token? at Explain it shorter, ang listahan na hawak ng iyong code ay may limang entry: ang system rule, ang unang tanong, ang unang sagot, ang pangalawang tanong, ang pangalawang sagot. Ipapadala ng susunod na kahilingan ang lahat ng lima kasama ang ikatlong tanong.
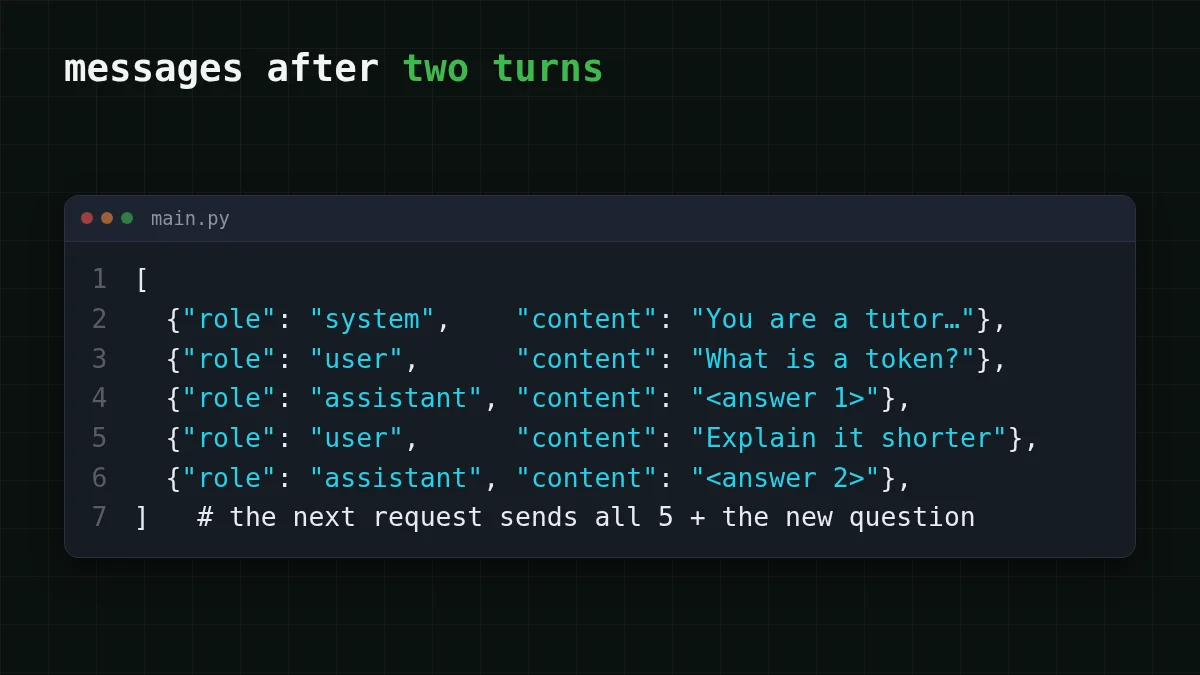
Ang system message ay ipinapadala sa bawat pagkakataon. Hindi ito "itinatago" ng API sa panig nito; ito lang ang unang item ng listahan. Tandaan ng OpenAI's guide (sinuri noong 30 Oktubre 2026) na ang mga instruksyon ay nalalapat lamang sa kasalukuyang kahilingan, na parehong ideya mula sa kabilang direksyon. Kung gusto mong i-tune ang unang mensaheng iyon, tingnan ang system prompt at temperature na ipinaliwanag.
Ano ang nangyayari sa input tokens habang lumalaki ang chat#
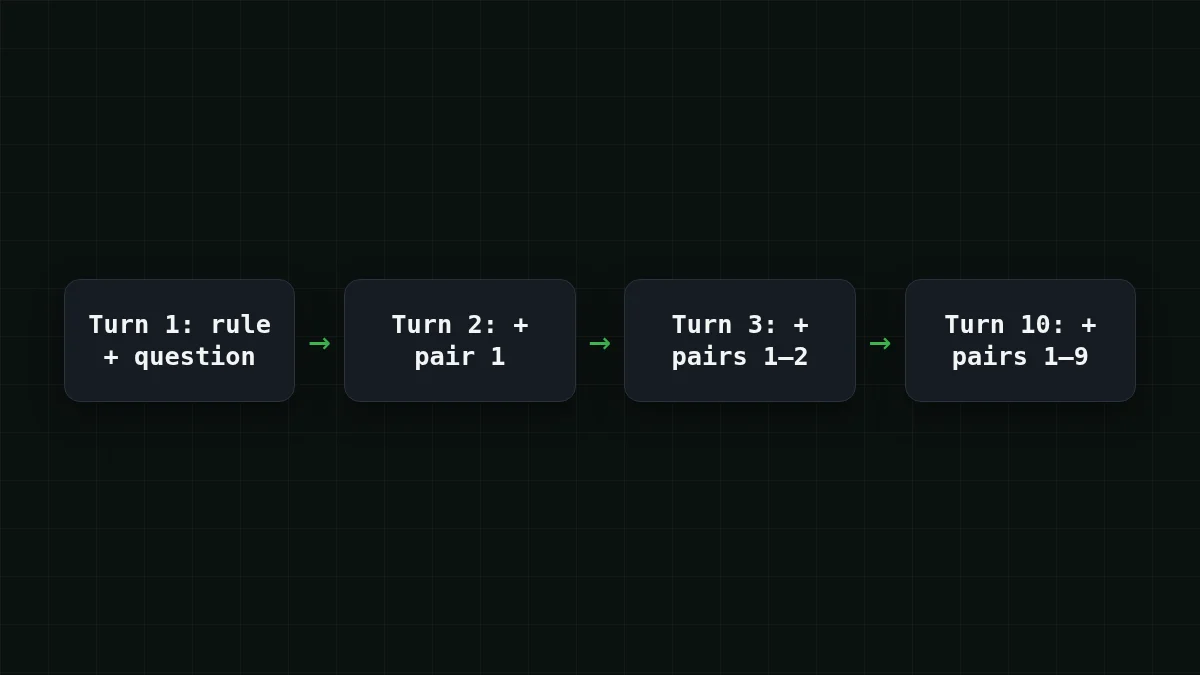
Bawat kahilingan ay nagbabayad muli para sa buong listahan bilang input. Ang Turn 1 ay nagpapadala ng system rule at isang tanong; ang turn 10 ay nagpapadala ng rule, siyam na naunang question-and-answer pairs at ang bagong tanong. Kaya lumalaki ang input sa bawat turn, kahit na ang bawat isa sa iyong mga mensahe ay maikli.
Sabihin nating isang 10-turn na chat na may mga assumption na ito: ang system rule ay mga 50 tokens, bawat tanong mga 150, bawat tugon mga 250. Ang Turn 1 ay nagpapadala ng 50 + 150 = 200 input tokens. Ang bawat susunod na turn ay nagdadagdag ng isa pang 400-token pair (150 + 250 = 400), kaya ang kabuuang input sa sampung turn ay 200 × 10 + 400 × 45 = 20,000 tokens, kung saan ang 45 ay 0 + 1 + … + 9. Ang output ay 250 × 10 = 2,500 tokens. Sampung mensahe mula sa iyo, at ang input ay walong beses ang output.
Narito ang buong chat na iyon na naka-presyo sa live rates, 20,000 tokens in at 2,500 out:
| Modelo | Input $/1M | Output $/1M | Gastos | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
20,000 input at 2,500 output na token sa kabuuan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Sa kabuuan, kung pagsasamahin ang input at output, ang GLM-5.3-Flash at DeepSeek-V4-Flash ay mas mura dito kaysa sa OpenRouter, at parehong nagpapanatili ng isang presyo sa anumang oras. Kung gusto mo ng mga sagot na mas mahaba sa 8,192 tokens sa parehong chat loop, pinapayagan ng DeepSeek-V4-Flash ang hanggang 32,768 output tokens bawat sagot na may 380K context; palitan ang model id ng deepseek- at walang ibang nagbabago sa loop.
Ang mas malalim na kuwento ng gastos ay nasa bakit mas mahal ang isang mahabang AI chat; ipinaliwanag ng input vs output tokens kung bakit magkahiwalay na naka-presyo ang dalawang panig.
Mabilisang pagsusuri
Ang iyong chat ay nasa turn 8. Ano ang nilalaman ng kahilingan para sa turn 8?
Ipakita ang sagot
Sagot: Ang system message at lahat ng naunang tanong at sagot, kasama ang pinakabagong tanong
Walang natatandaan ang API, kaya ang buong listahan ay lumalabas sa bawat pagkakataon. Iyon din ang dahilan kung bakit tumataas ang input tokens sa bawat turn.
Pinapanatiling kontrolado ang isang mahabang chat#
Hindi pwedeng lumaki nang walang hanggan ang listahan: kailangan itong magkasya sa context window ng modelo (tingnan ang ano ang context window), at ang bawat dagdag na turn ay may gastos sa input. Dalawang ugali ang nagpapanatili nitong maayos para sa isang prototype:
- Putulin ang pinakalumang mga turn. Panatilihin ang system message at ang huling ilang pares, halimbawa
messages = messages[:1] + messages[-bago ang bawat kahilingan. I-drop ang mga pares nang magkasama upang hindi kailanman mawalan ng sagot ang isang tanong.8:] - Magsimula ng bagong listahan para sa bagong paksa. Hindi kailangan ng bagong gawain ang kasaysayan ng luma.
Ang isang support bot na may pangmatagalang rule set ay parehong loop: ang system message ay nagtatakda ng mga patakaran nang isang beses, ang bawat user turn at tugon ay idinadagdag, at nagpuputol ka kapag bumibigat ang listahan. Para sa unang kahilingan mismo, tingnan ang ang iyong unang API request sa CheapTokens; ang listahan ng modelo at mga presyo ay nasa pricing page.


