Primeros pasosGuía
Chat multiturno con una API: reenviar el array de mensajes
El modelo no recuerda nada entre peticiones. Construye un bucle de chat en Python que reenvía el array de mensajes y observa cómo crecen los tokens de entrada.
En esta página
Tu segunda pregunta recibe una respuesta extraña porque la API nunca vio la primera. El modelo no conserva nada entre peticiones, así que un chat es algo que tú construyes: después de cada respuesta la añades a una lista llamada messages y envías la lista completa de nuevo. Ese es todo el truco, y abajo tienes un bucle de Python funcional contra la API compatible con OpenAI de CheapTokens.
Dos documentos oficiales describen lo mismo. La referencia de la API Messages de Anthropic (consultada el 30 de octubre de 2026) califica la API de sin estado y multiturno: los turnos anteriores viajan en el parámetro messages. La guía de generación de texto de OpenAI (consultada el 30 de octubre de 2026) indica que se mantiene el contexto enviando los turnos anteriores como mensajes etiquetados por rol y añadiendo cada respuesta antes de la siguiente petición.
Por qué la segunda pregunta recibe una mirada en blanco#
Supón que escribes What is a token?, lees la respuesta y luego escribes Explain it shorter. Para ti, "eso" es obvio. Para la API, la petición número dos es el mensaje de una línea de un desconocido: no hay "eso", nada que acortar. Recibirás una suposición o una pregunta de vuelta, no una explicación más corta.
La solución es hacer que la petición dos lleve todo lo que tenía la petición uno, más la respuesta, más la nueva pregunta. Compara las dos cargas útiles:
Comparar
Petición 2, con y sin historial
Sin historial
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
El modelo no tiene ni idea de qué es "eso".
Con historial
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
Ahora "eso" apunta a la primera respuesta.
Tres roles hacen todo el trabajo. system fija las reglas una vez (tono, longitud, para qué sirve el bot). user es lo que escribió la persona. assistant es lo que dijo el modelo antes. El modelo lee la lista de arriba abajo y escribe el siguiente mensaje assistant.
El bucle de chat en unas pocas líneas#
Instala el SDK con pip install openai y guarda tu clave en una variable de entorno, como en cómo almacenar una clave de API de forma segura. La URL base y el id del modelo vienen de la documentación de CheapTokens y de GET /v1/models (más en listar modelos para encontrar el id exacto). Para un bucle de aprendizaje, GLM-5.3-Flash encaja bien: 390K de contexto y hasta 8.192 tokens de salida por respuesta.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
Ejecútalo, pregunta What is a token? y luego Explain it shorter. La segunda respuesta ahora se refiere a la primera. La última línea imprime usage., el lado de entrada de la factura de ese turno; observa cómo sube con cada pregunta.
El orden dentro del bucle importa, y es la parte en la que los principiantes se equivocan más a menudo:
Poner en orden
Ordena un turno del bucle
Arrastra los elementos o usa las flechas
- Añade la pregunta del usuario a messages
- Envía la lista completa de messages
- Lee la respuesta de la respuesta
- Añade la respuesta como mensaje de assistant
Si te saltas el paso 4, el modelo olvida sus propias respuestas, así que "explícalo más corto" funciona una vez y luego vuelve a fallar en la tercera pregunta.
Cómo se ve la lista tras dos turnos#
Tras What is a token? y Explain it shorter, la lista que mantiene tu código tiene cinco entradas: la regla del sistema, la primera pregunta, la primera respuesta, la segunda pregunta, la segunda respuesta. La siguiente petición enviará las cinco más la tercera pregunta.
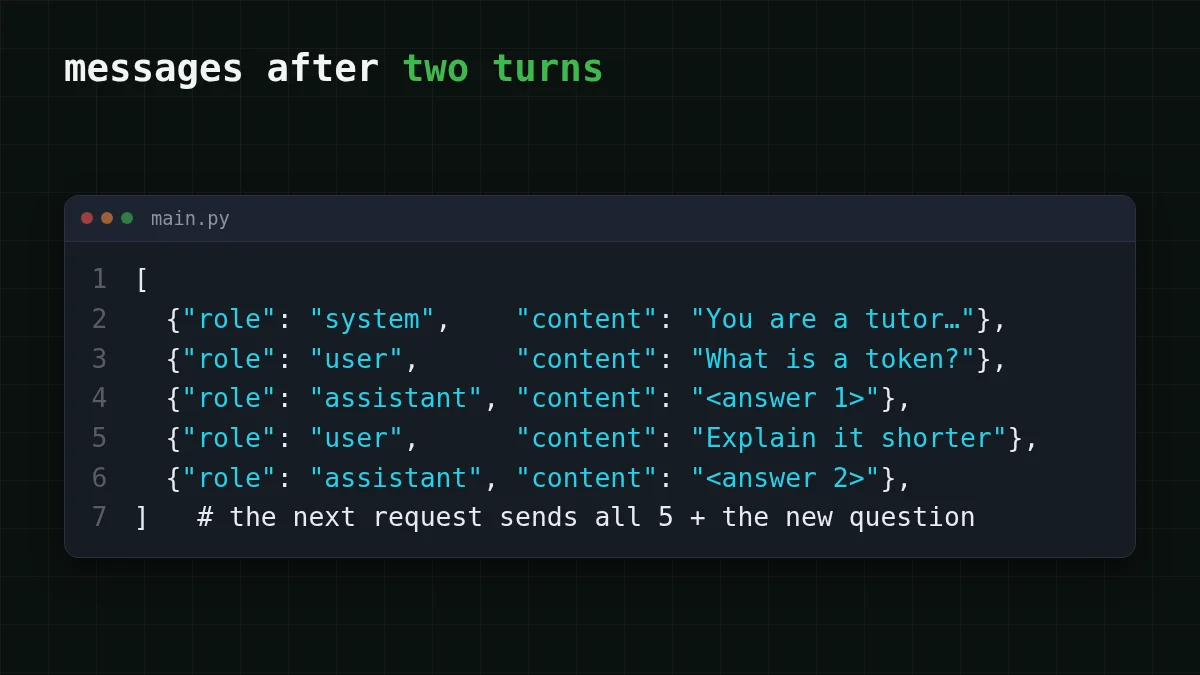
El mensaje de sistema se envía cada vez. La API no lo "conserva" por su lado; es simplemente el primer elemento de la lista. La guía de OpenAI (consultada el 30 de octubre de 2026) señala que las instrucciones se aplican solo a la petición actual, que es la misma idea desde el otro lado. Si quieres ajustar ese primer mensaje, consulta system prompt y temperatura explicados.
Qué pasa con los tokens de entrada a medida que crece el chat#
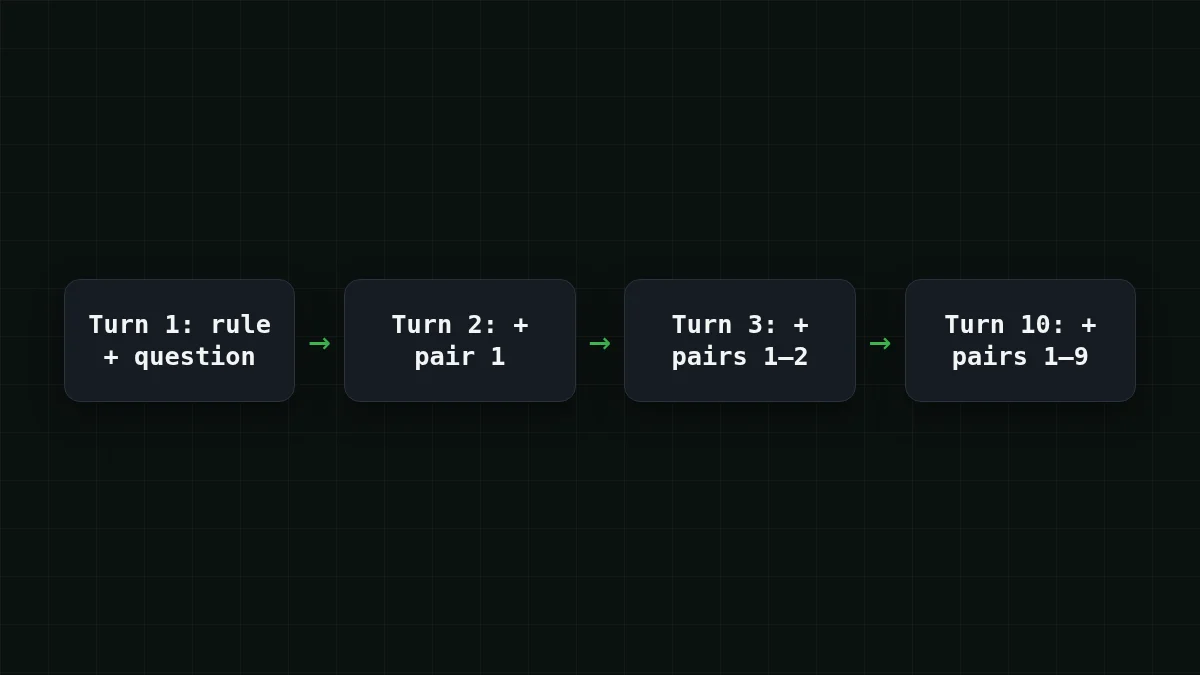
Cada petición paga de nuevo toda la lista como entrada. El turno 1 envía la regla del sistema y una pregunta; el turno 10 envía la regla, nueve pares pregunta-respuesta anteriores y la nueva pregunta. Así que la entrada crece con cada turno, aunque cada uno de tus mensajes sea corto.
Supón un chat de 10 turnos con estas suposiciones: la regla del sistema son unos 50 tokens, cada pregunta unos 150, cada respuesta unos 250. El turno 1 envía 50 + 150 = 200 tokens de entrada. Cada turno posterior añade un par más de 400 tokens (150 + 250 = 400), así que la entrada total a lo largo de diez turnos es 200 × 10 + 400 × 45 = 20.000 tokens, donde 45 es 0 + 1 + … + 9. La salida es 250 × 10 = 2.500 tokens. Diez mensajes tuyos, y la entrada es ocho veces la salida.
Aquí tienes todo ese chat con precios en tarifas en vivo, 20.000 tokens de entrada y 2.500 de salida:
| Modelo | Entrada $/1M | Salida $/1M | Costo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
20.000 tokens de entrada y 2500 tokens de salida en total. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
En el total, contando entrada y salida juntas, GLM-5.3-Flash y DeepSeek-V4-Flash cuestan aquí menos que en OpenRouter, y ambos mantienen un único precio a cualquier hora. Si quieres respuestas de más de 8.192 tokens en el mismo bucle de chat, DeepSeek-V4-Flash permite hasta 32.768 tokens de salida por respuesta con un contexto de 380K; cambia el id del modelo por deepseek- y nada más en el bucle cambia.
La historia más profunda de los costes está en por qué un chat de IA largo cuesta más; tokens de entrada vs salida explica por qué los dos lados se facturan por separado.
Verificación rápida
Tu chat está en el turno 8. ¿Qué contiene la petición del turno 8?
Mostrar respuesta
Respuesta: El mensaje de sistema y todas las preguntas y respuestas anteriores, más la pregunta más reciente
La API no recuerda nada, así que la lista completa sale cada vez. Por eso también suben los tokens de entrada turno tras turno.
Mantener bajo control un chat largo#
La lista no puede crecer para siempre: tiene que caber en la ventana de contexto del modelo (consulta qué es una ventana de contexto), y cada turno extra cuesta entrada. Dos hábitos la mantienen sensata para un prototipo:
- Recorta los turnos más antiguos. Conserva el mensaje de sistema y los últimos pares, por ejemplo
messages = messages[:1] + messages[-antes de cada petición. Elimina los pares juntos para que una pregunta nunca pierda su respuesta.8:] - Empieza una lista nueva para un tema nuevo. Una tarea nueva no necesita el historial de la anterior.
Un bot de soporte con un conjunto de reglas de larga vida es el mismo bucle: el mensaje de sistema fija las reglas una vez, cada turno de usuario y respuesta se añade, y recortas cuando la lista se vuelve pesada. Para la primera petición en sí, consulta tu primera petición a la API con CheapTokens; la lista de modelos y los precios están en la página de precios.


