API y SDKGuía
LangChain ChatOpenAI con un base_url personalizado: CheapTokens en Python
Apunta el ChatOpenAI de LangChain a CheapTokens: base_url, clave e id de modelo en Python, y luego invoke, streaming y uso de tokens por llamada.
En esta página
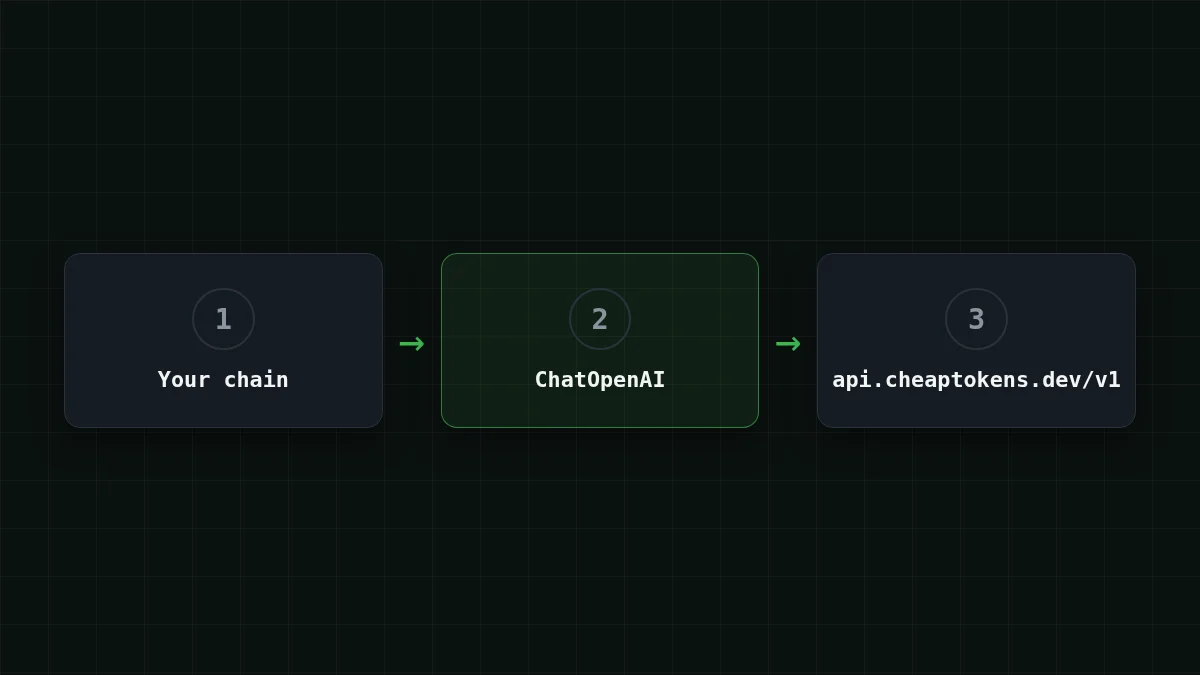
Ya tienes una cadena de LangChain que habla con ChatOpenAI, y quieres que se ejecute en otro endpoint sin reescribirla. Puedes: pasar tres argumentos, base_url, api_key y model, y el resto de la cadena queda igual. CheapTokens habla el protocolo OpenAI Chat Completions en https:/, así que ChatOpenAI funciona con él directamente.
Los pasos siguientes siguen la documentación de LangChain ChatOpenAI tal como se consultó el 27 de octubre de 2026. La página no muestra fecha ni versión, así que no fijo una versión de langchain-openai aquí: instala la última.
Paso a paso
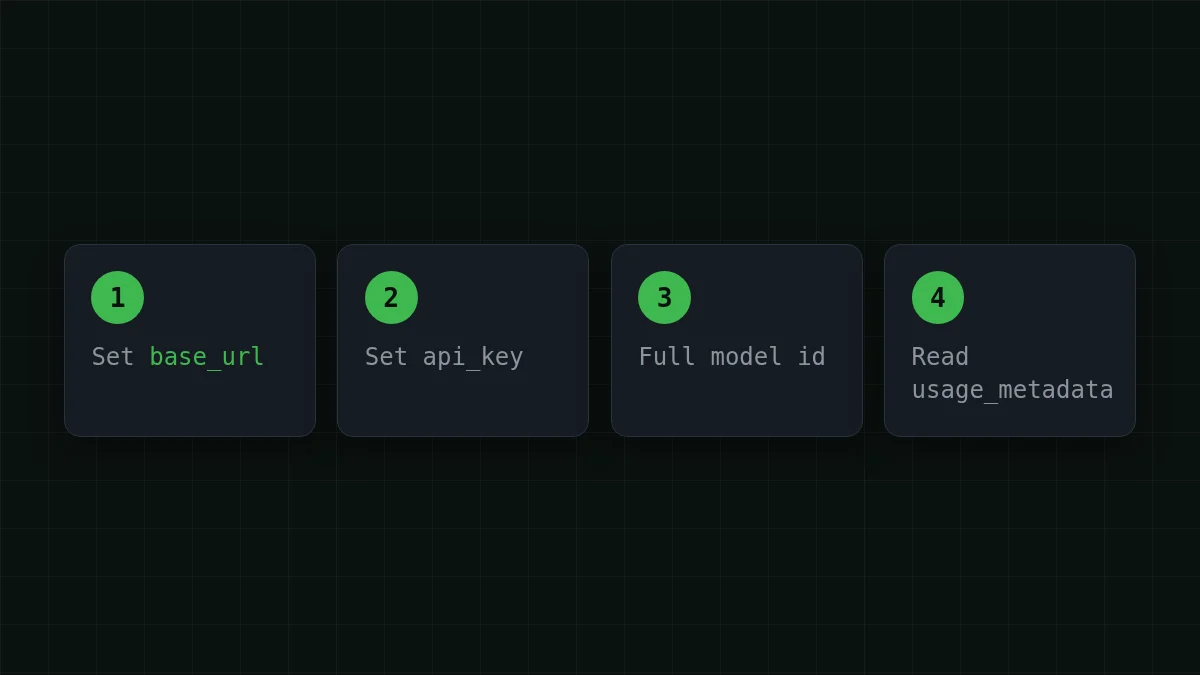
Conecta LangChain en tres pasos
Instalar
pip install -U langchain-openaiConfigurar la clave
Guarda la clave en una variable de entorno, no en el archivo:
export CHEAPTOKENS_API_KEY="your-key"Llamar al modelo
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
invoke() devuelve un mensaje; .content es el texto de la respuesta. Esa es toda la conexión. Consigue una clave y recarga el saldo en la documentación de CheapTokens.
Qué id de modelo va en model#
Usa el id completo, con el prefijo del desarrollador. Un nombre corto como deepseek- es lo que ves en las tablas de precios; la API acepta deepseek-. Los ids de la lista de modelos de CheapTokens:
deepseek-: contexto de 380K, hasta 32.768 tokens de salida por respuesta. Un buen valor por defecto para cadenas con documentos largos y respuestas largas.ai/ DeepSeek- V4- Flash- 0731 zai-: contexto de 390K, hasta 8.192 tokens de salida.org/ GLM- 5. 3- Flash MiniMaxAI/: contexto de 180K, hasta 8.192 tokens de salida.MiniMax- M2. 7
Cambiar es un cambio de una línea, porque el modelo es solo una cadena:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
Los tres comparten un mismo saldo, así que puedes probar cada uno en la misma cadena sin abrir nada nuevo. Los precios actuales están en la página de precios; para MiniMax-M2.7 la entrada es $0.05 y la salida $0.15 por 1M de tokens.
Configurar base_url mediante el entorno#
Si prefieres no tocar el código, LangChain lee la dirección del entorno. La documentación indica el orden de precedencia:
- el argumento
base_url(oopenai_api_base) que pasas en el código; OPENAI_API_BASE, que lee LangChain;OPENAI_BASE_URL, que lee el SDK deopenai.
Verificación rápida
Configuras base_url en el código y además exportas OPENAI_BASE_URL con otra dirección. ¿Cuál usa ChatOpenAI?
Mostrar respuesta
Respuesta: El argumento base_url en el código
El argumento explícito tiene la máxima prioridad, luego OPENAI_API_BASE, luego OPENAI_BASE_URL. Una variable olvidada en tu shell no redirigirá una llamada que configura base_url explícitamente.
Un efecto secundario de la misma página de documentación: cuando OPENAI_BASE_URL está configurado, LangChain deja stream_usage desactivado por defecto. Eso importa en las dos secciones siguientes.
Transmitir la respuesta en streaming#
Para una interfaz quieres el texto a medida que llega. stream() produce fragmentos, y cada fragmento tiene una pieza .content:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
Eso basta para una ventana de chat. Si además quieres el recuento de tokens al final de un stream, pasa stream_: ChatOpenAI(.. Esta guía cuenta los tokens desde invoke(), como en la sección siguiente. El streaming en el SDK de OpenAI sin más se trata en Respuestas en streaming en Python.
Leer el uso de tokens por llamada#
Cada mensaje devuelto por invoke() lleva usage_metadata con los tokens que usó la llamada:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
Suma estos valores a lo largo de un pipeline y tendrás un presupuesto por ejecución:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
La entrada y la salida se facturan por separado, así que conserva ambos números. Por qué existe esa división está en Tokens de entrada vs salida, y un rastreador completo con una protección de parada al alcanzar el presupuesto está en Rastrear el coste de tokens de un agente de IA en Python.
Cuánto cuesta al día un pipeline de LangChain#
Supón que ejecutas un bot de soporte con 2.000 tickets al día. Cada llamada envía el ticket más un prompt, unos 3.000 tokens, y la respuesta es de unos 500 tokens. En MiniMax-M2.7 una llamada así cuesta $0.00023. Mueve los controles a tus propios números; el sitio lo suma a los precios actuales:
Calculadora de costos
Un día del bot de soporte
Tokens de entrada por solicitud: 3000 · Tokens de salida por solicitud: 500 · Solicitudes por día: 2000
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
La calculadora muestra la suma diaria: en este tipo de llamada, la entrada es la mayor parte de los tokens y la salida la menor. Con CheapTokens el total, entrada y salida contadas juntas, sale por debajo del de OpenRouter, y el precio es el mismo a cualquier hora: no hay tarifas de hora punta que planificar.
Qué cubre esta guía#
El ejemplo usa chat completions sin más: invoke, stream y usage_metadata. ChatOpenAI sigue la especificación de OpenAI, así que el texto de la respuesta está en .content. Según la documentación de LangChain, cambia a la API Responses cuando usas herramientas integradas o el parámetro reasoning.
Si una llamada falla, la causa suele ser una de tres cosas: falta /v1 en base_url, un id de modelo corto en lugar del completo, o la variable de la clave no exportada en el shell que ejecuta Python. La lista de errores de conexión comunes muestra cómo se ve cada uno.
Siguiente paso: ejecuta el bloque de tres pasos de arriba con tu propia cadena, y luego prueba la misma cadena en endpoints compatibles con OpenAI con un id de modelo distinto.


