API e SDKGuida
LangChain ChatOpenAI con un base_url personalizzato: CheapTokens in Python
Punta il ChatOpenAI di LangChain su CheapTokens: base_url, chiave e id del modello in Python, poi invoke, streaming e uso dei token per chiamata.
In questa pagina
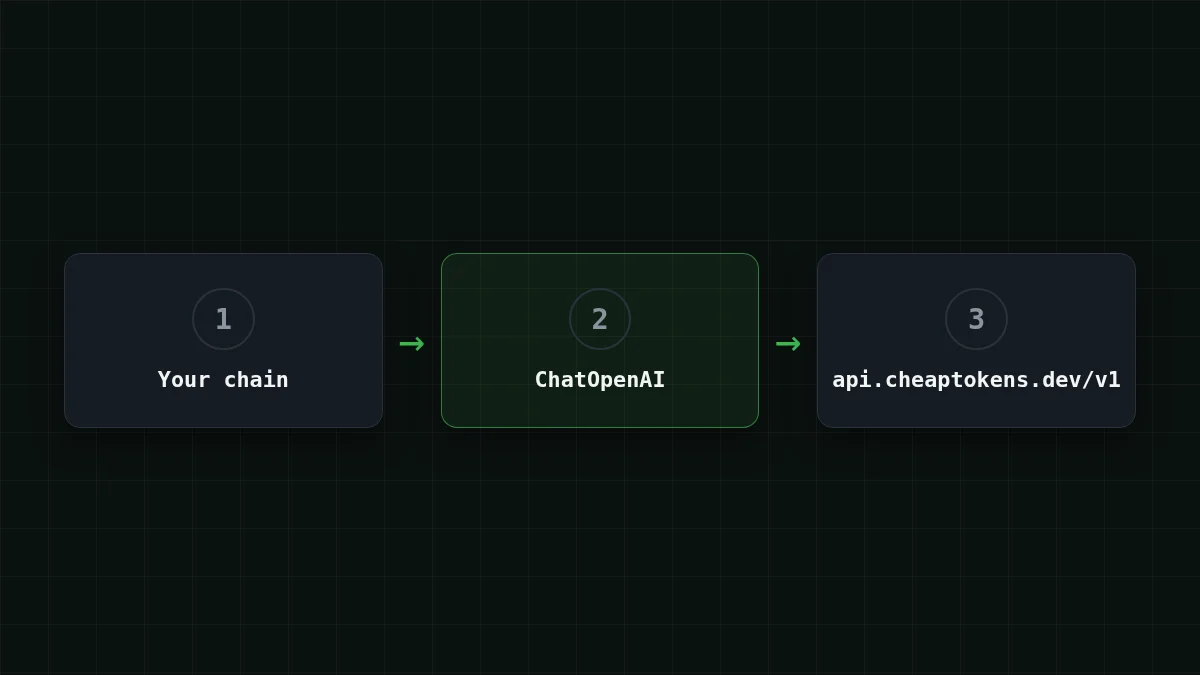
Hai già una chain LangChain che parla con ChatOpenAI e vuoi farla girare su un altro endpoint senza riscriverla. Puoi: passare tre argomenti, base_url, api_key e model, e il resto della chain resta com'è. CheapTokens parla il protocollo OpenAI Chat Completions su https:/, quindi ChatOpenAI funziona direttamente con esso.
I passaggi seguenti seguono la documentazione di LangChain ChatOpenAI verificata il 27 ottobre 2026. La pagina non mostra data né versione, quindi non fisso qui una release di langchain-openai: installa l'ultima.
Passo dopo passo
Collegare LangChain in tre passaggi
Installa
pip install -U langchain-openaiImposta la chiave
Tieni la chiave in una variabile d'ambiente, non nel file:
export CHEAPTOKENS_API_KEY="your-key"Chiama il modello
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
invoke() restituisce un messaggio; .content è il testo della risposta. La connessione è tutta qui. Ottieni una chiave e ricarica il saldo nella documentazione di CheapTokens.
Quale id di modello va in model#
Usa l'id completo, con il prefisso dello sviluppatore. Un nome breve come deepseek- è quello che vedi nelle tabelle dei prezzi; l'API accetta deepseek-. Gli id dalla lista modelli di CheapTokens:
deepseek-: contesto 380K, fino a 32.768 token di output per risposta. Un buon default per chain con documenti lunghi e risposte lunghe.ai/ DeepSeek- V4- Flash- 0731 zai-: contesto 390K, fino a 8.192 token di output.org/ GLM- 5. 3- Flash MiniMaxAI/: contesto 180K, fino a 8.192 token di output.MiniMax- M2. 7
Cambiare è una modifica da una riga, perché il modello è solo una stringa:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
Tutti e tre condividono un unico saldo, quindi puoi provarli sulla stessa chain senza aprire nulla di nuovo. I prezzi attuali sono sulla pagina dei prezzi; per MiniMax-M2.7 l'input è $0.05 e l'output $0.15 per 1M di token.
Impostare base_url tramite l'ambiente#
Se preferisci non toccare il codice, LangChain legge l'indirizzo dall'ambiente. La documentazione indica l'ordine di precedenza:
- l'argomento
base_url(oopenai_api_base) che passi nel codice; OPENAI_API_BASE, che LangChain legge;OPENAI_BASE_URL, che legge l'SDKopenai.
Verifica rapida
Imposti base_url nel codice ed esporti anche OPENAI_BASE_URL con un altro indirizzo. Quale usa ChatOpenAI?
Mostra risposta
Risposta: L'argomento base_url nel codice
L'argomento esplicito ha la priorità più alta, poi OPENAI_API_BASE, poi OPENAI_BASE_URL. Una variabile dimenticata nella tua shell non reindirizzerà una chiamata che imposta base_url esplicitamente.
Un effetto collaterale dalla stessa pagina di documentazione: quando OPENAI_BASE_URL è impostato, LangChain lascia stream_usage disattivato per default. Questo conta nelle due sezioni successive.
Streaming della risposta#
Per una UI vuoi il testo man mano che arriva. stream() restituisce chunk, e ogni chunk ha un pezzo .content:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
Basta per una finestra di chat. Se vuoi anche il conteggio dei token alla fine di uno stream, passa stream_: ChatOpenAI(.. Questa guida conta i token da invoke(), come nella sezione successiva. Lo streaming nel semplice SDK OpenAI è trattato in Streaming responses in Python.
Leggere l'uso dei token per chiamata#
Ogni messaggio restituito da invoke() porta usage_metadata con i token usati dalla chiamata:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
Somma questi valori lungo una pipeline e hai un budget per esecuzione:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
Input e output hanno prezzi separati, quindi tieni entrambi i numeri. Il motivo di questa separazione è in Input vs output tokens, e un tracker completo con un blocco allo sforamento del budget è in Track AI agent token cost in Python.
Quanto costa al giorno una pipeline LangChain#
Supponi di gestire un bot di supporto con 2.000 ticket al giorno. Ogni chiamata invia il ticket più un prompt, circa 3.000 token, e la risposta è di circa 500 token. Su MiniMax-M2.7 una chiamata del genere costa $0.00023. Sposta gli slider sui tuoi numeri; il sito somma ai prezzi attuali:
Calcolatore di costi
Un giorno del bot di supporto
Token di input per richiesta: 3000 · Token di output per richiesta: 500 · Richieste al giorno: 2000
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
Il calcolatore mostra la somma giornaliera: in questo tipo di chiamata, l'input è la parte preponderante dei token e l'output la parte minore. Con CheapTokens il totale, input e output contati insieme, risulta inferiore a quello di OpenRouter, e il prezzo è lo stesso a qualsiasi ora: non ci sono tariffe di punta da pianificare.
Cosa copre questa guida#
L'esempio usa semplici chat completions: invoke, stream e usage_metadata. ChatOpenAI segue la specifica OpenAI, quindi il testo della risposta è in .content. Secondo la documentazione di LangChain, passa alla Responses API quando usi tool integrati o il parametro reasoning.
Se una chiamata fallisce, la causa è di solito una di tre cose: /v1 mancante in base_url, un id di modello breve invece di quello completo, o la variabile della chiave non esportata nella shell che esegue Python. La lista degli errori di connessione comuni mostra come si presenta ciascuno.
Prossimo passo: esegui il blocco in tre passaggi qui sopra con la tua chain, poi prova la stessa chain su endpoint compatibili con OpenAI con un id di modello diverso.


