API وSDKدليل
LangChain ChatOpenAI مع base_url مخصص: CheapTokens في Python
وجّه ChatOpenAI من LangChain إلى CheapTokens: base_url والمفتاح ومعرّف النموذج في Python، ثم invoke والبث واستخدام الرموز لكل استدعاء.
في هذه الصفحة
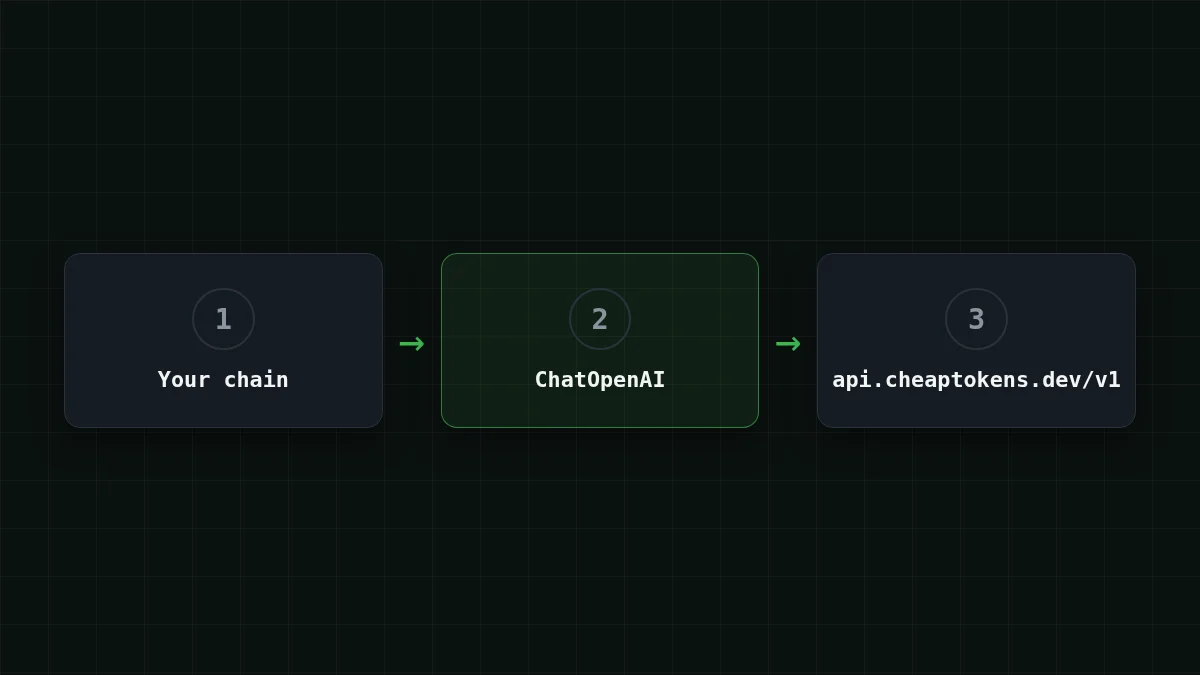
لديك بالفعل سلسلة LangChain تتحدث إلى ChatOpenAI، وتريد تشغيلها على نقطة نهاية أخرى دون إعادة كتابتها. يمكنك: تمرير ثلاث وسائط، base_url وapi_key وmodel، ويبقى باقي السلسلة كما هو. يتحدث CheapTokens بروتوكول OpenAI Chat Completions على https:/، لذا يعمل ChatOpenAI معه مباشرة.
تتبع الخطوات أدناه وثائق LangChain ChatOpenAI كما تم التحقق منها في 27 أكتوبر 2026. لا تُظهر الصفحة تاريخًا أو إصدارًا، لذا لا أحدد إصدار langchain-openai هنا: ثبّت الأحدث.
خطوة بخطوة
ربط LangChain في ثلاث خطوات
التثبيت
pip install -U langchain-openaiتعيين المفتاح
احتفظ بالمفتاح في متغير بيئة، لا في الملف:
export CHEAPTOKENS_API_KEY="your-key"استدعاء النموذج
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
يعيد invoke() رسالة؛ و.content هو نص الإجابة. هذا هو الاتصال بأكمله. احصل على مفتاح واشحن الرصيد في وثائق CheapTokens.
أي معرّف نموذج يوضع في model#
استخدم المعرّف الكامل، مع بادئة المطوّر. الاسم القصير مثل deepseek- هو ما تراه في جداول الأسعار؛ أما API فيأخذ deepseek-. المعرّفات من قائمة نماذج CheapTokens:
deepseek-: سياق 380K، وحتى 32,768 رمز إخراج لكل إجابة. خيار افتراضي جيد للسلاسل ذات المستندات الطويلة والإجابات الطويلة.ai/ DeepSeek- V4- Flash- 0731 zai-: سياق 390K، وحتى 8,192 رمز إخراج.org/ GLM- 5. 3- Flash MiniMaxAI/: سياق 180K، وحتى 8,192 رمز إخراج.MiniMax- M2. 7
التبديل تغيير سطر واحد، لأن النموذج مجرد نص:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
تتشارك الثلاثة رصيدًا واحدًا، لذا يمكنك تجربة كل منها على السلسلة نفسها دون فتح أي شيء جديد. الأسعار الحالية على صفحة الأسعار؛ بالنسبة إلى MiniMax-M2.7 فإن الإدخال $0.05 والإخراج $0.15 لكل 1M رمز.
تعيين base_url عبر البيئة#
إذا كنت تفضّل عدم لمس الكود، يقرأ LangChain العنوان من البيئة. توضح الوثائق ترتيب الأولوية:
- وسيطة
base_url(أوopenai_api_base) التي تمررها في الكود؛ OPENAI_API_BASE، التي يقرأها LangChain؛OPENAI_BASE_URL، التي يقرأها SDK الخاص بـopenai.
فحص سريع
عيّنت base_url في الكود وصدّرت أيضًا OPENAI_BASE_URL بعنوان آخر. أيّهما يستخدم ChatOpenAI؟
إظهار الإجابة
الإجابة: وسيطة base_url في الكود
للوسيطة الصريحة أعلى أولوية، ثم OPENAI_API_BASE، ثم OPENAI_BASE_URL. لن يعيد متغير منسي في shell الخاص بك توجيه استدعاء يعيّن base_url صراحةً.
أثر جانبي من صفحة الوثائق نفسها: عند تعيين OPENAI_BASE_URL، يترك LangChain stream_usage معطّلًا افتراضيًا. هذا مهم في القسمين التاليين.
بث الإجابة#
لواجهة مستخدم تريد النص أثناء وصوله. ينتج stream() أجزاء، ولكل جزء قطعة .content:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
هذا يكفي لنافذة محادثة. إذا أردت أيضًا عدد الرموز في نهاية البث، فمرّر stream_: ChatOpenAI(.. يحسب هذا الدليل الرموز من invoke()، كما في القسم التالي. البث في SDK OpenAI العادي مشمول في بث الاستجابات في Python.
قراءة استخدام الرموز لكل استدعاء#
كل رسالة يعيدها invoke() تحمل usage_metadata مع الرموز التي استخدمها الاستدعاء:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
اجمع هذه عبر خط أنابيب وستحصل على ميزانية لكل تشغيل:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
يُسعّر الإدخال والإخراج بشكل منفصل، لذا احتفظ بالرقمين. سبب هذا الفصل موجود في رموز الإدخال مقابل الإخراج، والمتتبع الكامل مع حارس التوقف عند الميزانية موجود في تتبع تكلفة رموز وكيل الذكاء الاصطناعي في Python.
كم يكلف خط أنابيب LangChain يوميًا#
لنفترض أنك تشغّل روبوت دعم بـ2,000 تذكرة يوميًا. يرسل كل استدعاء التذكرة مع مطالبة، نحو 3,000 رمز، والإجابة نحو 500 رمز. على MiniMax-M2.7 يكلف استدعاء واحد كهذا $0.00023. حرّك المنزلقات إلى أرقامك الخاصة؛ يجمعها الموقع بالأسعار الحالية:
حاسبة التكلفة
يوم واحد من روبوت الدعم
رموز الإدخال لكل طلب: 3,000 · رموز الإخراج لكل طلب: 500 · الطلبات يوميًا: 2,000
| النموذج | يوميًا | شهريًا |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
تُظهر الحاسبة المجموع اليومي: في هذا النوع من الاستدعاءات، الإدخال هو الجزء الأكبر من الرموز والإخراج الجزء الأصغر. مع CheapTokens يأتي الإجمالي، مع احتساب الإدخال والإخراج معًا، أقل من إجمالي OpenRouter، والسعر نفسه في أي ساعة: لا توجد أسعار وقت الذروة للتخطيط حولها.
ما يغطيه هذا الدليل#
يستخدم المثال إكمالات المحادثة العادية: invoke وstream وusage_metadata. يتبع ChatOpenAI مواصفات OpenAI، لذا يكون نص الإجابة في .content. وفقًا لوثائق LangChain، يتحول إلى Responses API عند استخدام الأدوات المدمجة أو وسيطة reasoning.
إذا فشل استدعاء، فالسبب عادةً واحد من ثلاثة: /v1 مفقود من base_url، أو معرّف نموذج قصير بدلًا من الكامل، أو متغير المفتاح غير المصدَّر في shell الذي يشغّل Python. تعرض قائمة أخطاء الاتصال الشائعة كيف يبدو كل منها.
الخطوة التالية: شغّل كتلة الخطوات الثلاث أعلاه مع سلسلتك الخاصة، ثم جرّب السلسلة نفسها على نقاط نهاية متوافقة مع OpenAI بمعرّف نموذج مختلف.


