API i SDKPrzewodnik
LangChain ChatOpenAI z własnym base_url: CheapTokens w Pythonie
Skieruj ChatOpenAI z LangChain na CheapTokens: base_url, klucz i id modelu w Pythonie, a potem invoke, strumieniowanie i zużycie tokenów na wywołanie.
Na tej stronie
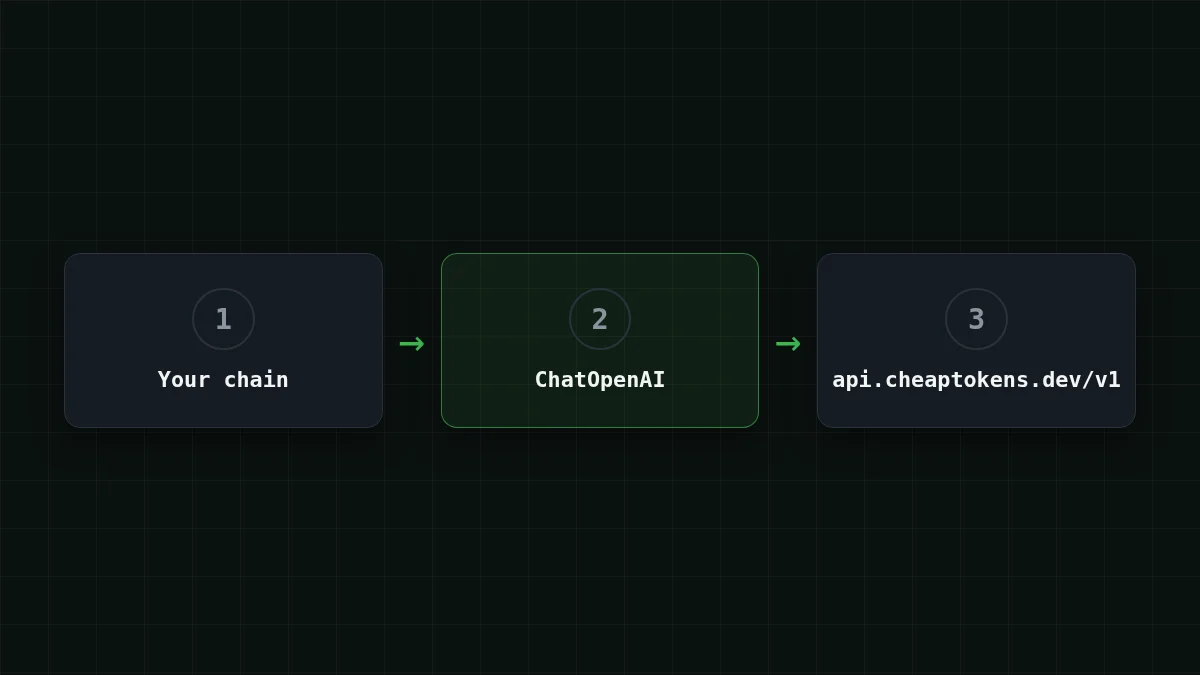
Masz już łańcuch LangChain, który rozmawia z ChatOpenAI, i chcesz, żeby działał na innym endpoincie bez przepisywania. Możesz: przekazać trzy argumenty, base_url, api_key i model, a reszta łańcucha zostaje bez zmian. CheapTokens obsługuje protokół OpenAI Chat Completions pod https:/, więc ChatOpenAI działa z nim bezpośrednio.
Poniższe kroki są zgodne z dokumentacją LangChain ChatOpenAI sprawdzoną 27 października 2026. Strona nie podaje daty ani wersji, więc nie przypinam tu wydania langchain-openai: zainstaluj najnowsze.
Krok po kroku
Podłącz LangChain w trzech krokach
Instalacja
pip install -U langchain-openaiUstaw klucz
Trzymaj klucz w zmiennej środowiskowej, a nie w pliku:
export CHEAPTOKENS_API_KEY="your-key"Wywołaj model
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
invoke() zwraca wiadomość; .content to tekst odpowiedzi. To całe połączenie. Zdobądź klucz i doładuj saldo w dokumentacji CheapTokens.
Które id modelu trafia do model#
Użyj pełnego id z prefiksem dewelopera. Krótka nazwa, jak deepseek-, to to, co widzisz w tabelach cen; API przyjmuje deepseek-. Identyfikatory z listy modeli CheapTokens:
deepseek-: kontekst 380K, do 32 768 tokenów wyjściowych na odpowiedź. Dobre ustawienie domyślne dla łańcuchów z długimi dokumentami i długimi odpowiedziami.ai/ DeepSeek- V4- Flash- 0731 zai-: kontekst 390K, do 8 192 tokenów wyjściowych.org/ GLM- 5. 3- Flash MiniMaxAI/: kontekst 180K, do 8 192 tokenów wyjściowych.MiniMax- M2. 7
Przełączenie to zmiana jednej linii, bo model to tylko ciąg znaków:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
Wszystkie trzy dzielą jedno saldo, więc możesz wypróbować każdy na tym samym łańcuchu bez otwierania czegokolwiek nowego. Aktualne ceny są na stronie z cennikiem; dla MiniMax-M2.7 wejście kosztuje $0.05, a wyjście $0.15 za 1M tokenów.
Ustawianie base_url przez środowisko#
Jeśli wolisz nie ruszać kodu, LangChain odczytuje adres ze środowiska. Dokumentacja podaje kolejność pierwszeństwa:
- argument
base_url(lubopenai_api_base), który przekazujesz w kodzie; OPENAI_API_BASE, które odczytuje LangChain;OPENAI_BASE_URL, które odczytuje SDKopenai.
Szybkie sprawdzenie
Ustawiasz base_url w kodzie i dodatkowo eksportujesz OPENAI_BASE_URL z innym adresem. Którego użyje ChatOpenAI?
Pokaż odpowiedź
Odpowiedź: Argumentu base_url w kodzie
Jawny argument ma najwyższy priorytet, potem OPENAI_API_BASE, a następnie OPENAI_BASE_URL. Zapomniana zmienna w powłoce nie przekieruje wywołania, które jawnie ustawia base_url.
Jeden efekt uboczny z tej samej strony dokumentacji: gdy OPENAI_BASE_URL jest ustawione, LangChain domyślnie pomija stream_usage. Ma to znaczenie w dwóch kolejnych sekcjach.
Strumieniowanie odpowiedzi#
W interfejsie chcesz tekst na bieżąco. stream() zwraca fragmenty, a każdy fragment ma część .content:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
To wystarczy do okna czatu. Jeśli chcesz też liczbę tokenów na końcu strumienia, przekaż stream_: ChatOpenAI(.. Ten przewodnik liczy tokeny z invoke(), jak w następnej sekcji. Strumieniowanie w zwykłym SDK OpenAI opisano w Strumieniowanie odpowiedzi w Pythonie.
Odczyt zużycia tokenów na wywołanie#
Każda wiadomość zwrócona przez invoke() niesie usage_metadata z tokenami zużytymi przez wywołanie:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
Zsumuj je w całym potoku, a masz budżet na jedno uruchomienie:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
Wejście i wyjście są wyceniane osobno, więc zachowaj obie liczby. Skąd bierze się ten podział, opisano w Tokeny wejściowe vs wyjściowe, a pełny tracker z zabezpieczeniem stop-at-budget jest w Śledzenie kosztu tokenów agenta AI w Pythonie.
Ile dziennie kosztuje potok LangChain#
Powiedzmy, że prowadzisz bota wsparcia z 2000 zgłoszeń dziennie. Każde wywołanie wysyła zgłoszenie plus prompt, około 3000 tokenów, a odpowiedź to około 500 tokenów. Na MiniMax-M2.7 jedno takie wywołanie kosztuje $0.00023. Przesuń suwaki na własne liczby; strona sumuje to po aktualnych cenach:
Kalkulator kosztów
Jeden dzień bota wsparcia
Tokeny wejściowe na żądanie: 3000 · Tokeny wyjściowe na żądanie: 500 · Żądania dziennie: 2000
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
Kalkulator pokazuje sumę dzienną: w tego rodzaju wywołaniu wejście to większość tokenów, a wyjście mniejsza część. W CheapTokens suma, licząc wejście i wyjście razem, wychodzi niższa niż w OpenRouter, a cena jest taka sama o każdej porze: nie ma stawek szczytowych, pod które trzeba planować.
Co obejmuje ten przewodnik#
Przykład używa zwykłych chat completions: invoke, stream i usage_metadata. ChatOpenAI jest zgodne ze specyfikacją OpenAI, więc tekst odpowiedzi jest w .content. Zgodnie z dokumentacją LangChain przełącza się na Responses API, gdy używasz wbudowanych narzędzi lub parametru reasoning.
Jeśli wywołanie się nie powiedzie, przyczyną jest zwykle jedna z trzech rzeczy: brak /v1 w base_url, krótkie id modelu zamiast pełnego albo nieeksportowana zmienna klucza w powłoce, która uruchamia Pythona. Lista typowych błędów połączenia pokazuje, jak wygląda każdy z nich.
Następny krok: uruchom powyższy blok trzech kroków z własnym łańcuchem, a potem wypróbuj ten sam łańcuch na endpointach zgodnych z OpenAI z innym id modelu.


