API at SDKGabay
LangChain ChatOpenAI na may custom na base_url: CheapTokens sa Python
Ituro ang ChatOpenAI ng LangChain sa CheapTokens: base_url, key at model id sa Python, pagkatapos i-invoke, i-stream at basahin ang token usage kada call.
Sa pahinang ito
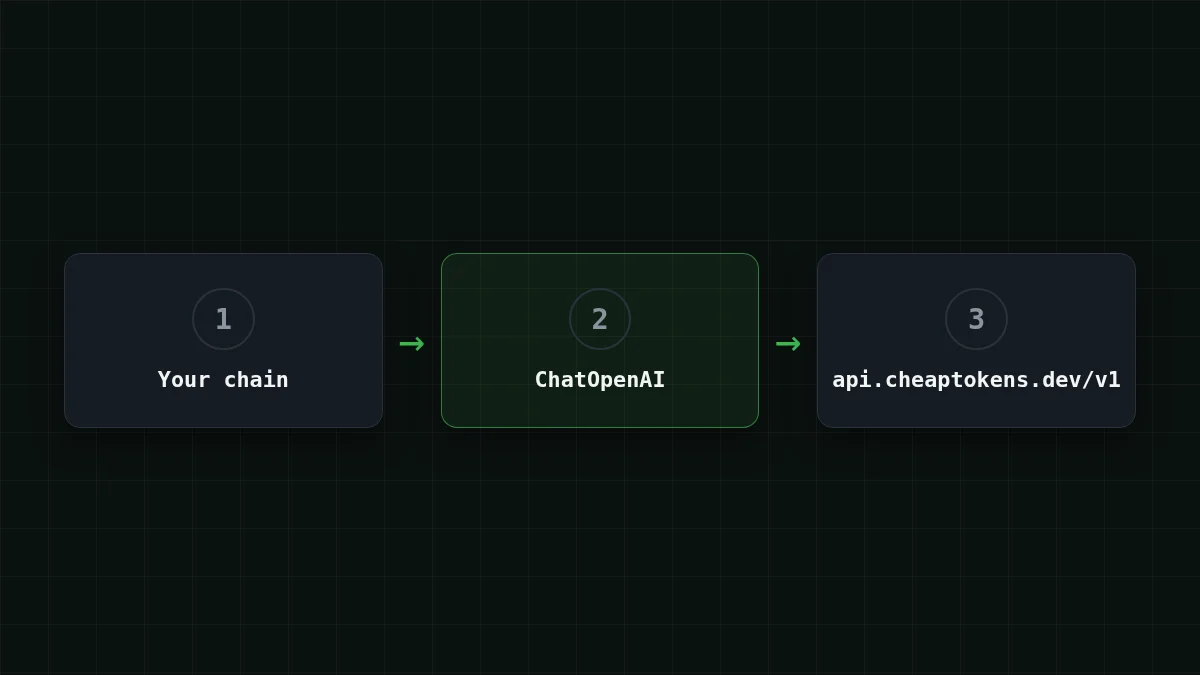
Mayroon ka nang LangChain chain na nakikipag-usap sa ChatOpenAI, at gusto mong patakbuhin ito sa ibang endpoint nang hindi ito nire-rewrite. Kaya mo: magpasa ng tatlong argumento, base_url, api_key at model, at mananatiling gaya ng dati ang natitirang bahagi ng chain. Nagsasalita ang CheapTokens ng OpenAI Chat Completions protocol sa https:/, kaya direktang gumagana ang ChatOpenAI dito.
Sinusunod ng mga hakbang sa ibaba ang LangChain ChatOpenAI docs na sinuri noong 27 Oktubre 2026. Walang petsa o bersyon ang page, kaya hindi ako nagpi-pin ng langchain-openai release dito: i-install ang pinakabago.
Hakbang-hakbang
Ikonekta ang LangChain sa tatlong hakbang
I-install
pip install -U langchain-openaiItakda ang key
Panatilihin ang key sa isang environment variable, hindi sa file:
export CHEAPTOKENS_API_KEY="your-key"Tawagin ang model
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
Nagbabalik ang invoke() ng mensahe; ang .content ang teksto ng sagot. Iyon na ang buong koneksyon. Kumuha ng key at mag-top up ng balanse sa CheapTokens docs.
Aling model id ang ilalagay sa model#
Gamitin ang buong id, kasama ang developer prefix. Ang maikling pangalan tulad ng deepseek- ang nakikita mo sa mga price table; tinatanggap ng API ang deepseek-. Ang mga id mula sa listahan ng modelo ng CheapTokens:
deepseek-: 380K context, hanggang 32,768 output tokens bawat sagot. Magandang default para sa mga chain na may mahahabang dokumento at mahahabang sagot.ai/ DeepSeek- V4- Flash- 0731 zai-: 390K context, hanggang 8,192 output tokens.org/ GLM- 5. 3- Flash MiniMaxAI/: 180K context, hanggang 8,192 output tokens.MiniMax- M2. 7
Isang linyang pagbabago lang ang paglipat, dahil string lang ang model:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
Nagbabahagi ang tatlo ng isang balanse, kaya masusubukan mo ang bawat isa sa parehong chain nang hindi nagbubukas ng bago. Nasa pricing page ang kasalukuyang presyo; para sa MiniMax-M2.7, ang input ay $0.05 at ang output ay $0.15 kada 1M tokens.
Pagtatakda ng base_url sa pamamagitan ng environment#
Kung ayaw mong galawin ang code, binabasa ng LangChain ang address mula sa environment. Ibinibigay ng docs ang pagkakasunod-sunod ng precedence:
- ang
base_url(oopenai_api_base) argument na ipinapasa mo sa code; - ang
OPENAI_API_BASE, na binabasa ng LangChain; - ang
OPENAI_BASE_URL, na binabasa ngopenaiSDK.
Mabilisang pagsusuri
Nagtakda ka ng base_url sa code at nag-export din ng OPENAI_BASE_URL na may ibang address. Alin ang gagamitin ng ChatOpenAI?
Ipakita ang sagot
Sagot: Ang base_url argument sa code
Ang tahasang argumento ang may pinakamataas na priority, pagkatapos ang OPENAI_API_BASE, pagkatapos ang OPENAI_BASE_URL. Hindi ma-redirect ng nakalimutang variable sa iyong shell ang isang call na tahasang nagtatakda ng base_url.
Isang side effect mula sa parehong docs page: kapag nakatakda ang OPENAI_BASE_URL, iniiwan ng LangChain na patay ang stream_usage bilang default. Mahalaga iyon sa susunod na dalawang seksyon.
Streaming ng sagot#
Para sa UI, gusto mo ang teksto habang dumarating ito. Nagbibigay ang stream() ng mga chunk, at bawat chunk ay may .content na piraso:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
Sapat na iyon para sa chat window. Kung gusto mo rin ang token count sa dulo ng stream, ipasa ang stream_: ChatOpenAI(.. Binibilang ng gabay na ito ang tokens mula sa invoke(), gaya ng sa susunod na seksyon. Saklaw ng Streaming responses in Python ang streaming sa plain OpenAI SDK.
Pagbasa ng token usage kada call#
Bawat mensaheng ibinabalik ng invoke() ay may usage_metadata kasama ang mga token na ginamit ng call:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
Pagsamahin ang mga ito sa buong pipeline at mayroon kang budget kada run:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
Hiwalay ang presyo ng input at output, kaya panatilihin ang parehong numero. Nasa Input vs output tokens kung bakit may ganitong paghahati, at nasa Track AI agent token cost in Python ang buong tracker na may stop-at-budget guard.
Magkano kada araw ang isang LangChain pipeline#
Sabihin nating nagpapatakbo ka ng support bot na may 2,000 ticket kada araw. Bawat call ay nagpapadala ng ticket kasama ang prompt, mga 3,000 tokens, at ang sagot ay mga 500 tokens. Sa MiniMax-M2.7, ang isang ganoong call ay nagkakahalaga ng $0.00023. Ilipat ang mga slider sa sarili mong numero; sinasuma ito ng site sa kasalukuyang presyo:
Calculator ng gastos
Isang araw ng support bot
Mga input token bawat kahilingan: 3,000 · Mga output token bawat kahilingan: 500 · Mga kahilingan bawat araw: 2,000
| Modelo | Bawat araw | Bawat buwan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
Ipinapakita ng calculator ang daily sum: sa ganitong uri ng call, ang input ang bumubuo ng malaking bahagi ng tokens at ang output ang mas maliit na bahagi. Sa CheapTokens, ang total, pinagsama ang input at output, ay mas mababa kaysa sa OpenRouter, at pareho ang presyo sa kahit anong oras: walang peak-time rates na kailangang planuhin.
Ano ang saklaw ng gabay na ito#
Gumagamit ang halimbawa ng plain chat completions: invoke, stream at usage_metadata. Sinusunod ng ChatOpenAI ang OpenAI spec, kaya nasa .content ang teksto ng sagot. Ayon sa docs ng LangChain, lumilipat ito sa Responses API kapag gumamit ka ng built-in tools o ng reasoning parameter.
Kung mabigo ang isang call, kadalasan isa sa tatlong bagay ang dahilan: kulang ang /v1 sa base_url, maikling model id ang ginamit sa halip na ang buo, o hindi na-export ang key variable sa shell na nagpapatakbo ng Python. Ipinapakita ng listahan ng common connection errors kung ano ang hitsura ng bawat isa.
Susunod na hakbang: patakbuhin ang three-step block sa itaas gamit ang sarili mong chain, pagkatapos subukan ang parehong chain sa OpenAI-compatible endpoints gamit ang ibang model id.


