API & SDKGuide
LangChain ChatOpenAI avec un base_url personnalisé : CheapTokens en Python
Pointez le ChatOpenAI de LangChain vers CheapTokens : base_url, clé et id de modèle en Python, puis invoke, streaming et usage de tokens par appel.
Sur cette page
Vous avez déjà une chaîne LangChain qui dialogue avec ChatOpenAI, et vous voulez qu'elle tourne sur un autre endpoint sans la réécrire. C'est possible : passez trois arguments, base_url, api_key et model, et le reste de la chaîne reste inchangé. CheapTokens parle le protocole OpenAI Chat Completions sur https:/, donc ChatOpenAI fonctionne directement avec.
Les étapes ci-dessous suivent la doc LangChain ChatOpenAI telle que vérifiée le 27 octobre 2026. La page n'affiche ni date ni version, je ne fige donc pas de release langchain-openai ici : installez la dernière.
Étape par étape
Connecter LangChain en trois étapes
Installer
pip install -U langchain-openaiDéfinir la clé
Gardez la clé dans une variable d'environnement, pas dans le fichier :
export CHEAPTOKENS_API_KEY="your-key"Appeler le modèle
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
invoke() renvoie un message ; .content est le texte de la réponse. C'est toute la connexion. Obtenez une clé et rechargez le solde dans la doc CheapTokens.
Quel id de modèle mettre dans model#
Utilisez l'id complet, avec le préfixe du développeur. Un nom court comme deepseek- est ce que vous voyez dans les tableaux de prix ; l'API attend deepseek-. Les ids de la liste de modèles CheapTokens :
deepseek-: contexte de 380K, jusqu'à 32 768 tokens de sortie par réponse. Un bon choix par défaut pour les chaînes avec de longs documents et de longues réponses.ai/ DeepSeek- V4- Flash- 0731 zai-: contexte de 390K, jusqu'à 8 192 tokens de sortie.org/ GLM- 5. 3- Flash MiniMaxAI/: contexte de 180K, jusqu'à 8 192 tokens de sortie.MiniMax- M2. 7
Changer de modèle tient en une ligne, car le modèle n'est qu'une chaîne :
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
Les trois partagent un même solde, vous pouvez donc essayer chacun sur la même chaîne sans rien ouvrir de nouveau. Les prix actuels sont sur la page tarifs ; pour MiniMax-M2.7, l'entrée est à $0.05 et la sortie à $0.15 par million de tokens.
Définir base_url via l'environnement#
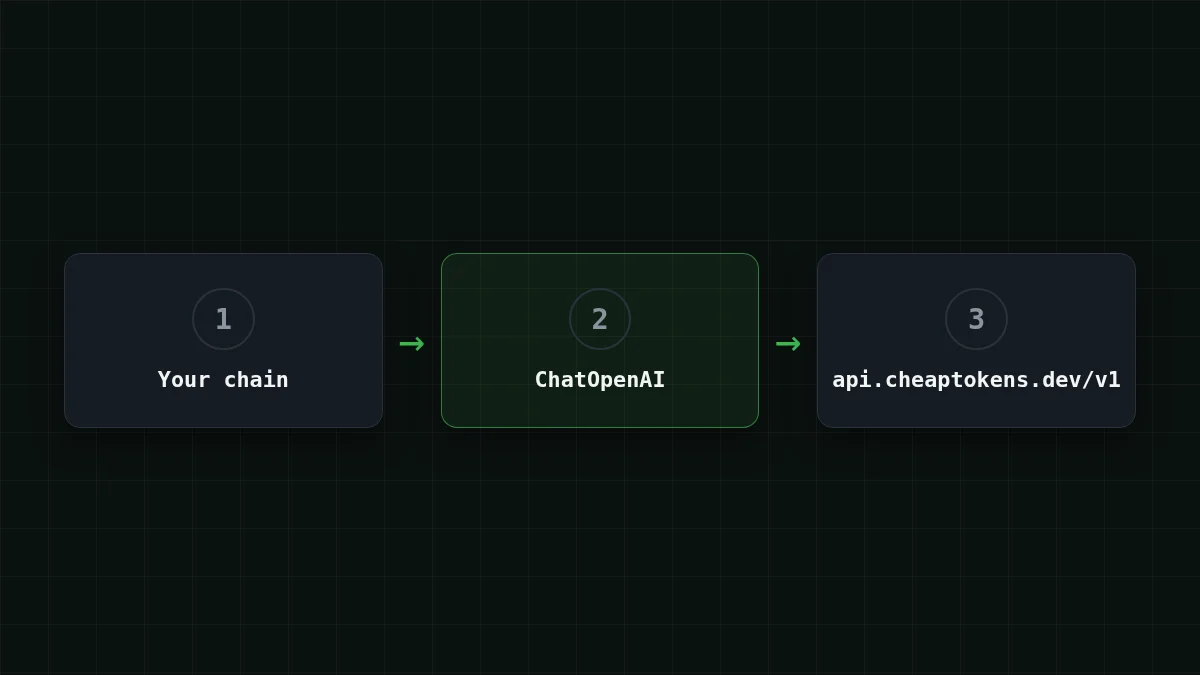
Si vous préférez ne pas toucher au code, LangChain lit l'adresse depuis l'environnement. La doc donne l'ordre de priorité :
- l'argument
base_url(ouopenai_api_base) que vous passez dans le code ; OPENAI_API_BASE, que LangChain lit ;OPENAI_BASE_URL, que lit le SDKopenai.
Vérification rapide
Vous définissez base_url dans le code et exportez aussi OPENAI_BASE_URL avec une autre adresse. Laquelle ChatOpenAI utilise-t-il ?
Afficher la réponse
Réponse: L'argument base_url dans le code
L'argument explicite a la priorité la plus haute, puis OPENAI_API_BASE, puis OPENAI_BASE_URL. Une variable oubliée dans votre shell ne détournera pas un appel qui définit base_url explicitement.
Un effet de bord issu de la même page de doc : quand OPENAI_BASE_URL est défini, LangChain laisse stream_usage désactivé par défaut. Cela compte dans les deux sections suivantes.
Diffuser la réponse en streaming#
Pour une UI, vous voulez le texte au fur et à mesure. stream() produit des chunks, et chaque chunk contient un morceau .content :
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
Cela suffit pour une fenêtre de chat. Si vous voulez aussi le nombre de tokens à la fin d'un stream, passez stream_ : ChatOpenAI(.. Ce guide compte les tokens depuis invoke(), comme dans la section suivante. Le streaming dans le SDK OpenAI simple est traité dans Streaming responses in Python.
Lire l'usage de tokens par appel#
Chaque message renvoyé par invoke() porte usage_metadata avec les tokens consommés par l'appel :
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
Additionnez-les sur un pipeline et vous obtenez un budget par exécution :
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
L'entrée et la sortie sont facturées séparément, gardez donc les deux nombres. La raison de cette séparation est expliquée dans Input vs output tokens, et un tracker complet avec garde-fou d'arrêt au budget se trouve dans Track AI agent token cost in Python.
Combien coûte un pipeline LangChain par jour#
Supposez un bot de support avec 2 000 tickets par jour. Chaque appel envoie le ticket plus un prompt, environ 3 000 tokens, et la réponse fait environ 500 tokens. Sur MiniMax-M2.7, un tel appel coûte $0.00023. Déplacez les curseurs vers vos propres chiffres ; le site calcule le total aux prix actuels :
Calculateur de coût
Une journée du bot de support
Tokens d'entrée par requête: 3 000 · Tokens de sortie par requête: 500 · Requêtes par jour: 2 000
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
Le calculateur affiche le total journalier : dans ce type d'appel, l'entrée constitue le gros des tokens et la sortie la plus petite part. Avec CheapTokens, le total, entrée et sortie comptées ensemble, ressort inférieur à celui d'OpenRouter, et le prix est le même à toute heure : pas de tarifs de pointe à anticiper.
Ce que couvre ce guide#
L'exemple utilise de simples chat completions : invoke, stream et usage_metadata. ChatOpenAI suit la spec OpenAI, donc le texte de la réponse est dans .content. D'après la doc LangChain, il bascule sur l'API Responses quand vous utilisez des outils intégrés ou le paramètre reasoning.
Si un appel échoue, la cause est généralement l'une de trois choses : /v1 absent de base_url, un id de modèle court au lieu du complet, ou la variable de clé non exportée dans le shell qui lance Python. La liste des erreurs de connexion courantes montre à quoi ressemble chacune.
Étape suivante : exécutez le bloc en trois étapes ci-dessus avec votre propre chaîne, puis essayez la même chaîne sur des endpoints compatibles OpenAI avec un autre id de modèle.


