API और SDKगाइड
कस्टम base_url के साथ LangChain ChatOpenAI: Python में CheapTokens
LangChain के ChatOpenAI को CheapTokens पर इंगित करें: Python में base_url, key और model id, फिर invoke, streaming और प्रति call token usage।
इस पृष्ठ पर
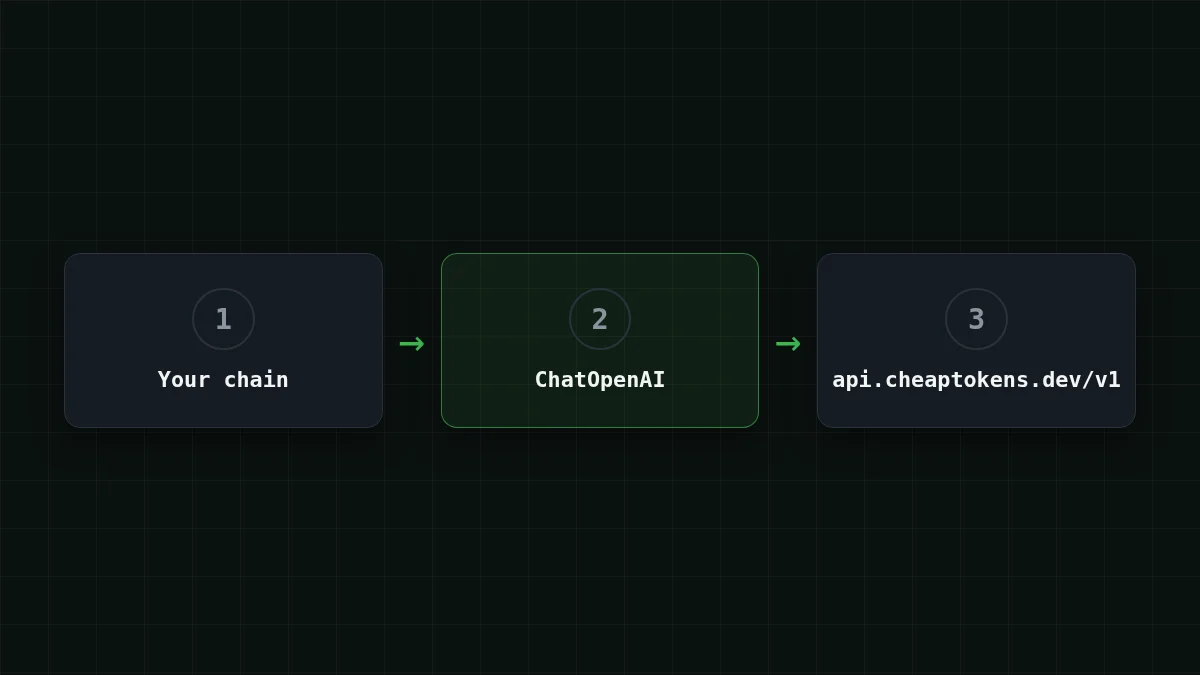
आपके पास पहले से एक LangChain chain है जो ChatOpenAI से बात करती है, और आप चाहते हैं कि यह बिना दोबारा लिखे किसी दूसरे endpoint पर चले। आप कर सकते हैं: तीन arguments पास करें, base_url, api_key और model, और बाकी chain जैसी है वैसी ही रहती है। CheapTokens https:/ पर OpenAI Chat Completions protocol बोलता है, इसलिए ChatOpenAI इसके साथ सीधे काम करता है।
नीचे दिए गए चरण LangChain ChatOpenAI docs का पालन करते हैं, जैसा 27 अक्टूबर 2026 को जाँचा गया। पेज पर कोई तारीख या version नहीं दिखता, इसलिए मैं यहाँ कोई langchain-openai release pin नहीं करता: नवीनतम इंस्टॉल करें।
चरण दर चरण
तीन चरणों में LangChain कनेक्ट करें
इंस्टॉल करें
pip install -U langchain-openaikey सेट करें
key को environment variable में रखें, फ़ाइल में नहीं:
export CHEAPTOKENS_API_KEY="your-key"model को कॉल करें
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
invoke() एक message लौटाता है; .content उत्तर का टेक्स्ट है। बस इतना ही कनेक्शन है। key प्राप्त करें और balance टॉप अप करें CheapTokens docs में।
model में कौन सा model id जाता है#
पूरा id उपयोग करें, developer prefix के साथ। deepseek- जैसा छोटा नाम वही है जो आपको price tables में दिखता है; API deepseek- लेता है। CheapTokens model list से ids:
deepseek-: 380K context, प्रति उत्तर अधिकतम 32,768 output tokens। लंबे दस्तावेज़ों और लंबे उत्तरों वाली chains के लिए अच्छा default।ai/ DeepSeek- V4- Flash- 0731 zai-: 390K context, अधिकतम 8,192 output tokens।org/ GLM- 5. 3- Flash MiniMaxAI/: 180K context, अधिकतम 8,192 output tokens।MiniMax- M2. 7
स्विच करना एक पंक्ति का बदलाव है, क्योंकि model बस एक string है:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
तीनों एक ही balance साझा करते हैं, इसलिए आप बिना कुछ नया खोले हर एक को उसी chain पर आज़मा सकते हैं। मौजूदा कीमतें pricing page पर हैं; MiniMax-M2.7 के लिए input $0.05 और output $0.15 प्रति 1M tokens है।
environment के ज़रिए base_url सेट करना#
अगर आप code को छूना नहीं चाहते, तो LangChain environment से address पढ़ता है। docs precedence का क्रम देते हैं:
base_url(याopenai_api_base) argument जो आप code में पास करते हैं;OPENAI_API_BASE, जिसे LangChain पढ़ता है;OPENAI_BASE_URL, जिसेopenaiSDK पढ़ता है।
त्वरित जाँच
आप code में base_url सेट करते हैं और साथ ही OPENAI_BASE_URL को किसी दूसरे address के साथ export करते हैं। ChatOpenAI कौन सा उपयोग करेगा?
उत्तर दिखाएँ
उत्तर: code में base_url argument
explicit argument की सर्वोच्च प्राथमिकता है, फिर OPENAI_API_BASE, फिर OPENAI_BASE_URL। आपके shell में भूला हुआ variable उस call को redirect नहीं करेगा जो base_url स्पष्ट रूप से सेट करती है।
उसी docs पेज से एक side effect: जब OPENAI_BASE_URL सेट होता है, तो LangChain stream_usage को default रूप से बंद छोड़ देता है। यह अगले दो sections में मायने रखता है।
उत्तर को stream करना#
UI के लिए आपको टेक्स्ट आते-आते चाहिए। stream() chunks देता है, और हर chunk में एक .content टुकड़ा होता है:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
यह chat window के लिए काफ़ी है। अगर आप stream के अंत में token count भी चाहते हैं, तो stream_ पास करें: ChatOpenAI(.। यह गाइड invoke() से tokens गिनता है, जैसा अगले section में है। सादे OpenAI SDK में streaming Streaming responses in Python में शामिल है।
प्रति call token usage पढ़ना#
invoke() से लौटाया गया हर message usage_metadata लेकर आता है, जिसमें call द्वारा उपयोग किए गए tokens होते हैं:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
इन्हें पूरी pipeline में जोड़ लें और आपके पास प्रति-run budget हो जाता है:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
Input और output की कीमत अलग-अलग है, इसलिए दोनों संख्याएँ रखें। यह विभाजन क्यों है, यह Input vs output tokens में है, और budget पर रुकने वाले guard के साथ पूरा tracker Track AI agent token cost in Python में है।
एक LangChain pipeline का प्रति दिन खर्च#
मान लें आप एक support bot चलाते हैं जिसमें प्रतिदिन 2,000 tickets हैं। हर call ticket और एक prompt भेजती है, लगभग 3,000 tokens, और उत्तर लगभग 500 tokens का है। MiniMax-M2.7 पर ऐसी एक call की लागत $0.00023 है। sliders को अपनी संख्याओं पर ले जाएँ; साइट इसे मौजूदा कीमतों पर जोड़ती है:
लागत कैलकुलेटर
support bot का एक दिन
प्रति अनुरोध इनपुट टोकन: 3,000 · प्रति अनुरोध आउटपुट टोकन: 500 · प्रति दिन अनुरोध: 2,000
| मॉडल | प्रति दिन | प्रति माह |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
calculator दैनिक योग दिखाता है: इस तरह की call में, input tokens का बड़ा हिस्सा है और output छोटा हिस्सा। CheapTokens के साथ कुल, input और output मिलाकर, OpenRouter से कम आता है, और कीमत किसी भी घंटे एक जैसी है: peak-time rates की योजना बनाने की ज़रूरत नहीं।
यह गाइड क्या कवर करती है#
उदाहरण सादे chat completions का उपयोग करता है: invoke, stream और usage_metadata। ChatOpenAI OpenAI spec का पालन करता है, इसलिए उत्तर का टेक्स्ट .content में है। LangChain के docs के अनुसार, जब आप built-in tools या reasoning parameter का उपयोग करते हैं तो यह Responses API पर स्विच हो जाता है।
अगर कोई call विफल होती है, तो कारण आमतौर पर तीन में से एक होता है: base_url में /v1 गायब है, पूरे id के बजाय छोटा model id, या key variable उस shell में export नहीं है जो Python चलाता है। common connection errors सूची दिखाती है कि हर एक कैसा दिखता है।
अगला कदम: ऊपर दिए तीन-चरण वाले block को अपनी chain के साथ चलाएँ, फिर उसी chain को OpenAI-compatible endpoints पर किसी दूसरे model id के साथ आज़माएँ।


