API ve SDKKılavuz
Özel base_url ile LangChain ChatOpenAI: Python'da CheapTokens
LangChain'in ChatOpenAI'ını CheapTokens'a yönlendirin: Python'da base_url, anahtar ve model kimliği, ardından invoke, akış ve çağrı başına token kullanımı.
Bu sayfada
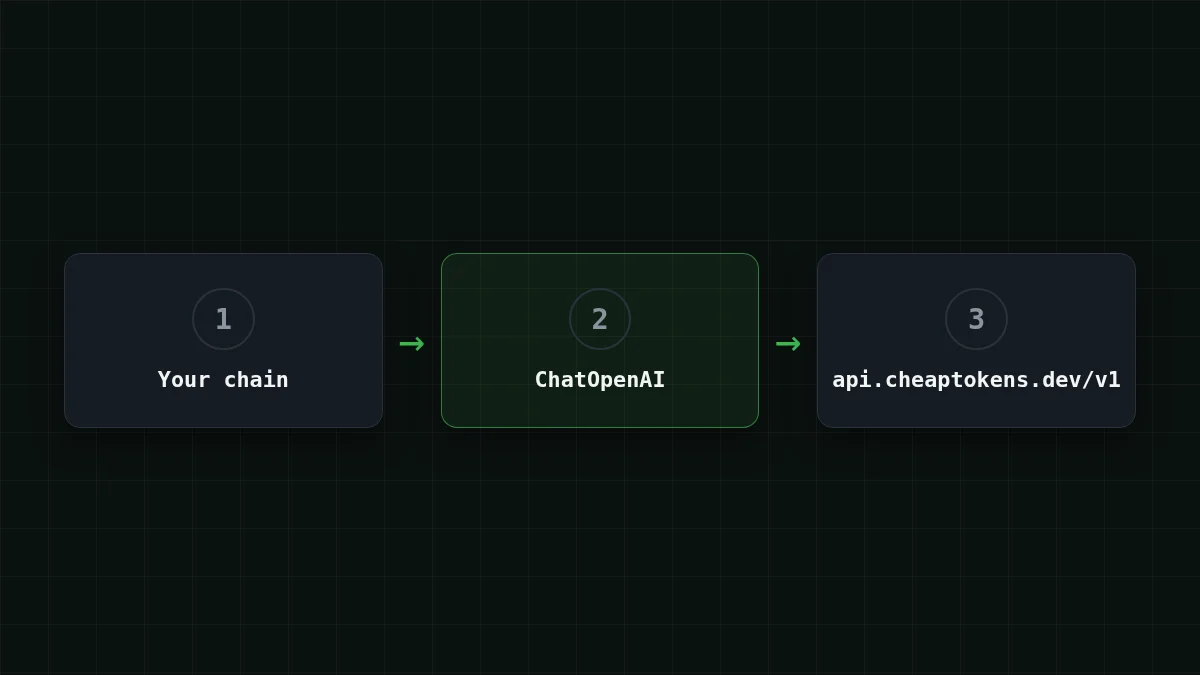
Zaten ChatOpenAI ile konuşan bir LangChain zinciriniz var ve onu yeniden yazmadan başka bir uç noktada çalıştırmak istiyorsunuz. Şunları yapabilirsiniz: üç argüman geçirin, base_url, api_key ve model, zincirin geri kalanı olduğu gibi kalır. CheapTokens, https:/ adresinde OpenAI Chat Completions protokolünü konuşur, bu yüzden ChatOpenAI doğrudan onunla çalışır.
Aşağıdaki adımlar, 27 Ekim 2026 itibarıyla kontrol edilen LangChain ChatOpenAI belgelerini izler. Sayfada tarih veya sürüm belirtilmiyor, bu yüzden burada bir langchain-openai sürümü sabitlemiyorum: en son sürümü kurun.
Adım adım
LangChain'i üç adımda bağlayın
Kurulum
pip install -U langchain-openaiAnahtarı ayarlayın
Anahtarı dosyada değil, bir ortam değişkeninde tutun:
export CHEAPTOKENS_API_KEY="your-key"Modeli çağırın
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
invoke() bir mesaj döndürür; .content yanıt metnidir. Bağlantı bundan ibaret. CheapTokens belgelerinden bir anahtar alın ve bakiyeyi yükleyin.
model içine hangi model kimliği girer#
Geliştirici önekiyle birlikte tam kimliği kullanın. deepseek- gibi kısa bir ad, fiyat tablolarında gördüğünüz şeydir; API deepseek- alır. CheapTokens model listesindeki kimlikler:
deepseek-: 380K bağlam, yanıt başına en fazla 32.768 çıktı token'ı. Uzun belgeler ve uzun yanıtlar içeren zincirler için iyi bir varsayılan.ai/ DeepSeek- V4- Flash- 0731 zai-: 390K bağlam, en fazla 8.192 çıktı token'ı.org/ GLM- 5. 3- Flash MiniMaxAI/: 180K bağlam, en fazla 8.192 çıktı token'ı.MiniMax- M2. 7
Geçiş yapmak tek satırlık bir değişikliktir, çünkü model yalnızca bir dizedir:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
Üçü de tek bir bakiyeyi paylaşır, böylece yeni bir şey açmadan her birini aynı zincirde deneyebilirsiniz. Güncel fiyatlar fiyatlandırma sayfasındadır; MiniMax-M2.7 için 1M token başına giriş $0.05 ve çıkış $0.15'dir.
base_url'yi ortam üzerinden ayarlama#
Koda dokunmak istemiyorsanız, LangChain adresi ortamdan okur. Belgeler öncelik sırasını verir:
- kodda geçirdiğiniz
base_url(veyaopenai_api_base) argümanı; - LangChain'in okuduğu
OPENAI_API_BASE; openaiSDK'sının okuduğuOPENAI_BASE_URL.
Hızlı kontrol
Kodda base_url ayarlıyorsunuz ve ayrıca başka bir adresle OPENAI_BASE_URL dışa aktarıyorsunuz. ChatOpenAI hangisini kullanır?
Cevabı göster
Cevap: Koddaki base_url argümanını
Açık argüman en yüksek önceliğe sahiptir, ardından OPENAI_API_BASE, sonra OPENAI_BASE_URL gelir. Kabuğunuzda unutulmuş bir değişken, base_url'yi açıkça ayarlayan bir çağrıyı yönlendirmez.
Aynı belge sayfasından bir yan etki: OPENAI_BASE_URL ayarlandığında, LangChain stream_usage öğesini varsayılan olarak kapalı bırakır. Bu, sonraki iki bölümde önemlidir.
Yanıtı akış olarak alma#
Bir kullanıcı arayüzü için metni geldikçe istersiniz. stream() parçalar üretir ve her parçanın bir .content kısmı vardır:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
Bu bir sohbet penceresi için yeterlidir. Bir akışın sonunda token sayısını da istiyorsanız, stream_ geçirin: ChatOpenAI(.. Bu kılavuz, sonraki bölümde olduğu gibi, token'ları invoke() üzerinden sayar. Düz OpenAI SDK'sında akış, Python'da akış yanıtları bölümünde ele alınmıştır.
Çağrı başına token kullanımını okuma#
invoke() tarafından döndürülen her mesaj, çağrının kullandığı token'larla birlikte usage_metadata taşır:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
Bunları bir işlem hattı boyunca toplayın, çalıştırma başına bir bütçeniz olur:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
Giriş ve çıkış ayrı fiyatlandırılır, bu yüzden her iki sayıyı da tutun. Bu ayrımın neden var olduğu Giriş ve çıkış token'ları bölümünde, bütçede durma koruması olan tam bir izleyici ise Python'da AI ajanı token maliyetini izleme bölümündedir.
Bir LangChain işlem hattının günlük maliyeti#
Diyelim ki günde 2.000 bilet işleyen bir destek botu çalıştırıyorsunuz. Her çağrı bileti artı bir istemi, yaklaşık 3.000 token gönderir ve yanıt yaklaşık 500 token'dır. MiniMax-M2.7 üzerinde böyle bir çağrı $0.00023 tutar. Kaydırıcıları kendi sayılarınıza taşıyın; site bunu güncel fiyatlarla toplar:
Maliyet hesaplayıcı
Destek botunun bir günü
İstek başına giriş token'ı: 3.000 · İstek başına çıkış token'ı: 500 · Günlük istek sayısı: 2.000
| Model | Günlük | Aylık |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
Hesaplayıcı günlük toplamı gösterir: bu tür bir çağrıda token'ların büyük kısmı giriştir, çıkış ise daha küçük kısımdır. CheapTokens ile toplam, giriş ve çıkış birlikte sayıldığında, OpenRouter'ınkinden daha düşük çıkar ve fiyat her saat aynıdır: planlama yapmanız gereken yoğun saat ücretleri yoktur.
Bu kılavuzun kapsamı#
Örnek düz sohbet tamamlamalarını kullanır: invoke, stream ve usage_metadata. ChatOpenAI OpenAI spesifikasyonunu izler, bu yüzden yanıt metni .content içindedir. LangChain'in belgelerine göre, yerleşik araçları veya reasoning parametresini kullandığınızda Responses API'sine geçer.
Bir çağrı başarısız olursa, nedeni genellikle üç şeyden biridir: base_url içinde /v1 eksik olması, tam kimlik yerine kısa bir model kimliği kullanılması veya Python'u çalıştıran kabukta anahtar değişkeninin dışa aktarılmamış olması. Yaygın bağlantı hataları listesi her birinin nasıl göründüğünü gösterir.
Sonraki adım: yukarıdaki üç adımlı bloğu kendi zincirinizle çalıştırın, ardından aynı zinciri farklı bir model kimliğiyle OpenAI uyumlu uç noktalar üzerinde deneyin.


