API e SDKGuia
LangChain ChatOpenAI com base_url personalizado: CheapTokens em Python
Aponte o ChatOpenAI do LangChain para o CheapTokens: base_url, chave e id de modelo em Python, depois invoke, streaming e uso de tokens por chamada.
Nesta página
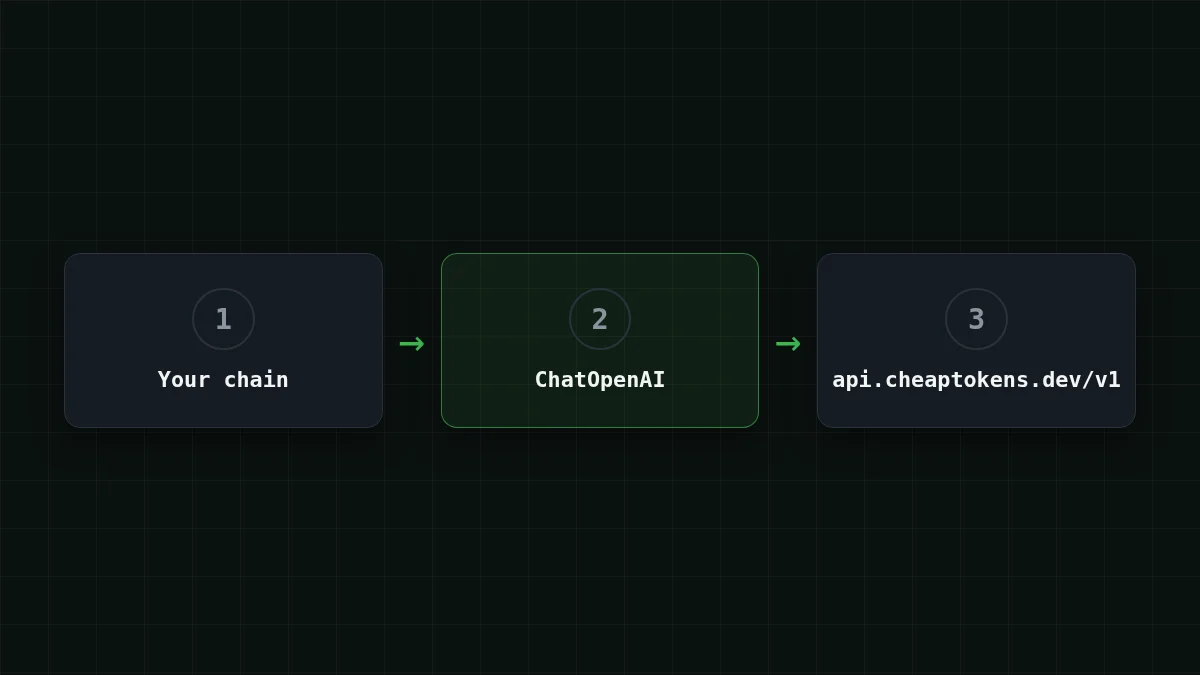
Você já tem uma chain do LangChain que conversa com ChatOpenAI e quer que ela rode em outro endpoint sem reescrevê-la. Você pode: passar três argumentos, base_url, api_key e model, e o resto da chain permanece como está. O CheapTokens fala o protocolo OpenAI Chat Completions em https:/, então ChatOpenAI funciona com ele diretamente.
Os passos abaixo seguem a documentação do LangChain ChatOpenAI conforme verificada em 27 de outubro de 2026. A página não mostra data nem versão, então não fixo uma release do langchain-openai aqui: instale a mais recente.
Passo a passo
Conecte o LangChain em três passos
Instalar
pip install -U langchain-openaiDefinir a chave
Mantenha a chave em uma variável de ambiente, não no arquivo:
export CHEAPTOKENS_API_KEY="your-key"Chamar o modelo
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
invoke() retorna uma mensagem; .content é o texto da resposta. Essa é toda a conexão. Obtenha uma chave e recarregue o saldo na documentação do CheapTokens.
Qual id de modelo vai em model#
Use o id completo, com o prefixo do desenvolvedor. Um nome curto como deepseek- é o que você vê nas tabelas de preço; a API aceita deepseek-. Os ids da lista de modelos do CheapTokens:
deepseek-: contexto de 380K, até 32.768 tokens de saída por resposta. Um bom padrão para chains com documentos longos e respostas longas.ai/ DeepSeek- V4- Flash- 0731 zai-: contexto de 390K, até 8.192 tokens de saída.org/ GLM- 5. 3- Flash MiniMaxAI/: contexto de 180K, até 8.192 tokens de saída.MiniMax- M2. 7
Trocar é uma mudança de uma linha, porque o modelo é só uma string:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
Os três compartilham um único saldo, então você pode testar cada um na mesma chain sem abrir nada novo. Os preços atuais estão na página de preços; para o MiniMax-M2.7 a entrada é $0.05 e a saída $0.15 por 1M de tokens.
Definindo base_url pelo ambiente#
Se você preferir não mexer no código, o LangChain lê o endereço do ambiente. A documentação dá a ordem de precedência:
- o argumento
base_url(ouopenai_api_base) que você passa no código; OPENAI_API_BASE, que o LangChain lê;OPENAI_BASE_URL, que o SDKopenailê.
Verificação rápida
Você define base_url no código e também exporta OPENAI_BASE_URL com outro endereço. Qual o ChatOpenAI usa?
Mostrar resposta
Resposta: O argumento base_url no código
O argumento explícito tem a maior prioridade, depois OPENAI_API_BASE, depois OPENAI_BASE_URL. Uma variável esquecida no seu shell não vai redirecionar uma chamada que define base_url explicitamente.
Um efeito colateral da mesma página da documentação: quando OPENAI_BASE_URL está definido, o LangChain deixa stream_usage desligado por padrão. Isso importa nas próximas duas seções.
Fazendo streaming da resposta#
Para uma UI você quer o texto conforme ele chega. stream() gera chunks, e cada chunk tem um trecho em .content:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
Isso basta para uma janela de chat. Se você também quer a contagem de tokens no fim de um stream, passe stream_: ChatOpenAI(.. Este guia conta tokens a partir de invoke(), como na próxima seção. Streaming no SDK OpenAI puro é abordado em Streaming de respostas em Python.
Lendo o uso de tokens por chamada#
Toda mensagem retornada por invoke() carrega usage_metadata com os tokens que a chamada usou:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
Some isso ao longo de um pipeline e você tem um orçamento por execução:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
Entrada e saída têm preços separados, então guarde os dois números. Por que essa divisão existe está em Tokens de entrada vs saída, e um rastreador completo com guarda de parada no orçamento está em Rastrear o custo de tokens de agentes de IA em Python.
Quanto custa por dia um pipeline LangChain#
Digamos que você rode um bot de suporte com 2.000 tickets por dia. Cada chamada envia o ticket mais um prompt, cerca de 3.000 tokens, e a resposta tem cerca de 500 tokens. No MiniMax-M2.7 uma chamada dessas custa $0.00023. Mova os sliders para os seus próprios números; o site soma com os preços atuais:
Calculadora de custos
Um dia do bot de suporte
Tokens de entrada por solicitação: 3.000 · Tokens de saída por solicitação: 500 · Solicitações por dia: 2.000
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
A calculadora mostra a soma diária: nesse tipo de chamada, a entrada é a maior parte dos tokens e a saída a menor. Com o CheapTokens o total, entrada e saída somadas, fica abaixo do OpenRouter, e o preço é o mesmo em qualquer horário: não há tarifas de horário de pico para planejar.
O que este guia cobre#
O exemplo usa chat completions simples: invoke, stream e usage_metadata. ChatOpenAI segue a especificação da OpenAI, então o texto da resposta está em .content. Segundo a documentação do LangChain, ele muda para a Responses API quando você usa ferramentas embutidas ou o parâmetro reasoning.
Se uma chamada falhar, a causa costuma ser uma de três coisas: /v1 ausente em base_url, um id de modelo curto em vez do completo, ou a variável da chave não exportada no shell que executa o Python. A lista de erros comuns de conexão mostra como cada um aparece.
Próximo passo: rode o bloco de três passos acima com a sua própria chain, depois teste a mesma chain em endpoints compatíveis com OpenAI com um id de modelo diferente.


