Como funciona um agente de IA: o loop, executado sem chave de API
Um agente de IA é um loop: o modelo pede uma ferramenta, seu código a executa, o resultado volta. Rode uma demo em Python sem chave e depois aponte para um modelo real.
Nesta página
Você pede a um agente de código para corrigir um erro de digitação e observa o log rolar: ler um arquivo, buscar, ler outro arquivo, editar, rodar os testes. Um pedido pequeno, uma dúzia de chamadas ao modelo. De onde elas vêm?
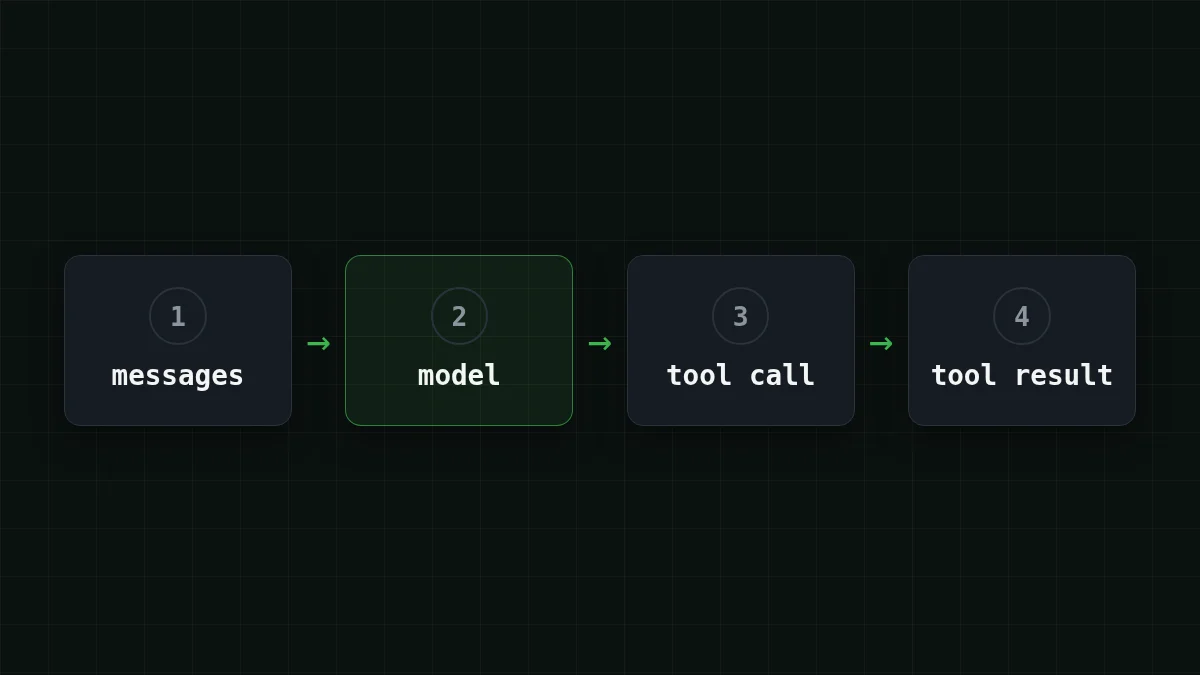
Um agente de IA é um loop. Seu programa envia a conversa ao modelo; o modelo ou responde ou pede uma ferramenta ("leia este arquivo"); seu programa executa a ferramenta, adiciona o resultado à conversa e chama o modelo de novo. Isso se repete até o modelo responder em texto simples. Agentes de código como Claude Code, Codex e o modo agente do Cursor são construídos em torno desse mesmo loop, com mais ferramentas e mais cuidado. Abaixo você vai rodar uma versão de 40 linhas sem chave nenhuma e depois apontá-la para um modelo real.
O loop em uma imagem#
Pense em um gerente que não pode tocar em nada. O gerente só escreve bilhetes: "por favor, traga-me todo.txt". Um assistente (seu programa) vai até a estante, traz o arquivo e o coloca na mesa. O gerente lê e escreve o próximo bilhete, ou a resposta final.
Esse é o truque inteiro. O modelo nunca abre um arquivo nem executa um comando. Ele escreve texto que diz qual ferramenta chamar e com quais argumentos. Seu código faz o trabalho e reporta de volta. Se você já viu function calling, é o mesmo mecanismo, repetido até a tarefa terminar.
Você consegue colocar uma volta do loop na ordem certa?
Colocar em ordem
Coloque uma volta do loop do agente em ordem
Arraste os itens ou use as setas
- Envie a tarefa e a lista de ferramentas ao modelo
- O modelo responde com uma chamada de ferramenta, não com texto
- Seu programa executa essa ferramenta
- O resultado entra em messages como uma mensagem "tool"
- O modelo é chamado de novo com o resultado, até responder em texto simples
Rode sem chave#
Digamos que a tarefa seja: "Quantos itens há em todo.txt?". A ferramenta é uma função read_file que procura em um pequeno dicionário em vez de um disco. E em vez de um modelo real há um modelo roteirizado que sempre faz as mesmas duas coisas: pede o arquivo e depois responde. Isso basta para ver cada peça em movimento. Salve como agent_loop.py (Python 3.10+, apenas biblioteca padrão):
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
Rode python agent_. Sem LLM_API_KEY no seu ambiente você recebe o modelo roteirizado, e a tela mostra exatamente duas voltas:
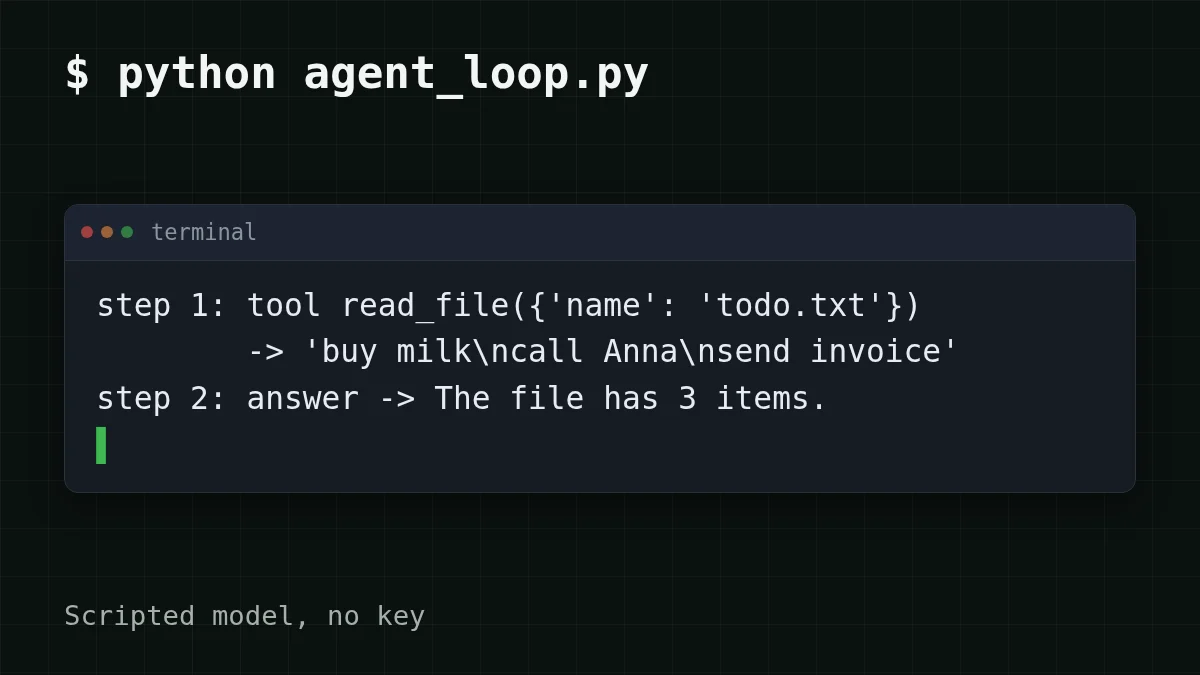
Observe três linhas, porque elas contêm a ideia inteira:
messages.mantém o turno do próprio modelo. Pule isso, e a próxima chamada conterá um resultado de ferramenta que responde a um pedido que a API nunca viu; a maioria das APIs rejeita isso com um 400.append(reply) argumentschega como uma string JSON, então passa porjson.loadsantes de você chamar a função.max_stepsé o freio de emergência. Um modelo pode pedir ferramentas para sempre, então todo agente real tem um limite como esse.
Aponte o mesmo loop para um modelo real#
Só uma coisa muda: quem interpreta o modelo. O script lê três variáveis de ambiente e, se houver uma chave, envia o mesmo messages para um endpoint compatível com OpenAI. O endereço da CheapTokens é https:/ (compatível com OpenAI Chat Completions e Anthropic Messages), e o id do modelo precisa ser o completo da documentação: deepseek-.
Rode o loop de três formas
Sem chave
python agent_loop.pyO modelo roteirizado faz as duas voltas. Nada sai da sua máquina.
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
Uma janela de contexto de 380K e até 32.768 tokens de saída por resposta: espaço para um loop longo.
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
Um modelo leve com janela de contexto de 390K para uma primeira execução de um loop de várias etapas.
O que você deve ver é a mesma forma de antes: step 1: tool read_, depois step 2: answer -, com uma linha usage: sob cada chamada ao modelo. O texto da resposta vai diferir do roteirizado, e um modelo falante pode dar uma volta extra. Isso é normal: o modelo decide, o loop apenas obedece. Mantenha a chave fora do próprio script; uma variável de ambiente é o lugar seguro (aqui está como armazená-la).
As linhas usage: são a parte útil. Some os números in de uma execução mais longa e você verá para onde o dinheiro vai.
Por que cada volta custa mais que a anterior#
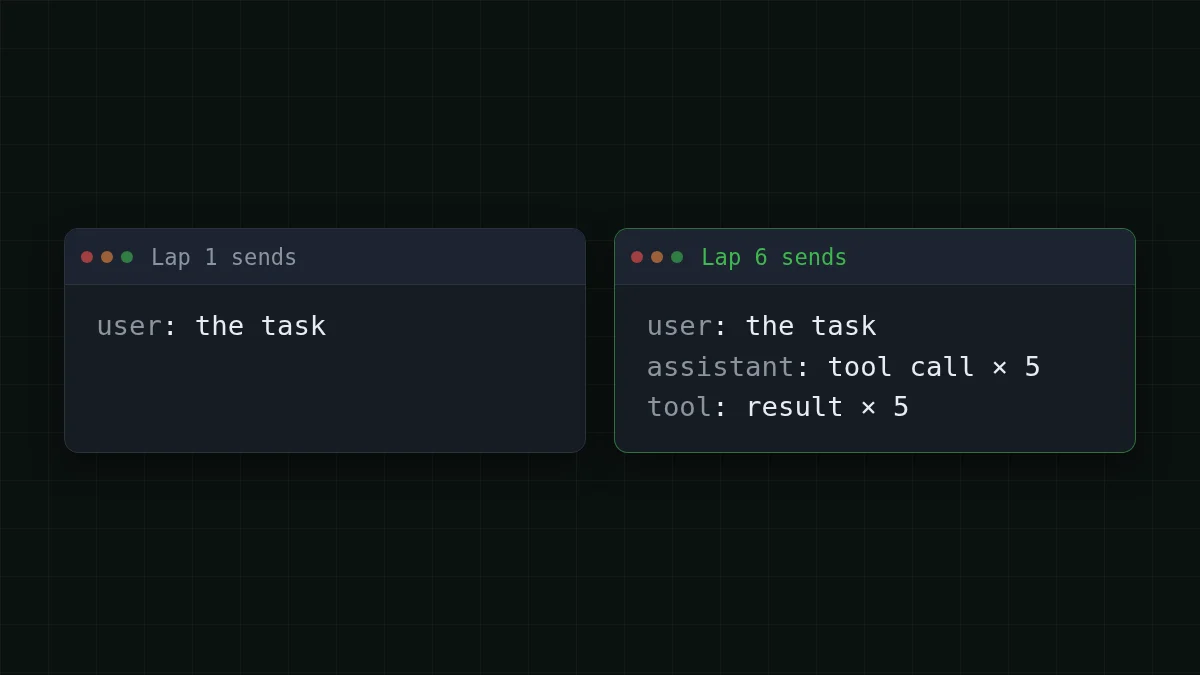
O modelo não lembra de nada entre chamadas. Cada volta envia a lista messages inteira de novo: a tarefa, cada chamada de ferramenta anterior, cada resultado de ferramenta. (A mesma regra torna um chat longo caro; chat multi-turno mostra isso em uma conversa simples.)
A volta 1 envia uma mensagem. Se o loop continuar, a volta 6 envia onze.
Digamos que uma tarefa real leve 10 voltas. Ela começa com cerca de 2.000 tokens (instruções, lista de ferramentas, seu pedido), cada volta adiciona cerca de 1.500 (um resultado de ferramenta mais a nota do modelo), e o modelo escreve cerca de 300 tokens por volta. A volta 1 envia 2.000, a volta 2 envia 3.500, a volta 10 envia 15.500. A soma da primeira parte é 10 × 2.000 = 20.000 tokens; o crescimento adiciona 1.500 × 45 = 67.500 (45 é 0+1+…+9), então a entrada ao longo da tarefa é 20.000 + 67.500 = 87.500 tokens. A saída é 10 × 300 = 3.000 tokens.
O texto da tarefa em si tem algumas frases, mas o lado da entrada é de 87.500 tokens. A $0.015 por 1M de tokens de entrada, a tarefa inteira no DeepSeek-V4-Flash sai por $0.0016. Aqui está a mesma carga entre os modelos, com o OpenRouter como referência. No total, contando entrada e saída juntas, a CheapTokens sai mais barata que o OpenRouter nesta carga:
| Modelo | Entrada $/1M | Saída $/1M | Custo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
87.500 tokens de entrada e 3.000 tokens de saída no total. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Um preço único a qualquer hora do dia também ajuda aqui: um agente que roda de madrugada custa o mesmo que um ao meio-dia, e você pode ver todos os preços na página de preços. Para um dia dessas tarefas, mova os controles:
Calculadora de custos
Um dia: 20 tarefas de 10 voltas cada
Tokens de entrada por solicitação: 8.750 · Tokens de saída por solicitação: 300 · Solicitações por dia: 200
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
Os campos são por chamada ao modelo: 8.750 é a entrada média de uma volta do exemplo acima (87.500 ÷ 10), e 200 chamadas são 20 tarefas × 10 voltas. É por isso que as contas de agentes giram em torno do histórico, não da pergunta. O exemplo de 20 passos aprofunda o mesmo efeito.
Verificação rápida
A volta 3 de um loop de agente custa mais que a volta 1, embora você não tenha pedido nada novo. Por quê?
Mostrar resposta
Resposta: A lista de mensagens agora contém duas chamadas de ferramenta e dois resultados, e tudo isso é enviado de novo
A API é sem estado. Cada chamada carrega o histórico completo, então os tokens de entrada crescem a cada volta enquanto a saída permanece mais ou menos igual.
Para onde ir a partir das 40 linhas#
O script acima é um esboço para aprender. Se você quer a versão longa, há um curso aberto no GitHub, justxor/agent-harness-course (README em russo, verificado em 31 de outubro de 2026). É Python 3.10+ puro, sem dependências, o código é licenciado sob MIT, o texto sob CC BY 4.0. Após clonar, python examples/ roda o loop offline com um modelo roteirizado, e python - roda seus 19 testes sem rede. O curso continua com compactação de contexto, memória, subagentes, aprovação humana de ações arriscadas e rastreamento de custos. Para um modelo real ele lê LLM_PROVIDER, LLM_MODEL, LLM_API_KEY e, para endpoints compatíveis com OpenAI, LLM_BASE_URL: pegue o valor exato de LLM_PROVIDER no README dele.
Quando o loop funcionar, o próximo passo é uma chave real e uma tarefa real: a documentação tem um primeiro pedido em um minuto, e o DeepSeek-V4-Flash é um bom modelo para rodar o loop.


