AI入門ガイド
AIエージェントの仕組み:APIキーなしで実行するループ
AIエージェントはループです:モデルがツールを要求し、あなたのコードがそれを実行し、結果が戻ります。キー不要のPythonデモを実行し、その後で実際のモデルに向けてみましょう。
コーディングエージェントにタイポを1つ直すよう頼むと、ログが流れていくのが見えます。ファイルを読み、検索し、別のファイルを読み、編集し、テストを実行する。小さなリクエスト1つに、十数回のモデル呼び出し。これらはどこから来るのでしょうか?
AIエージェントはループです。あなたのプログラムが会話をモデルに送り、モデルは答えるか、ツール(「このファイルを読んで」)を要求します。あなたのプログラムがツールを実行し、結果を会話に追加して、再びモデルを呼び出します。モデルがプレーンテキストで答えるまで、これが繰り返されます。Claude Code、Codex、Cursorのエージェントモードのようなコーディングエージェントは、この同じループを中心に、より多くのツールとより多くの注意を払って構築されています。以下では、キーを一切使わずに40行のバージョンを実行し、その後で実際のモデルに向けてみます。
ループを一枚の絵で#
何も触れないマネージャーを想像してください。マネージャーはメモを書くだけです。「todo.txtを持ってきてください」。アシスタント(あなたのプログラム)が棚に行き、ファイルを持ってきて机の上に置きます。マネージャーはそれを読み、次のメモか最終的な答えを書きます。
これがすべての仕掛けです。モデルは決してファイルを開いたりコマンドを実行したりしません。モデルはどのツールをどの引数で呼ぶかを書いたテキストを出力します。あなたのコードが実際の作業を行い、報告を返します。function callingを見たことがあれば、これは同じ仕組みを、仕事が終わるまで繰り返すだけです。
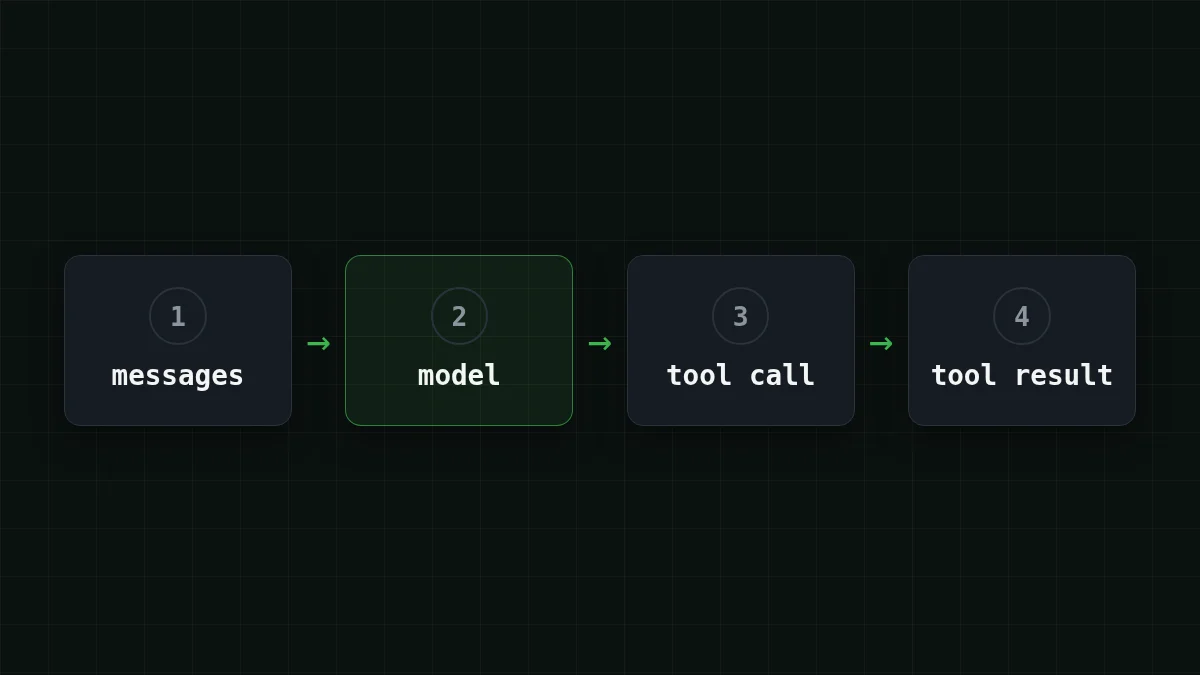
ループの1周を正しい順序に並べられますか?
順番に並べる
エージェントループの1周を順序通りに並べる
項目をドラッグするか矢印を使う
- タスクとツール一覧をモデルに送る
- モデルはテキストではなくツール呼び出しで答える
- あなたのプログラムがそのツールを自分で実行する
- 結果が「tool」メッセージとしてmessagesに入る
- 結果を持ってモデルが再び呼ばれ、プレーンテキストで返答するまで続く
キーなしで実行する#
タスクが「todo.txtにはいくつの項目がありますか?」だとします。ツールは、ディスクの代わりに小さな辞書を調べる関数read_fileです。そして実際のモデルの代わりに、常に同じ2つのことをするスクリプト化されたモデルがあります。ファイルを要求し、次に答える。これだけで、すべての可動部分を見ることができます。これをagent_loop.pyとして保存してください(Python 3.10+、標準ライブラリのみ):
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
python agent_を実行します。環境にLLM_API_KEYがなければ、スクリプト化されたモデルが使われ、画面にはちょうど2周が表示されます:
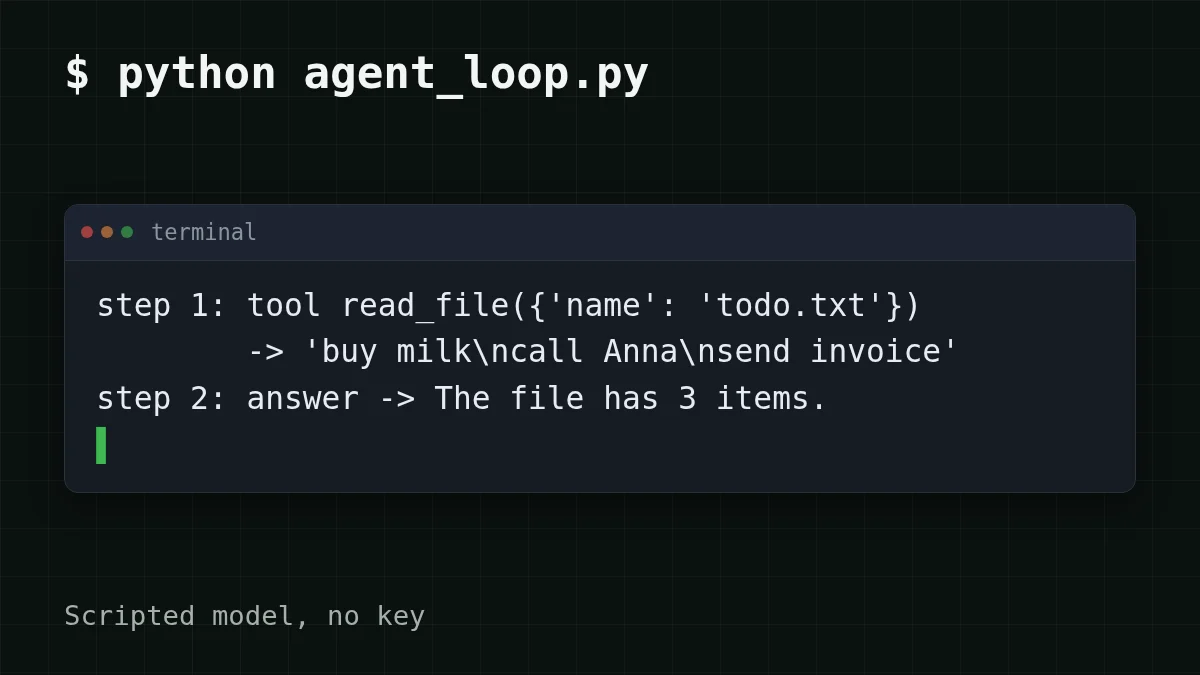
3行に注目してください。そこにすべての考えが込められています:
messages.はモデル自身のターンを保持します。これを省略すると、次の呼び出しにはAPIが一度も見たことのないリクエストに答えるツール結果が含まれます。ほとんどのAPIはこれを400で拒否します。append(reply) argumentsはJSONの文字列として届くので、関数を呼ぶ前にjson.loadsを通します。max_stepsは緊急ブレーキです。モデルは永遠にツールを要求し続けることができるので、実際のエージェントにはすべてこのような制限があります。
同じループを実際のモデルに向ける#
変わるのは1つだけです。誰がモデルを演じるかです。スクリプトは3つの環境変数を読み、キーがあれば同じmessagesをOpenAI互換エンドポイントに送ります。CheapTokensのアドレスはhttps:/(OpenAI Chat CompletionsおよびAnthropic Messages互換)で、モデルIDはdocsにある完全なものでなければなりません:deepseek-。
ループを3通りに実行する
キーなし
python agent_loop.pyスクリプト化されたモデルが両方の周を演じます。何もあなたのマシンから出ません。
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
380Kのコンテキストウィンドウと、回答あたり最大32,768出力トークン:長いループのための余裕があります。
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
多段階ループの初回実行に適した、390Kコンテキストウィンドウの軽量モデルです。
表示されるのは以前と同じ形のはずです:step 1: tool read_、次にstep 2: answer -、各モデル呼び出しの下にusage:行があります。答えの文言はスクリプト化されたものとは異なり、おしゃべりなモデルは余分に1周するかもしれません。それは正常です:モデルが決め、ループは従うだけです。キーはスクリプト自体に含めないでください。環境変数が安全な場所です(保存方法はこちら)。
usage:行が役立つ部分です。より長い実行のin数値を加えると、お金がどこに行くかがわかります。
なぜ各周が前より高くつくのか#
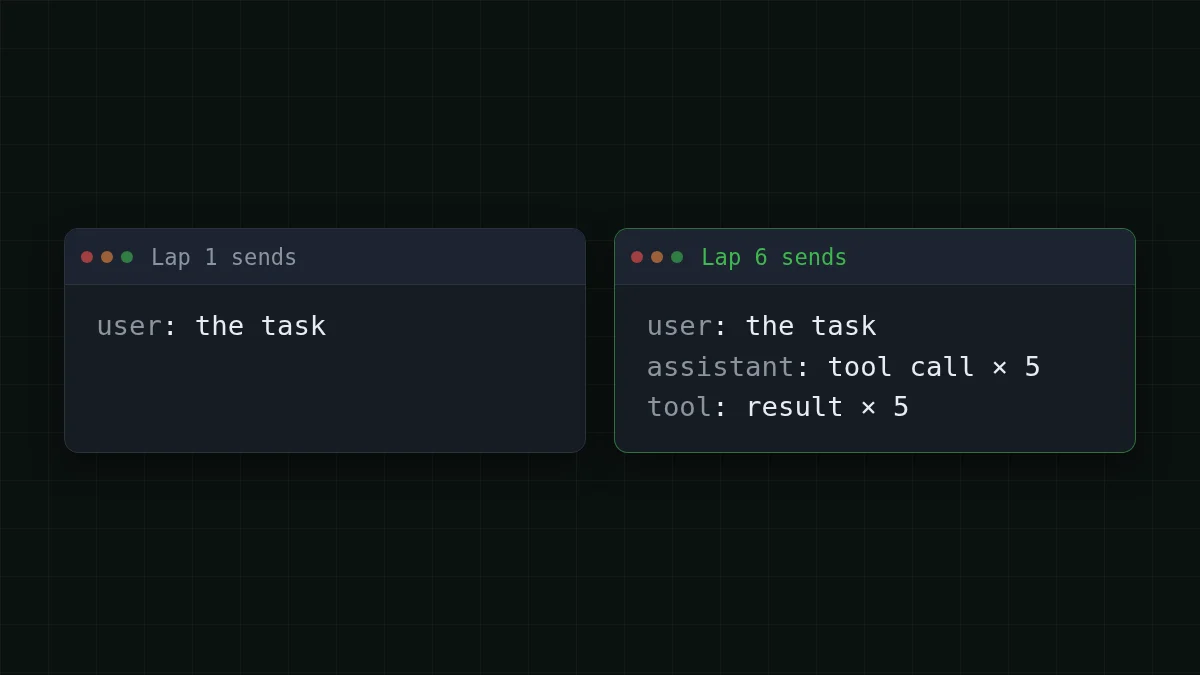
モデルは呼び出し間で何も覚えていません。各周は全体のmessagesリストを再び送ります:タスク、以前のすべてのツール呼び出し、すべてのツール結果。(同じルールが長いチャットを高価にします。マルチターンチャットはそれを普通の会話で示しています。)
1周目は1つのメッセージを送ります。ループが続けば、6周目は11個を送ります。
実際のタスクが10周かかるとします。約2,000トークン(指示、ツール一覧、あなたのリクエスト)で始まり、各周で約1,500(ツール結果とモデルのメモ)が追加され、モデルは1周あたり約300トークンを書きます。1周目は2,000、2周目は3,500、10周目は15,500を送ります。最初の部分の合計は10 × 2,000 = 20,000トークン;増加分は1,500 × 45 = 67,500(45は0+1+…+9)を加えるので、タスク全体の入力は20,000 + 67,500 = 87,500トークンです。出力は10 × 300 = 3,000トークンです。
タスクのテキスト自体は数文ですが、入力側は87,500トークンです。1M入力トークンあたり$0.015で、DeepSeek-V4-Flashでのタスク全体は$0.0016になります。参考としてOpenRouterを使い、同じ負荷をモデル間で比較します。入力と出力を合計すると、この負荷ではCheapTokensの方がOpenRouterより安くなります:
| モデル | 入力 $/1M | 出力 $/1M | コスト | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
合計 87,500 入力トークンと 3,000 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
いつでも同じ価格というのもここでは助けになります:夜通し動くエージェントも正午のものと同じコストで、すべての価格は料金ページで確認できます。このようなタスクの1日分については、スライダーを動かしてください:
コスト計算機
1日:10周のタスク20個
リクエストあたりの入力トークン数: 8,750 · リクエストあたりの出力トークン数: 300 · 1日あたりのリクエスト数: 200
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
フィールドはモデル呼び出しごとです:8,750は上の例の1周あたりの平均入力(87,500 ÷ 10)で、200回の呼び出しは20タスク × 10周です。これが、エージェントの請求が質問ではなく履歴に関するものである理由です。20ステップの例は同じ効果をより深く掘り下げています。
クイックチェック
エージェントループの3周目は、新しいことを何も尋ねていないのに1周目より高くつきます。なぜですか?
答えを表示
答え: messagesリストには今、2つのツール呼び出しと2つの結果が入っており、そのすべてが再び送られる
APIはステートレスです。すべての呼び出しが完全な履歴を運ぶので、入力トークンは各周で増え、出力はほぼ同じままです。
40行から次へ#
上のスクリプトは学習用のスケッチです。長いバージョンが欲しければ、GitHubにオープンコースがあります:justxor/agent-harness-course(READMEはロシア語、2026年10月31日確認)。依存関係のない素のPython 3.10+で、コードはMITライセンス、テキストはCC BY 4.0です。クローン後、python examples/はスクリプト化されたモデルでオフラインでループを実行し、python -はネットワークなしで19のテストを実行します。コースはコンテキスト圧縮、メモリ、サブエージェント、危険な操作の人間による承認、コスト追跡へと続きます。実際のモデルにはLLM_PROVIDER、LLM_MODEL、LLM_API_KEYを読み、OpenAI互換エンドポイントにはLLM_BASE_URLを読みます:正確なLLM_PROVIDER値はREADMEから取得してください。
ループが動いたら、次のステップは実際のキーと実際のタスクです:docsには1分でできる最初のリクエストがあり、DeepSeek-V4-Flashはループを実行するのに良いモデルです。


