AI untuk pemulaPanduan
Cara kerja agen AI: loop, dijalankan tanpa kunci API
Agen AI adalah sebuah loop: model meminta alat, kode Anda menjalankannya, hasilnya kembali. Jalankan demo Python tanpa kunci, lalu arahkan ke model sungguhan.
Di halaman ini
Anda meminta agen coding untuk memperbaiki satu salah ketik dan melihat log bergulir: baca file, cari, baca file lain, edit, jalankan tes. Satu permintaan kecil, belasan panggilan model. Dari mana asalnya?
Agen AI adalah sebuah loop. Program Anda mengirim percakapan ke model; model menjawab atau meminta alat ("baca file ini"); program Anda menjalankan alat tersebut, menambahkan hasilnya ke percakapan dan memanggil model lagi. Ini berulang sampai model menjawab dalam teks biasa. Agen coding seperti Claude Code, Codex dan mode agen Cursor dibangun di sekitar loop yang sama, dengan lebih banyak alat dan lebih banyak kehati-hatian. Di bawah ini Anda akan menjalankan versi 40 baris tanpa kunci sama sekali, lalu mengarahkannya ke model sungguhan.
Loop dalam satu gambar#
Bayangkan seorang manajer yang tidak bisa menyentuh apa pun. Manajer hanya menulis catatan: "tolong bawakan saya todo.txt". Asisten (program Anda) pergi ke rak, membawa file dan meletakkannya di meja. Manajer membacanya dan menulis catatan berikutnya, atau jawaban akhir.
Itulah seluruh triknya. Model tidak pernah membuka file atau menjalankan perintah. Ia menulis teks yang mengatakan alat mana yang harus dipanggil dan dengan argumen apa. Kode Anda yang mengerjakannya dan melaporkan kembali. Jika Anda pernah melihat function calling, ini mekanisme yang sama, diulang sampai pekerjaan selesai.
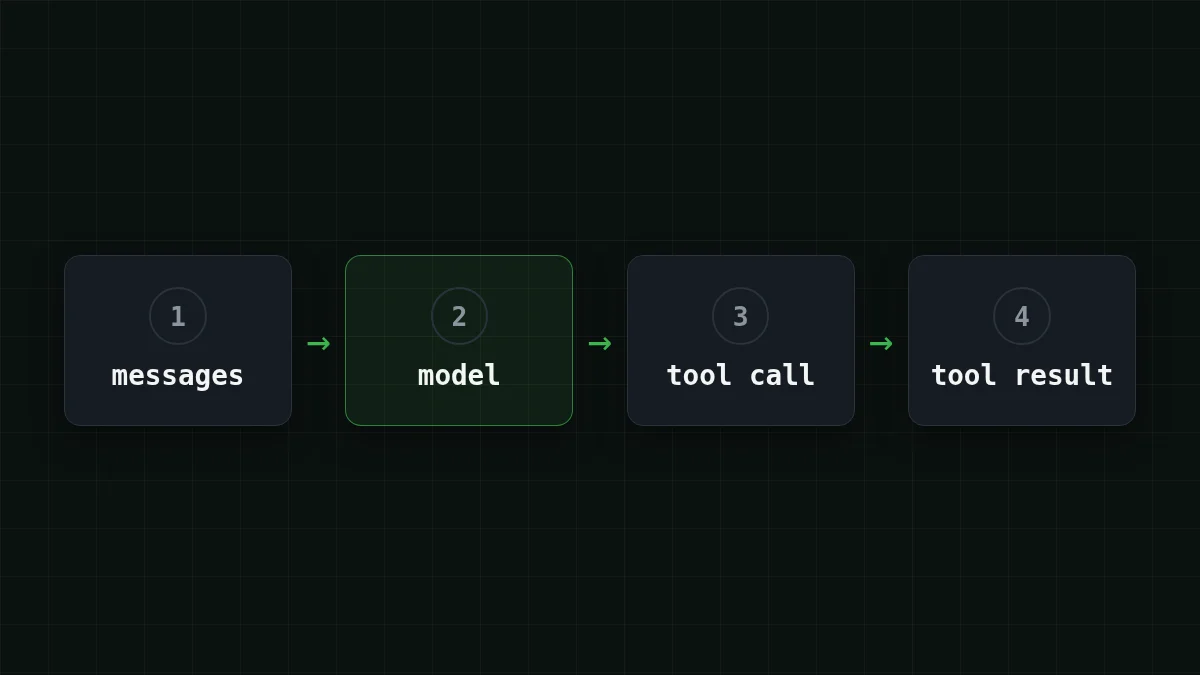
Bisakah Anda menyusun satu putaran loop dalam urutan yang benar?
Urutkan
Susun satu putaran loop agen dalam urutan yang benar
Seret item atau gunakan panah
- Kirim tugas dan daftar alat ke model
- Model menjawab dengan panggilan alat, bukan teks
- Program Anda menjalankan alat itu sendiri
- Hasilnya masuk ke pesan sebagai pesan "tool"
- Model dipanggil lagi dengan hasilnya, sampai ia membalas dalam teks biasa
Jalankan tanpa kunci#
Katakan tugasnya: "Berapa banyak item di todo.txt?". Alatnya adalah fungsi read_file yang mencari di kamus kecil alih-alih disk. Dan alih-alih model sungguhan ada model berskrip yang selalu melakukan dua hal yang sama: meminta file, lalu menjawab. Itu cukup untuk melihat setiap bagian yang bergerak. Simpan ini sebagai agent_loop.py (Python 3.10+, hanya pustaka standar):
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
Jalankan python agent_. Tanpa LLM_API_KEY di lingkungan Anda, Anda mendapatkan model berskrip, dan layar menampilkan tepat dua putaran:
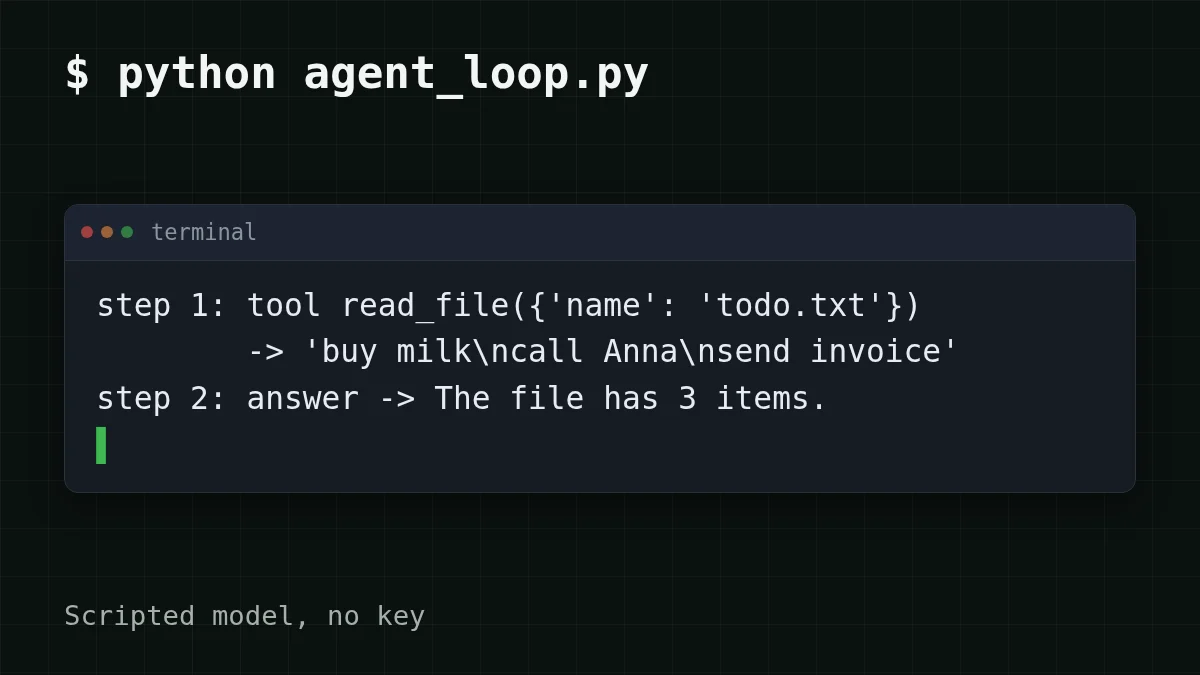
Perhatikan tiga baris, karena di situlah seluruh idenya:
messages.menyimpan giliran model itu sendiri. Lewatkan ini, dan panggilan berikutnya berisi hasil alat yang menjawab permintaan yang belum pernah dilihat API; sebagian besar API menolaknya dengan 400.append(reply) argumentsdatang sebagai string JSON, jadi ia melewatijson.loadssebelum Anda memanggil fungsi.max_stepsadalah rem darurat. Model bisa terus meminta alat selamanya, jadi setiap agen sungguhan memiliki batas seperti ini.
Arahkan loop yang sama ke model sungguhan#
Hanya satu hal yang berubah: siapa yang memainkan peran model. Skrip membaca tiga variabel lingkungan, dan jika ada kunci, ia mengirim messages yang sama ke endpoint yang kompatibel dengan OpenAI. Alamat CheapTokens adalah https:/ (kompatibel dengan OpenAI Chat Completions dan Anthropic Messages), dan id model harus yang lengkap dari dokumentasi: deepseek-.
Jalankan loop dengan tiga cara
Tanpa kunci
python agent_loop.pyModel berskrip memainkan kedua putaran. Tidak ada yang keluar dari mesin Anda.
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
Jendela konteks 380K dan hingga 32.768 token keluaran per jawaban: ruang untuk loop panjang.
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
Model ringan dengan jendela konteks 390K untuk percobaan pertama loop multi-langkah.
Yang seharusnya Anda lihat adalah bentuk yang sama seperti sebelumnya: step 1: tool read_, lalu step 2: answer -, dengan baris usage: di bawah setiap panggilan model. Kata-kata jawabannya akan berbeda dari yang berskrip, dan model yang banyak bicara mungkin mengambil putaran tambahan. Itu normal: model yang memutuskan, loop hanya menurut. Jauhkan kunci dari skrip itu sendiri; variabel lingkungan adalah tempat yang aman (ini cara menyimpannya).
Baris usage: adalah bagian yang berguna. Tambahkan angka in dari proses yang lebih panjang dan Anda akan melihat ke mana uangnya pergi.
Mengapa setiap putaran lebih mahal dari sebelumnya#
Model tidak mengingat apa pun di antara panggilan. Setiap putaran mengirim seluruh daftar messages lagi: tugas, setiap panggilan alat sebelumnya, setiap hasil alat. (Aturan yang sama membuat obrolan panjang mahal; obrolan multi-giliran menunjukkannya pada percakapan biasa.)
Putaran 1 mengirim satu pesan. Jika loop terus berjalan, putaran 6 mengirim sebelas.
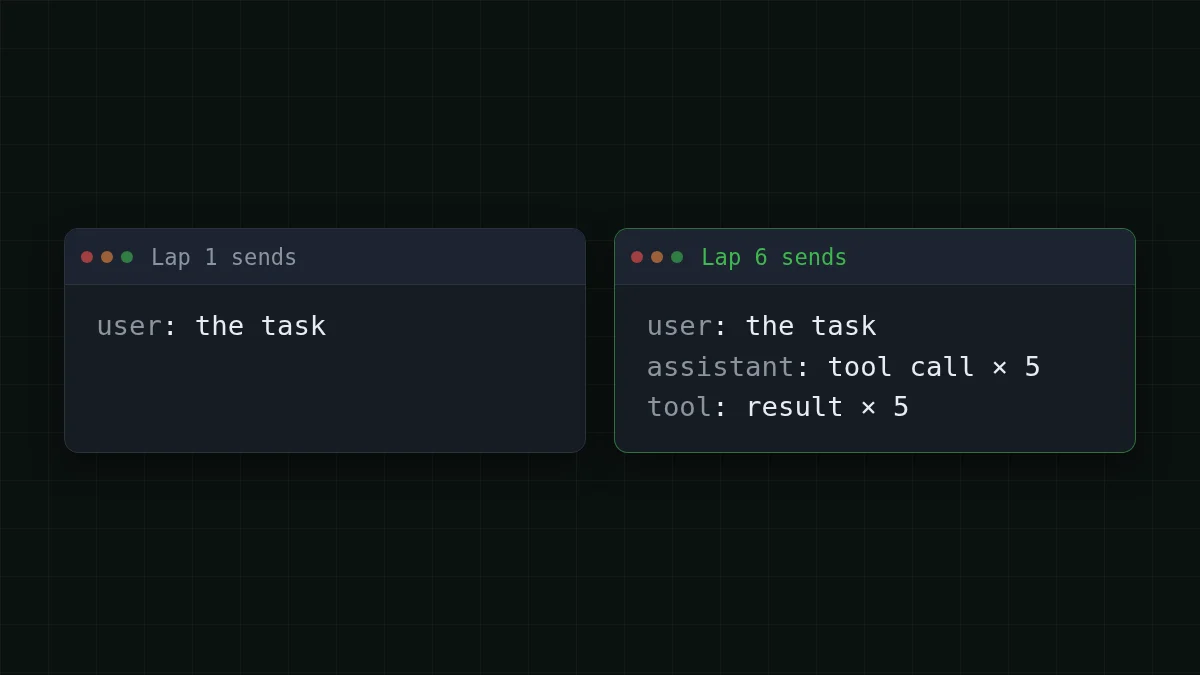
Katakan tugas nyata membutuhkan 10 putaran. Dimulai dengan sekitar 2.000 token (instruksi, daftar alat, permintaan Anda), setiap putaran menambahkan sekitar 1.500 (hasil alat plus catatan model), dan model menulis sekitar 300 token per putaran. Putaran 1 mengirim 2.000, putaran 2 mengirim 3.500, putaran 10 mengirim 15.500. Jumlah bagian pertama adalah 10 × 2.000 = 20.000 token; pertumbuhannya menambahkan 1.500 × 45 = 67.500 (45 adalah 0+1+…+9), jadi input selama tugas adalah 20.000 + 67.500 = 87.500 token. Outputnya adalah 10 × 300 = 3.000 token.
Teks tugas itu sendiri hanya beberapa kalimat, namun sisi inputnya 87.500 token. Dengan $0.015 per 1 juta token input, seluruh tugas pada DeepSeek-V4-Flash menjadi $0.0016. Berikut beban yang sama di seluruh model, dengan OpenRouter sebagai referensi. Secara total, dengan input dan output dihitung bersama, CheapTokens lebih murah daripada OpenRouter pada beban ini:
| Model | Input $/1Jt | Output $/1Jt | Biaya | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
Total 87.500 token input dan 3.000 token output. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Satu harga kapan pun juga membantu di sini: agen yang berjalan semalam hari biayanya sama dengan yang berjalan di siang hari, dan Anda dapat melihat semua harga di halaman harga. Untuk sehari penuh tugas seperti ini, geser slider:
Kalkulator biaya
Satu hari: 20 tugas masing-masing 10 putaran
Token input per permintaan: 8.750 · Token output per permintaan: 300 · Permintaan per hari: 200
| Model | Per hari | Per bulan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
Bidang-bidang tersebut adalah per panggilan model: 8.750 adalah rata-rata input satu putaran dari contoh di atas (87.500 ÷ 10), dan 200 panggilan adalah 20 tugas × 10 putaran. Inilah sebabnya tagihan agen berkaitan dengan riwayat, bukan pertanyaan. Contoh 20 langkah membahas lebih dalam efek yang sama.
Cek cepat
Putaran 3 dari loop agen lebih mahal daripada putaran 1, padahal Anda tidak meminta hal baru. Mengapa?
Tampilkan jawaban
Jawaban: Daftar pesan sekarang berisi dua panggilan alat dan dua hasil, dan semuanya dikirim lagi
API bersifat stateless. Setiap panggilan membawa riwayat lengkap, sehingga token input tumbuh setiap putaran sementara output tetap kurang lebih sama.
Ke mana setelah 40 baris#
Skrip di atas adalah sketsa untuk belajar. Jika Anda ingin versi panjangnya, ada kursus terbuka di GitHub, justxor/agent-harness-course (README dalam bahasa Rusia, diperiksa pada 31 Oktober 2026). Ini Python 3.10+ murni tanpa dependensi, kodenya berlisensi MIT, teksnya CC BY 4.0. Setelah mengkloning, python examples/ menjalankan loop secara offline dengan model berskrip, dan python - menjalankan 19 tesnya tanpa jaringan. Kursus berlanjut dengan pemadatan konteks, memori, subagen, persetujuan manusia untuk tindakan berisiko, dan pelacakan biaya. Untuk model sungguhan ia membaca LLM_PROVIDER, LLM_MODEL, LLM_API_KEY dan, untuk endpoint yang kompatibel dengan OpenAI, LLM_BASE_URL: ambil nilai LLM_PROVIDER yang tepat dari README-nya.
Saat loop berfungsi, langkah berikutnya adalah kunci sungguhan dan tugas sungguhan: dokumentasi memiliki permintaan pertama dalam satu menit, dan DeepSeek-V4-Flash adalah model yang baik untuk menjalankan loop.


