MemulaiPanduan
Chat multi-turn dengan API: kirim ulang array messages
Model tidak mengingat apa pun di antara permintaan. Bangun loop chat Python yang mengirim ulang array messages dan lihat bagaimana token input bertambah.
Di halaman ini
Pertanyaan kedua Anda mendapat jawaban aneh karena API tidak pernah melihat pertanyaan pertama. Model tidak menyimpan apa pun di antara permintaan, jadi percakapan adalah sesuatu yang Anda bangun: setelah setiap balasan Anda menambahkannya ke daftar bernama messages dan mengirim seluruh daftar itu lagi. Itulah seluruh triknya, dan di bawah ini ada loop Python yang berfungsi untuk itu terhadap API kompatibel OpenAI dari CheapTokens.
Dua dokumentasi resmi menjelaskan hal yang sama. Referensi Messages API Anthropic (diperiksa 30 Oktober 2026) menyebut API ini stateless dan multi-turn: giliran sebelumnya dikirim dalam parameter messages. Panduan text-generation OpenAI (diperiksa 30 Oktober 2026) menyarankan menyimpan konteks dengan mengirim giliran sebelumnya sebagai pesan bertanda peran dan menambahkan setiap balasan sebelum permintaan berikutnya.
Mengapa pertanyaan kedua mendapat tatapan kosong#
Katakanlah Anda mengetik What is a token?, membaca jawabannya, lalu mengetik Explain it shorter. Bagi Anda, "itu" jelas. Bagi API, permintaan nomor dua adalah pesan satu baris dari orang asing: tidak ada "itu", tidak ada yang perlu dipersingkat. Anda akan mendapat tebakan atau pertanyaan balik, bukan penjelasan yang lebih singkat.
Solusinya adalah membuat permintaan kedua membawa semua yang dimiliki permintaan pertama, ditambah balasan, ditambah pertanyaan baru. Bandingkan kedua payload:
Bandingkan
Permintaan 2, dengan dan tanpa riwayat
Tanpa riwayat
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
Model tidak tahu apa itu "itu".
Dengan riwayat
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
Sekarang "itu" menunjuk ke jawaban pertama.
Tiga peran melakukan semua pekerjaan. system menetapkan aturan sekali (nada, panjang, untuk apa bot ini). user adalah yang diketik orang. assistant adalah yang dikatakan model sebelumnya. Model membaca daftar dari atas ke bawah dan menulis pesan assistant berikutnya.
Loop chat dalam beberapa baris#
Pasang SDK dengan pip install openai dan simpan kunci Anda di variabel lingkungan, seperti di cara menyimpan kunci API dengan aman. Base URL dan id model berasal dari dokumentasi CheapTokens dan GET /v1/models (lebih lanjut di mendaftar model untuk menemukan id yang tepat). Untuk loop pembelajaran, GLM-5.3-Flash cocok: konteks 390K dan hingga 8.192 token output per jawaban.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
Jalankan, tanyakan What is a token?, lalu Explain it shorter. Jawaban kedua sekarang merujuk ke yang pertama. Baris terakhir mencetak usage., sisi input dari tagihan untuk giliran itu; perhatikan angkanya naik dengan setiap pertanyaan.
Urutan di dalam loop itu penting, dan inilah bagian yang paling sering salah dilakukan pemula:
Urutkan
Urutkan satu giliran loop
Seret item atau gunakan panah
- Tambahkan pertanyaan pengguna ke messages
- Kirim seluruh daftar messages
- Baca balasan dari respons
- Tambahkan balasan sebagai pesan assistant
Lewati langkah 4 dan model melupakan jawabannya sendiri, jadi "jelaskan lebih singkat" berhasil sekali lalu rusak lagi pada pertanyaan ketiga.
Bagaimana daftar terlihat setelah dua giliran#
Setelah What is a token? dan Explain it shorter, daftar yang dipegang kode Anda memiliki lima entri: aturan sistem, pertanyaan pertama, jawaban pertama, pertanyaan kedua, jawaban kedua. Permintaan berikutnya akan mengirim kelima entri itu plus pertanyaan ketiga.
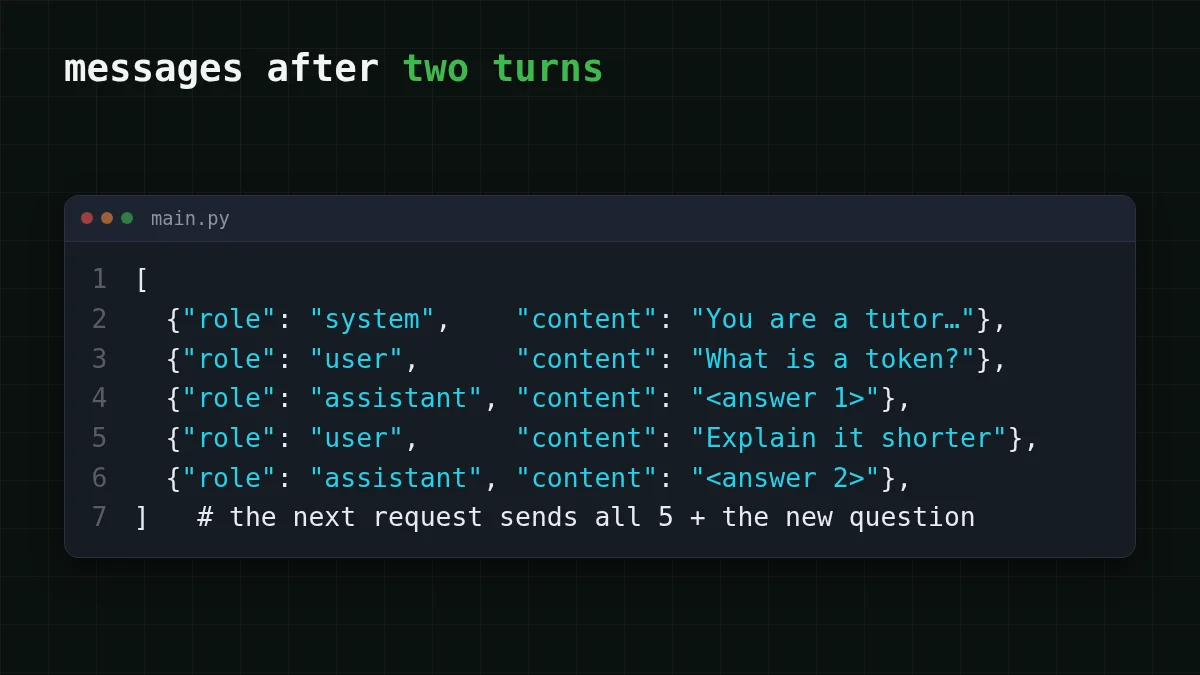
Pesan sistem dikirim setiap kali. API tidak "menyimpannya" di sisinya; itu hanya item pertama dalam daftar. Panduan OpenAI (diperiksa 30 Oktober 2026) mencatat bahwa instruksi hanya berlaku untuk permintaan saat ini, yang merupakan ide yang sama dari arah sebaliknya. Jika Anda ingin menyetel pesan pertama itu, lihat system prompt dan temperature dijelaskan.
Apa yang terjadi pada token input saat chat bertambah panjang#
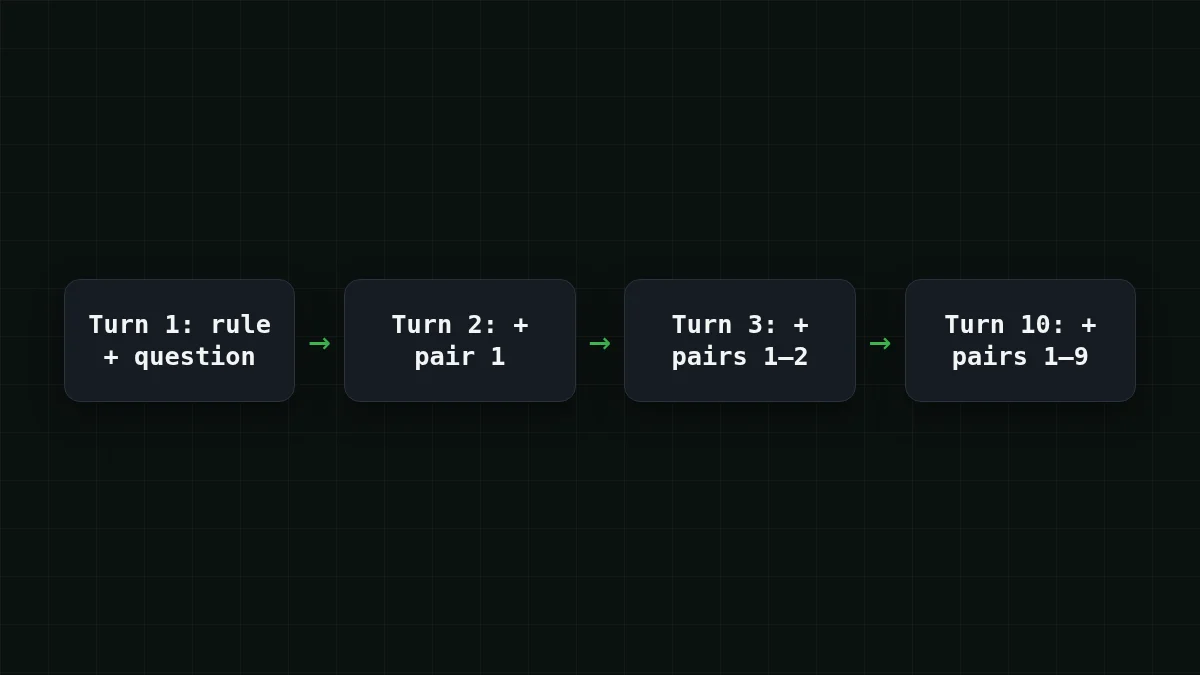
Setiap permintaan membayar seluruh daftar lagi sebagai input. Giliran 1 mengirim aturan sistem dan satu pertanyaan; giliran 10 mengirim aturan, sembilan pasangan pertanyaan-jawaban sebelumnya dan pertanyaan baru. Jadi input bertambah dengan setiap giliran, bahkan jika setiap pesan Anda pendek.
Katakanlah chat 10 giliran dengan asumsi ini: aturan sistem sekitar 50 token, setiap pertanyaan sekitar 150, setiap balasan sekitar 250. Giliran 1 mengirim 50 + 150 = 200 token input. Setiap giliran berikutnya menambah satu pasangan 400 token lagi (150 + 250 = 400), jadi total input selama sepuluh giliran adalah 200 × 10 + 400 × 45 = 20.000 token, di mana 45 adalah 0 + 1 + … + 9. Outputnya adalah 250 × 10 = 2.500 token. Sepuluh pesan dari Anda, dan inputnya delapan kali output.
Berikut seluruh chat itu dihargai dengan tarif langsung, 20.000 token masuk dan 2.500 keluar:
| Model | Input $/1Jt | Output $/1Jt | Biaya | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
Total 20.000 token input dan 2.500 token output. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Dalam total, dengan input dan output dihitung bersama, GLM-5.3-Flash dan DeepSeek-V4-Flash lebih murah di sini daripada di OpenRouter, dan keduanya mempertahankan satu harga pada jam berapa pun. Jika Anda ingin jawaban lebih panjang dari 8.192 token dalam loop chat yang sama, DeepSeek-V4-Flash mengizinkan hingga 32.768 token output per jawaban dengan konteks 380K; ganti id model menjadi deepseek- dan tidak ada hal lain di loop yang berubah.
Cerita biaya yang lebih mendalam ada di mengapa chat AI yang panjang lebih mahal; token input vs output menjelaskan mengapa kedua sisi dihargai terpisah.
Cek cepat
Chat Anda berada di giliran 8. Apa isi permintaan untuk giliran 8?
Tampilkan jawaban
Jawaban: Pesan sistem dan setiap pertanyaan dan jawaban sebelumnya, plus pertanyaan terbaru
API tidak mengingat apa pun, jadi daftar lengkap dikirim setiap kali. Itu juga sebabnya token input naik giliran demi giliran.
Menjaga chat panjang tetap terkendali#
Daftar tidak bisa tumbuh selamanya: daftar harus muat dalam jendela konteks model (lihat apa itu jendela konteks), dan setiap giliran tambahan memakan biaya input. Dua kebiasaan menjaganya tetap wajar untuk prototipe:
- Pangkas giliran tertua. Pertahankan pesan sistem dan beberapa pasangan terakhir, misalnya
messages = messages[:1] + messages[-sebelum setiap permintaan. Buang pasangan secara bersamaan agar pertanyaan tidak pernah kehilangan jawabannya.8:] - Mulai daftar baru untuk topik baru. Tugas baru tidak memerlukan riwayat tugas lama.
Bot dukungan dengan set aturan berumur panjang adalah loop yang sama: pesan sistem menetapkan aturan sekali, setiap giliran pengguna dan balasan ditambahkan, dan Anda memangkas saat daftar menjadi berat. Untuk permintaan pertama itu sendiri, lihat permintaan API pertama Anda dengan CheapTokens; daftar model dan harga ada di halaman harga.


