शुरुआत करेंगाइड
API के साथ मल्टी-टर्न चैट: messages ऐरे फिर से भेजें
मॉडल अनुरोधों के बीच कुछ याद नहीं रखता। एक Python चैट लूप बनाएँ जो messages ऐरे फिर से भेजे और देखें कि इनपुट टोकन कैसे बढ़ते हैं।
इस पृष्ठ पर
आपके दूसरे सवाल का जवाब अजीब आता है क्योंकि API ने आपका पहला सवाल कभी देखा ही नहीं। मॉडल अनुरोधों के बीच कुछ नहीं रखता, इसलिए चैट कुछ ऐसा है जो आप बनाते हैं: हर जवाब के बाद आप उसे messages नाम की सूची में जोड़ते हैं और पूरी सूची फिर से भेजते हैं। यही पूरा तरीका है, और नीचे CheapTokens की OpenAI-संगत API के लिए एक काम करने वाला Python लूप दिया गया है।
दो आधिकारिक दस्तावेज़ एक ही बात बताते हैं। Anthropic का Messages API संदर्भ (30 अक्टूबर 2026 को जाँचा गया) API को स्टेटलेस और मल्टी-टर्न कहता है: पिछले टर्न messages पैरामीटर में जाते हैं। OpenAI की टेक्स्ट-जनरेशन गाइड (30 अक्टूबर 2026 को जाँची गई) कहती है कि पिछले टर्न को रोल-टैग किए गए संदेशों के रूप में भेजकर और अगले अनुरोध से पहले हर जवाब जोड़कर संदर्भ बनाए रखें।
दूसरे सवाल पर खाली नज़र क्यों मिलती है#
मान लें आप What is a token? टाइप करते हैं, जवाब पढ़ते हैं, और फिर Explain it shorter टाइप करते हैं। आपके लिए "इसे" स्पष्ट है। API के लिए, अनुरोध संख्या दो किसी अजनबी का एक-पंक्ति संदेश है: कोई "इसे" नहीं है, छोटा करने के लिए कुछ नहीं है। आपको अनुमान या सवाल वापस मिलेगा, छोटी व्याख्या नहीं।
समाधान यह है कि अनुरोध दो में वह सब हो जो अनुरोध एक में था, साथ में जवाब और नया सवाल। दोनों पेलोड की तुलना करें:
तुलना करें
अनुरोध 2, इतिहास के साथ और बिना
इतिहास के बिना
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
मॉडल को पता ही नहीं कि "इसे" क्या है।
इतिहास के साथ
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
अब "इसे" पहले जवाब की ओर इशारा करता है।
तीन रोल सारा काम करते हैं। system नियम एक बार तय करता है (टोन, लंबाई, बॉट किसलिए है)। user वह है जो व्यक्ति ने टाइप किया। assistant वह है जो मॉडल ने पहले कहा। मॉडल सूची को ऊपर से नीचे पढ़ता है और अगला assistant संदेश लिखता है।
कुछ पंक्तियों में चैट लूप#
SDK को pip install openai से इंस्टॉल करें और अपनी कुंजी को एनवायरनमेंट वेरिएबल में रखें, जैसा कि API कुंजी को सुरक्षित रूप से कैसे स्टोर करें में है। बेस URL और मॉडल id CheapTokens दस्तावेज़ और GET /v1/models से आते हैं (अधिक जानकारी सटीक id खोजने के लिए मॉडल सूचीबद्ध करना में)। सीखने के लूप के लिए, GLM-5.3-Flash अच्छा विकल्प है: 390K संदर्भ और प्रति जवाब अधिकतम 8,192 आउटपुट टोकन।
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
इसे चलाएँ, What is a token? पूछें, फिर Explain it shorter। दूसरा जवाब अब पहले वाले का ज़िक्र करता है। अंतिम पंक्ति usage. प्रिंट करती है, उस टर्न के बिल का इनपुट पक्ष; इसे हर सवाल के साथ बढ़ते देखें।
लूप के अंदर क्रम मायने रखता है, और यही हिस्सा शुरुआती लोग सबसे ज़्यादा गलत करते हैं:
क्रम में लगाएँ
लूप के एक टर्न को क्रम में रखें
आइटम खींचें या तीरों का उपयोग करें
- उपयोगकर्ता का सवाल messages में जोड़ें
- पूरी messages सूची भेजें
- प्रतिक्रिया से जवाब पढ़ें
- जवाब को assistant संदेश के रूप में जोड़ें
चरण 4 छोड़ें और मॉडल अपने ही जवाब भूल जाता है, इसलिए "इसे छोटा समझाओ" एक बार काम करता है और फिर तीसरे सवाल पर टूट जाता है।
दो टर्न के बाद सूची कैसी दिखती है#
What is a token? और Explain it shorter के बाद, आपके कोड के पास मौजूद सूची में पाँच प्रविष्टियाँ हैं: सिस्टम नियम, पहला सवाल, पहला जवाब, दूसरा सवाल, दूसरा जवाब। अगला अनुरोध इन पाँचों के साथ तीसरा सवाल भेजेगा।
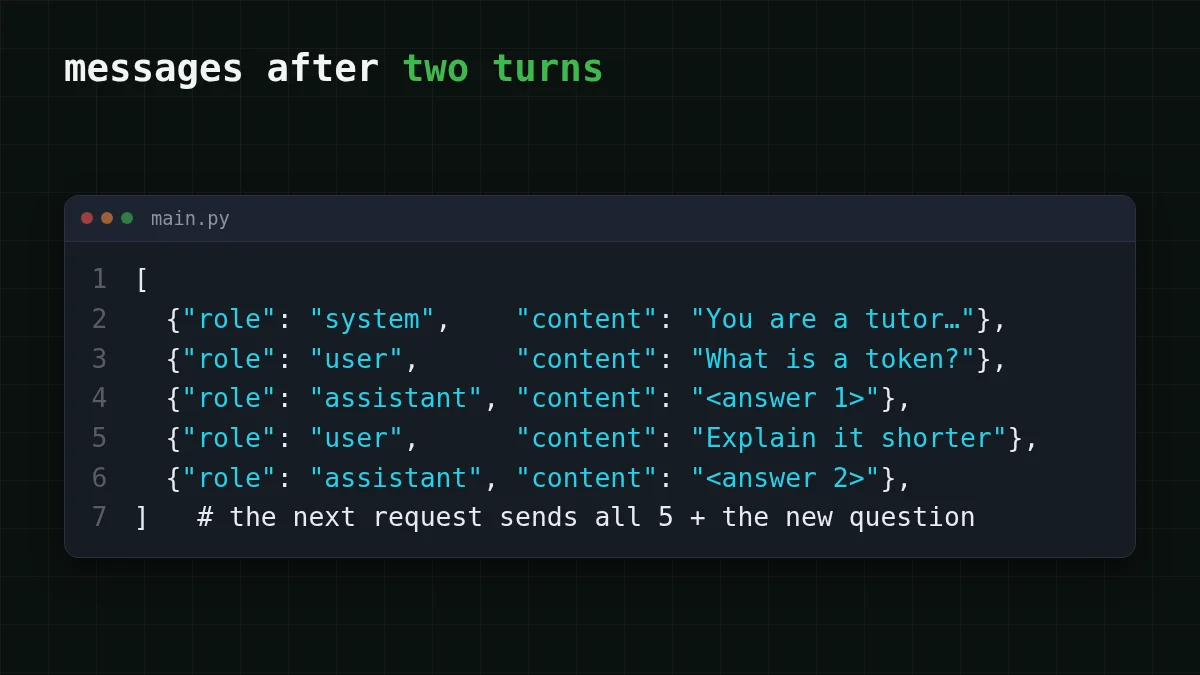
सिस्टम संदेश हर बार भेजा जाता है। API इसे अपनी ओर "नहीं रखता"; यह बस सूची की पहली प्रविष्टि है। OpenAI की गाइड (30 अक्टूबर 2026 को जाँची गई) बताती है कि निर्देश केवल वर्तमान अनुरोध पर लागू होते हैं, जो दूसरी दिशा से वही बात है। यदि आप उस पहले संदेश को ट्यून करना चाहते हैं, तो सिस्टम प्रॉम्प्ट और तापमान समझाया गया देखें।
चैट बढ़ने पर इनपुट टोकन का क्या होता है#
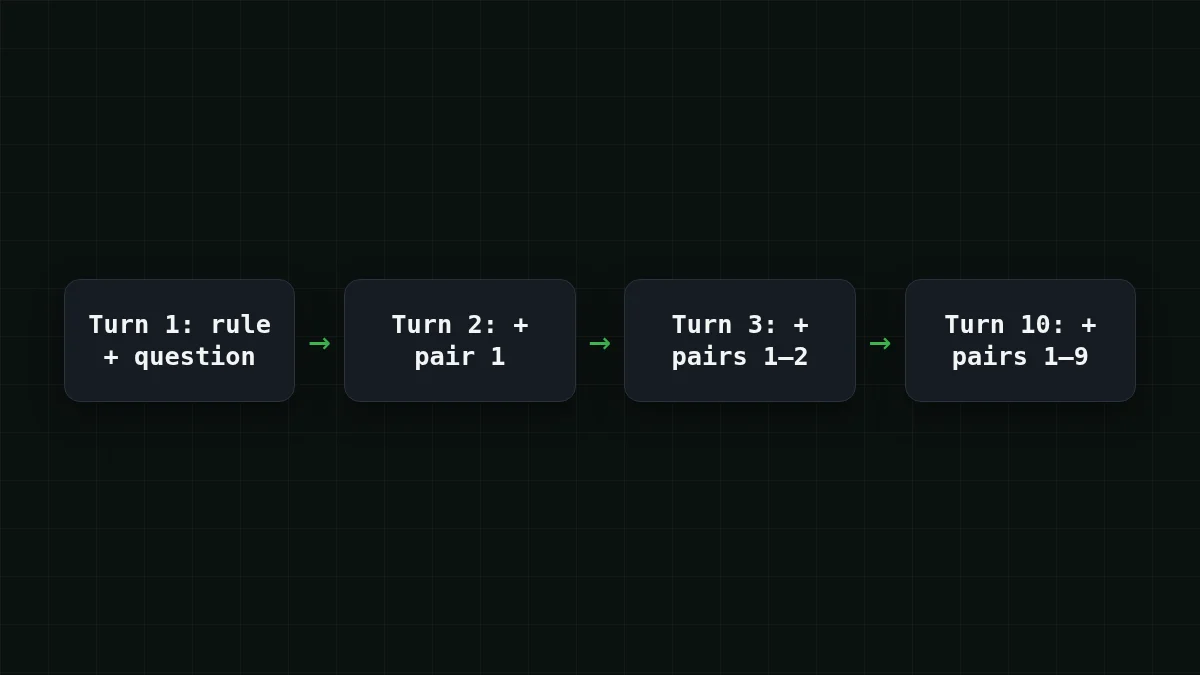
हर अनुरोध पूरी सूची के लिए इनपुट के रूप में फिर से भुगतान करता है। टर्न 1 सिस्टम नियम और एक सवाल भेजता है; टर्न 10 नियम, नौ पिछले सवाल-जवाब जोड़े और नया सवाल भेजता है। इसलिए इनपुट हर टर्न के साथ बढ़ता है, भले ही आपके हर संदेश छोटे हों।
मान लें इन अनुमानों के साथ 10-टर्न चैट: सिस्टम नियम लगभग 50 टोकन, हर सवाल लगभग 150, हर जवाब लगभग 250। टर्न 1 50 + 150 = 200 इनपुट टोकन भेजता है। हर बाद का टर्न एक और 400-टोकन जोड़ा (150 + 250 = 400) जोड़ता है, इसलिए दस टर्न में कुल इनपुट 200 × 10 + 400 × 45 = 20,000 टोकन है, जहाँ 45 = 0 + 1 + … + 9। आउटपुट 250 × 10 = 2,500 टोकन है। आपके दस संदेश, और इनपुट आउटपुट का आठ गुना है।
यहाँ वह पूरी चैट लाइव दरों पर कीमत लगाई गई है, 20,000 टोकन इन और 2,500 आउट:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | लागत | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
कुल 20,000 इनपुट और 2,500 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
कुल में, इनपुट और आउटपुट को मिलाकर गिनने पर, GLM-5.3-Flash और DeepSeek-V4-Flash यहाँ OpenRouter की तुलना में कम खर्च करते हैं, और दोनों किसी भी घंटे एक ही कीमत रखते हैं। यदि आप उसी चैट लूप में 8,192 टोकन से लंबे जवाब चाहते हैं, तो DeepSeek-V4-Flash 380K संदर्भ के साथ प्रति जवाब अधिकतम 32,768 आउटपुट टोकन की अनुमति देता है; मॉडल id को deepseek- से बदलें और लूप में कुछ और नहीं बदलता।
लागत की गहरी कहानी लंबी AI चैट ज़्यादा महँगी क्यों होती है में है; इनपुट बनाम आउटपुट टोकन बताता है कि दोनों पक्षों की कीमत अलग क्यों है।
त्वरित जाँच
आपकी चैट टर्न 8 पर है। टर्न 8 के अनुरोध में क्या है?
उत्तर दिखाएँ
उत्तर: सिस्टम संदेश और हर पिछला सवाल और जवाब, साथ में नवीनतम सवाल
API कुछ याद नहीं रखता, इसलिए हर बार पूरी सूची जाती है। यही कारण है कि इनपुट टोकन टर्न दर टर्न बढ़ते हैं।
लंबी चैट को नियंत्रण में रखना#
सूची अनंत नहीं बढ़ सकती: उसे मॉडल की संदर्भ विंडो में फिट होना है (संदर्भ विंडो क्या है देखें), और हर अतिरिक्त टर्न इनपुट का खर्च बढ़ाता है। प्रोटोटाइप के लिए दो आदतें इसे संतुलित रखती हैं:
- सबसे पुराने टर्न ट्रिम करें। सिस्टम संदेश और अंतिम कुछ जोड़े रखें, उदाहरण के लिए हर अनुरोध से पहले
messages = messages[:1] + messages[-। जोड़ों को साथ में हटाएँ ताकि किसी सवाल का जवाब कभी न खोए।8:] - नए विषय के लिए नई सूची शुरू करें। नए काम को पुराने के इतिहास की ज़रूरत नहीं होती।
लंबे समय तक चलने वाले नियम सेट वाला सपोर्ट बॉट वही लूप है: सिस्टम संदेश नियम एक बार तय करता है, हर उपयोगकर्ता टर्न और जवाब जोड़ा जाता है, और जब सूची भारी हो जाए तो आप ट्रिम करते हैं। पहले अनुरोध के लिए, CheapTokens के साथ आपका पहला API अनुरोध देखें; मॉडल सूची और कीमतें मूल्य पृष्ठ पर हैं।


