เริ่มต้นใช้งานคู่มือ
แชทหลายเทิร์นกับ API: ส่ง messages array ซ้ำ
โมเดลไม่จำอะไรระหว่างคำขอ สร้างลูปแชท Python ที่ส่ง messages array ซ้ำและดูว่า input tokens โตขึ้นอย่างไร
ในหน้านี้
คำถามที่สองของคุณได้คำตอบที่แปลกเพราะ API ไม่เคยเห็นคำถามแรกของคุณ โมเดลไม่เก็บอะไรไว้ระหว่างคำขอ ดังนั้นแชทคือสิ่งที่ คุณ สร้างขึ้น: หลังทุกคำตอบคุณต่อท้ายมันเข้าไปในลิสต์ที่เรียกว่า messages แล้วส่งลิสต์ทั้งหมดอีกครั้ง นั่นคือกลเม็ดทั้งหมด และด้านล่างคือลูป Python ที่ใช้งานได้จริงสำหรับ CheapTokens API ที่เข้ากันได้กับ OpenAI
เอกสารทางการสองฉบับอธิบายสิ่งเดียวกัน Anthropic's Messages API reference (ตรวจสอบ 30 ตุลาคม 2026) เรียก API นี้ว่า stateless และ multi-turn: เทิร์นก่อนหน้าจะเดินทางไปในพารามิเตอร์ messages OpenAI's text-generation guide (ตรวจสอบ 30 ตุลาคม 2026) บอกให้รักษาบริบทโดยส่งเทิร์นก่อนหน้าเป็นข้อความที่ติดแท็ก role และต่อท้ายทุกคำตอบก่อนคำขอถัดไป
ทำไมคำถามที่สองถึงได้สายตาว่างเปล่า#
สมมติคุณพิมพ์ What is a token? อ่านคำตอบ แล้วพิมพ์ Explain it shorter สำหรับคุณ "มัน" ชัดเจนมาก สำหรับ API คำขอหมายเลขสองคือข้อความบรรทัดเดียวของคนแปลกหน้า: ไม่มี "มัน" ไม่มีอะไรให้ย่อ คุณจะได้การเดาหรือคำถามกลับมา ไม่ใช่คำอธิบายที่สั้นลง
วิธีแก้คือทำให้คำขอที่สองพาทุกอย่างที่คำขอแรกมี บวกคำตอบ บวกคำถามใหม่ เปรียบเทียบ payload ทั้งสอง:
เปรียบเทียบ
คำขอที่ 2 มีและไม่มีประวัติ
ไม่มีประวัติ
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
โมเดลไม่รู้เลยว่า "มัน" คืออะไร
มีประวัติ
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
ตอนนี้ "มัน" ชี้ไปที่คำตอบแรก
สาม role ทำงานทั้งหมด system กำหนดกฎครั้งเดียว (โทน ความยาว บอทมีไว้ทำอะไร) user คือสิ่งที่คนพิมพ์ assistant คือสิ่งที่โมเดลพูดไว้ก่อนหน้า โมเดลอ่านลิสต์จากบนลงล่างและเขียนข้อความ assistant ถัดไป
ลูปแชทในไม่กี่บรรทัด#
ติดตั้ง SDK ด้วย pip install openai และเก็บคีย์ของคุณใน environment variable ดังใน how to store an API key safely base URL และ model id มาจาก CheapTokens docs และ GET /v1/models (เพิ่มเติมใน listing models to find the exact id) สำหรับลูปเพื่อการเรียนรู้ GLM-5.3-Flash เป็นตัวเลือกที่เหมาะ: context 390K และ output สูงสุด 8,192 tokens ต่อคำตอบ
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
รันมัน ถาม What is a token? แล้ว Explain it shorter คำตอบที่สองตอนนี้อ้างถึงคำตอบแรก บรรทัดสุดท้ายพิมพ์ usage. ซึ่งเป็นฝั่ง input ของบิลสำหรับเทิร์นนั้น ดูมันเพิ่มขึ้นทุกคำถาม
ลำดับภายในลูปสำคัญ และนี่คือส่วนที่มือใหม่พลาดบ่อยที่สุด:
เรียงลำดับ
เรียงหนึ่งเทิร์นของลูปตามลำดับ
ลากรายการหรือใช้ลูกศร
- ต่อท้ายคำถามของผู้ใช้เข้าไปใน messages
- ส่งลิสต์ messages ทั้งหมด
- อ่านคำตอบจาก response
- ต่อท้ายคำตอบเป็นข้อความ assistant
ข้ามขั้นตอนที่ 4 แล้วโมเดลจะลืมคำตอบของตัวเอง ดังนั้น "อธิบายให้สั้นลง" จะทำงานได้ครั้งเดียวแล้วพังอีกครั้งที่คำถามที่สาม
ลิสต์หน้าตาเป็นอย่างไรหลังสองเทิร์น#
หลัง What is a token? และ Explain it shorter ลิสต์ที่โค้ดของคุณถืออยู่มีห้ารายการ: กฎ system คำถามแรก คำตอบแรก คำถามที่สอง คำตอบที่สอง คำขอถัดไปจะส่งทั้งห้ารายการบวกคำถามที่สาม
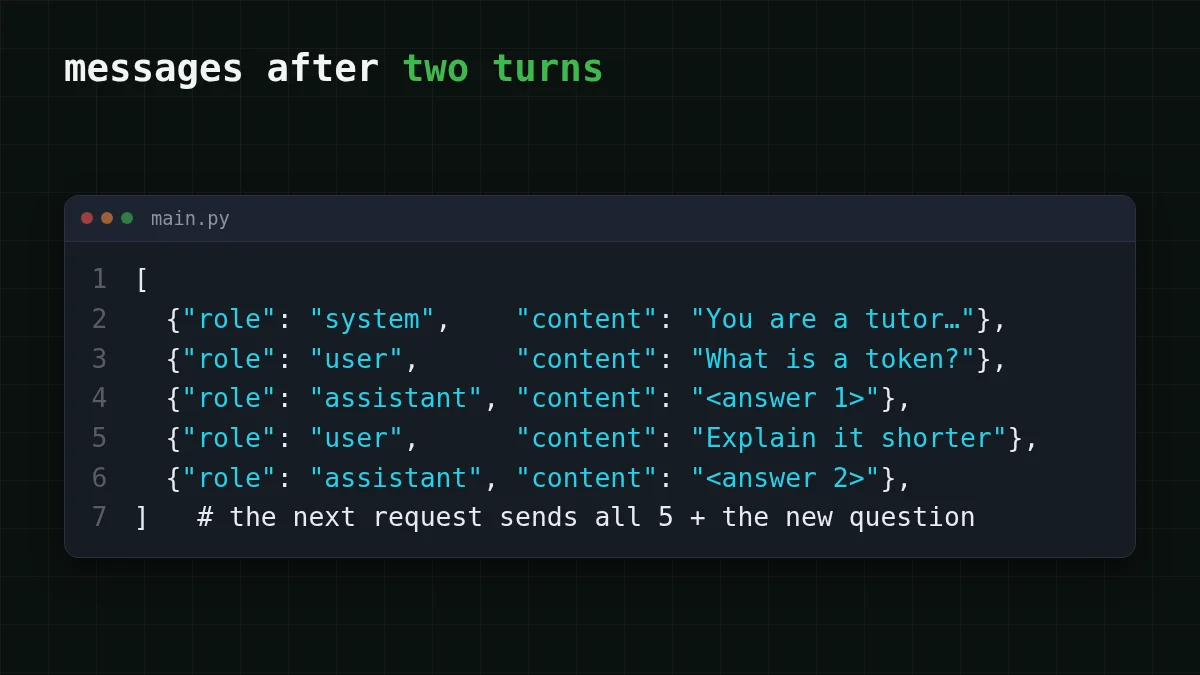
ข้อความ system ถูกส่งทุกครั้ง API ไม่ได้ "เก็บ" มันไว้ฝั่งของตัวเอง มันเป็นแค่รายการแรกของลิสต์ OpenAI's guide (ตรวจสอบ 30 ตุลาคม 2026) ระบุว่าคำสั่งใช้เฉพาะกับคำขอปัจจุบัน ซึ่งเป็นแนวคิดเดียวกันจากอีกทิศทาง ถ้าคุณต้องการปรับข้อความแรกนั้น ดู system prompt and temperature explained
เกิดอะไรขึ้นกับ input tokens เมื่อแชทโตขึ้น#
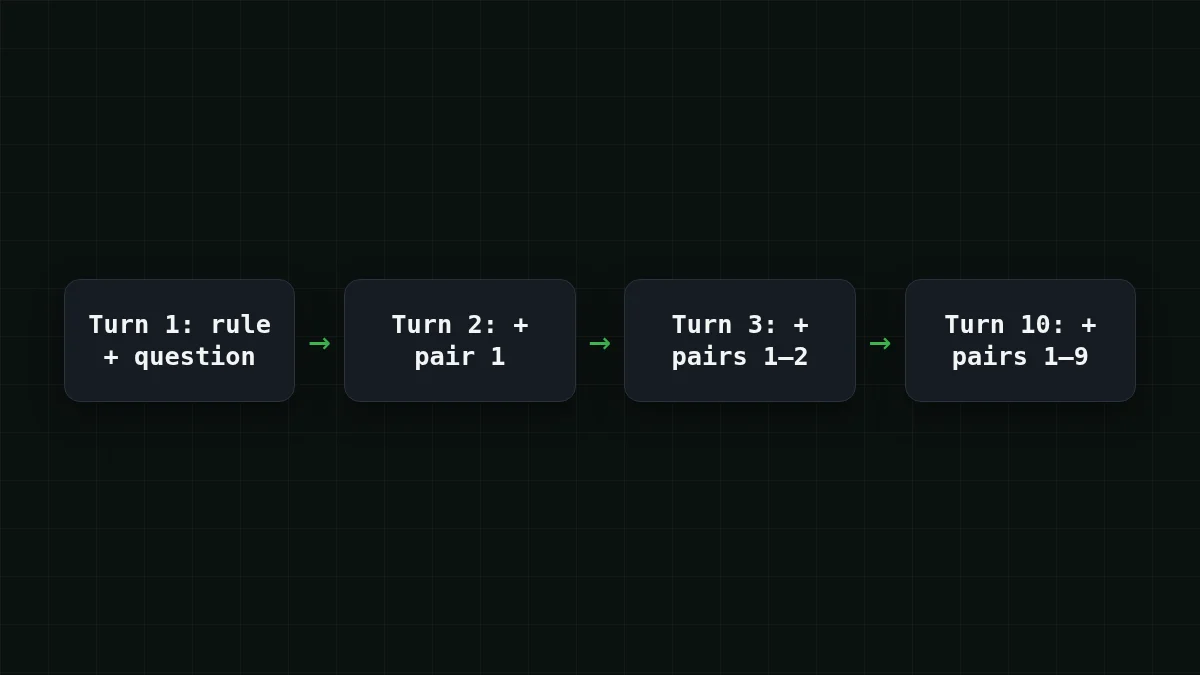
ทุกคำขอจ่ายสำหรับลิสต์ทั้งหมดอีกครั้งเป็น input เทิร์นที่ 1 ส่งกฎ system และหนึ่งคำถาม เทิร์นที่ 10 ส่งกฎ เก้าคู่คำถาม-คำตอบก่อนหน้า และคำถามใหม่ ดังนั้น input จึงโตขึ้นทุกเทิร์น แม้ข้อความแต่ละข้อความของคุณจะสั้นก็ตาม
สมมติแชท 10 เทิร์นด้วยสมมติฐานเหล่านี้: กฎ system ประมาณ 50 tokens แต่ละคำถามประมาณ 150 แต่ละคำตอบประมาณ 250 เทิร์นที่ 1 ส่ง 50 + 150 = 200 input tokens แต่ละเทิร์นถัดไปเพิ่มคู่ 400 tokens อีกหนึ่งคู่ (150 + 250 = 400) ดังนั้น input รวมตลอดสิบเทิร์นคือ 200 × 10 + 400 × 45 = 20,000 tokens โดย 45 คือ 0 + 1 + … + 9 output คือ 250 × 10 = 2,500 tokens สิบข้อความจากคุณ และ input เป็นแปดเท่าของ output
นี่คือแชททั้งหมดนั้นคิดราคาตามอัตราจริง 20,000 tokens เข้า และ 2,500 ออก:
| โมเดล | Input $/1M | Output $/1M | ค่าใช้จ่าย | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
20,000 โทเค็นอินพุตและ 2,500 โทเค็นเอาต์พุตรวมทั้งหมด ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
ในยอดรวม เมื่อนับ input และ output รวมกัน GLM-5.3-Flash และ DeepSeek-V4-Flash ถูกกว่าที่นี่เมื่อเทียบกับ OpenRouter และทั้งคู่คงราคาเดียวทุกชั่วโมง ถ้าคุณต้องการคำตอบยาวกว่า 8,192 tokens ในลูปแชทเดียวกัน DeepSeek-V4-Flash อนุญาต output สูงสุด 32,768 tokens ต่อคำตอบด้วย context 380K; สลับ model id เป็น deepseek- แล้วไม่มีอะไรอื่นในลูปเปลี่ยน
เรื่องราคาเชิงลึกอยู่ใน why a long AI chat costs more; input vs output tokens อธิบายว่าทำไมสองฝั่งจึงคิดราคาแยกกัน
เช็กด่วน
แชทของคุณอยู่ที่เทิร์น 8 คำขอสำหรับเทิร์น 8 มีอะไรบ้าง?
แสดงคำตอบ
คำตอบ: ข้อความ system และทุกคำถามและคำตอบก่อนหน้า บวกคำถามใหม่ล่าสุด
API ไม่จำอะไรเลย ดังนั้นลิสต์ทั้งหมดจึงถูกส่งออกทุกครั้ง นั่นก็เป็นเหตุผลที่ input tokens เพิ่มขึ้นทุกเทิร์น
ควบคุมแชทยาวให้อยู่หมัด#
ลิสต์โตไปตลอดไม่ได้: มันต้องพอดีกับ context window ของโมเดล (ดู what a context window is) และทุกเทิร์นที่เพิ่มขึ้นมีค่าใช้จ่าย input สองนิสัยช่วยให้มันสมเหตุสมผลสำหรับต้นแบบ:
- ตัดเทิร์นเก่าที่สุดออก เก็บข้อความ system และคู่ล่าสุดไม่กี่คู่ เช่น
messages = messages[:1] + messages[-ก่อนทุกคำขอ ตัดคู่พร้อมกันเพื่อไม่ให้คำถามสูญเสียคำตอบ8:] - เริ่มลิสต์ใหม่สำหรับหัวข้อใหม่ งานใหม่ไม่ต้องการประวัติของงานเก่า
บอทซัพพอร์ตที่มีชุดกฎอายุยาวก็คือลูปเดียวกัน: ข้อความ system กำหนดกฎครั้งเดียว แต่ละเทิร์นของผู้ใช้และคำตอบถูกต่อท้าย และคุณตัดเมื่อลิสต์หนักขึ้น สำหรับคำขอแรกเอง ดู your first API request with CheapTokens; รายการโมเดลและราคาอยู่ที่ pricing page


