Premiers pasGuide
Chat multi-tours avec une API : renvoyer le tableau messages
Le modèle ne se souvient de rien entre les requêtes. Construisez une boucle de chat Python qui renvoie le tableau messages et voyez comment les tokens d'entrée augmentent.
Sur cette page
Votre deuxième question reçoit une réponse étrange parce que l'API n'a jamais vu la première. Le modèle ne conserve rien entre les requêtes, donc une conversation est quelque chose que vous construisez : après chaque réponse, vous l'ajoutez à une liste appelée messages et vous renvoyez la liste entière. C'est toute l'astuce, et ci-dessous se trouve une boucle Python fonctionnelle pour cela avec l'API compatible OpenAI de CheapTokens.
Deux documentations officielles décrivent la même chose. La référence de l'API Messages d'Anthropic (vérifiée le 30 octobre 2026) qualifie l'API de sans état et multi-tours : les tours précédents voyagent dans le paramètre messages. Le guide de génération de texte d'OpenAI (vérifié le 30 octobre 2026) indique de conserver le contexte en envoyant les tours précédents comme messages étiquetés par rôle et en ajoutant chaque réponse avant la requête suivante.
Pourquoi la deuxième question reçoit un regard vide#
Supposons que vous tapiez What is a token?, lisiez la réponse, puis tapiez Explain it shorter. Pour vous, « ça » est évident. Pour l'API, la requête numéro deux est le message d'une ligne d'un inconnu : il n'y a pas de « ça », rien à raccourcir. Vous obtiendrez une supposition ou une question en retour, pas une explication plus courte.
La solution consiste à faire porter à la requête deux tout ce que contenait la requête un, plus la réponse, plus la nouvelle question. Comparez les deux payloads :
Comparer
Requête 2, avec et sans historique
Sans historique
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
Le modèle n'a aucune idée de ce qu'est « ça ».
Avec historique
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
Maintenant « ça » pointe vers la première réponse.
Trois rôles font tout le travail. system définit les règles une fois (ton, longueur, à quoi sert le bot). user est ce que la personne a tapé. assistant est ce que le modèle a dit plus tôt. Le modèle lit la liste de haut en bas et écrit le prochain message assistant.
La boucle de chat en quelques lignes#
Installez le SDK avec pip install openai et gardez votre clé dans une variable d'environnement, comme dans comment stocker une clé API en toute sécurité. L'URL de base et l'id du modèle viennent de la documentation CheapTokens et de GET /v1/models (plus dans lister les modèles pour trouver l'id exact). Pour une boucle d'apprentissage, GLM-5.3-Flash est un bon choix : 390K de contexte et jusqu'à 8 192 tokens de sortie par réponse.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
Lancez-le, demandez What is a token?, puis Explain it shorter. La deuxième réponse fait maintenant référence à la première. La dernière ligne affiche usage., le côté entrée de la facture pour ce tour ; regardez-le grimper à chaque question.
L'ordre dans la boucle compte, et c'est la partie que les débutants ratent le plus souvent :
Remettre en ordre
Mettre un tour de boucle dans l'ordre
Faites glisser les éléments ou utilisez les flèches
- Ajouter la question de l'utilisateur à messages
- Envoyer la liste messages entière
- Lire la réponse depuis la réponse
- Ajouter la réponse comme message assistant
Sautez l'étape 4 et le modèle oublie ses propres réponses, donc « explique plus court » fonctionne une fois puis casse à nouveau à la troisième question.
À quoi ressemble la liste après deux tours#
Après What is a token? et Explain it shorter, la liste que votre code détient contient cinq entrées : la règle système, la première question, la première réponse, la deuxième question, la deuxième réponse. La prochaine requête enverra les cinq plus la troisième question.
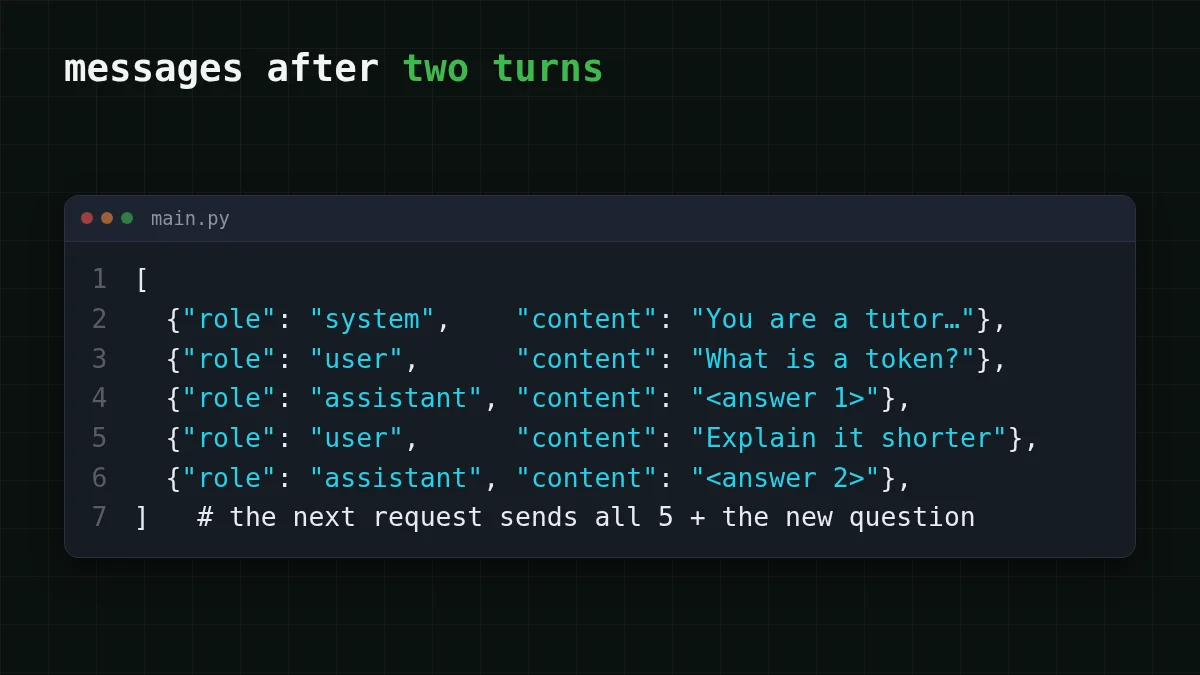
Le message système est envoyé à chaque fois. L'API ne le « garde » pas de son côté ; c'est simplement le premier élément de la liste. Le guide d'OpenAI (vérifié le 30 octobre 2026) note que les instructions ne s'appliquent qu'à la requête en cours, ce qui est la même idée vue de l'autre côté. Si vous voulez ajuster ce premier message, voir prompt système et température expliqués.
Ce qu'il advient des tokens d'entrée à mesure que le chat grandit#
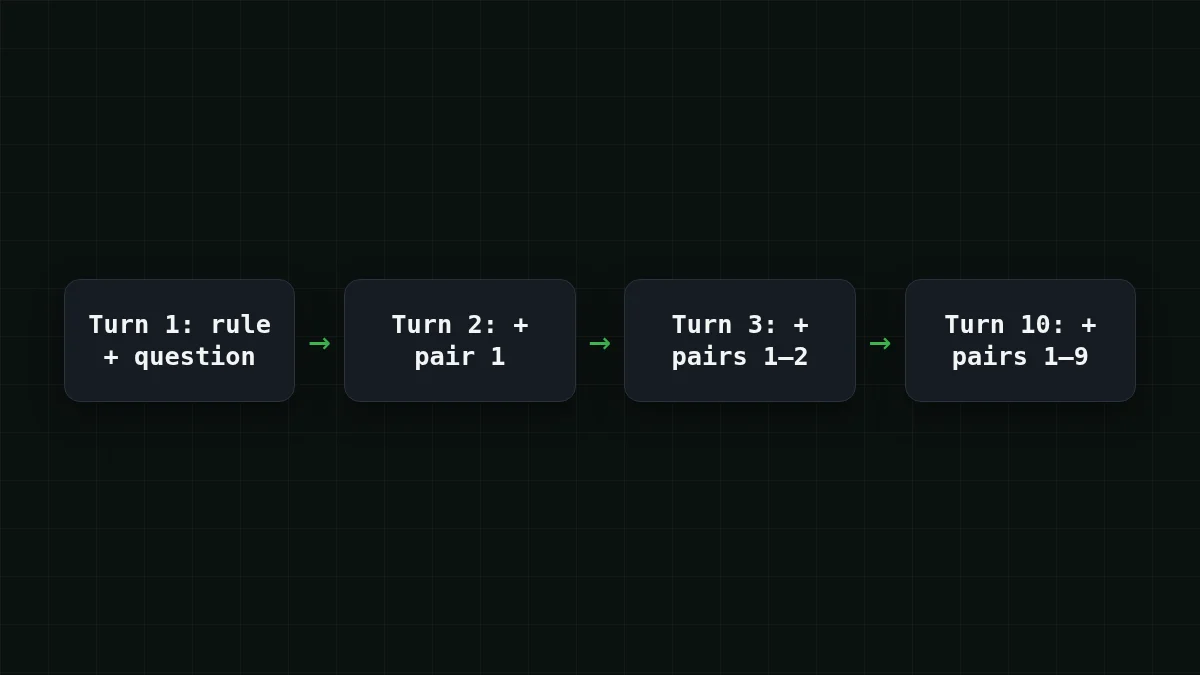
Chaque requête paie à nouveau la liste entière en entrée. Le tour 1 envoie la règle système et une question ; le tour 10 envoie la règle, neuf paires question-réponse précédentes et la nouvelle question. Donc l'entrée grandit à chaque tour, même si chacun de vos messages est court.
Supposons un chat de 10 tours avec ces hypothèses : la règle système fait environ 50 tokens, chaque question environ 150, chaque réponse environ 250. Le tour 1 envoie 50 + 150 = 200 tokens d'entrée. Chaque tour suivant ajoute une paire de 400 tokens de plus (150 + 250 = 400), donc le total d'entrée sur dix tours est 200 × 10 + 400 × 45 = 20 000 tokens, où 45 vaut 0 + 1 + … + 9. La sortie est 250 × 10 = 2 500 tokens. Dix messages de votre part, et l'entrée représente huit fois la sortie.
Voici ce chat entier tarifé aux tarifs en vigueur, 20 000 tokens en entrée et 2 500 en sortie :
| Modèle | Entrée $/1M | Sortie $/1M | Coût | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
20 000 tokens d'entrée et 2 500 tokens de sortie au total. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Dans le total, entrée et sortie comptées ensemble, GLM-5.3-Flash et DeepSeek-V4-Flash coûtent ici moins cher que chez OpenRouter, et les deux gardent un prix unique à toute heure. Si vous voulez des réponses de plus de 8 192 tokens dans la même boucle de chat, DeepSeek-V4-Flash autorise jusqu'à 32 768 tokens de sortie par réponse avec un contexte de 380K ; remplacez l'id du modèle par deepseek- et rien d'autre dans la boucle ne change.
L'histoire plus profonde des coûts est dans pourquoi un long chat IA coûte plus cher ; tokens d'entrée vs de sortie explique pourquoi les deux côtés sont tarifés séparément.
Vérification rapide
Votre chat en est au tour 8. Que contient la requête pour le tour 8 ?
Afficher la réponse
Réponse: Le message système et toutes les questions et réponses précédentes, plus la toute dernière question
L'API ne se souvient de rien, donc la liste complète part à chaque fois. C'est aussi pourquoi les tokens d'entrée grimpent tour après tour.
Garder un long chat sous contrôle#
La liste ne peut pas grandir indéfiniment : elle doit tenir dans la fenêtre de contexte du modèle (voir ce qu'est une fenêtre de contexte), et chaque tour supplémentaire coûte de l'entrée. Deux habitudes la gardent raisonnable pour un prototype :
- Élaguer les tours les plus anciens. Gardez le message système et les dernières paires, par exemple
messages = messages[:1] + messages[-avant chaque requête. Supprimez les paires ensemble pour qu'une question ne perde jamais sa réponse.8:] - Démarrer une nouvelle liste pour un nouveau sujet. Une nouvelle tâche n'a pas besoin de l'historique de l'ancienne.
Un bot de support avec un ensemble de règles durable, c'est la même boucle : le message système définit les règles une fois, chaque tour utilisateur et sa réponse sont ajoutés, et vous élaguez quand la liste devient lourde. Pour la première requête elle-même, voir votre première requête API avec CheapTokens ; la liste des modèles et les prix sont sur la page de tarification.


