IA pour débutantsGuide
Qu'est-ce qu'une fenêtre de contexte en IA ? Ce qui la remplit et que faire
La fenêtre de contexte est la mémoire de travail d'un modèle pour une requête : votre prompt, l'historique de la conversation et la réponse. Découvrez ce qui la remplit, comment l'estimer et trois habitudes.
Sur cette page
Votre conversation a bien fonctionné pendant vingt messages, et maintenant les réponses deviennent vagues. Une chose qui grandit à chaque message est la fenêtre de contexte : la mémoire de travail du modèle pour une requête. Elle contient tout ce que vous envoyez plus la réponse que le modèle écrit, et elle a une taille fixe, par exemple 380K tokens pour DeepSeek-V4-Flash.
Ce qu'est la fenêtre de contexte#
Pensez à un bureau. Le modèle ne peut travailler qu'avec ce qui est sur le bureau à cet instant : vos instructions, la conversation jusqu'ici, un document collé et la réponse qu'il est en train d'écrire. Tout ce qui n'est pas sur le bureau n'existe pas pour lui. La documentation d'Anthropic sur les fenêtres de contexte (consultée le 27 octobre 2026) le formule de la même manière : la fenêtre est tout le texte qu'un modèle peut référencer lorsqu'il génère une réponse, y compris la réponse elle-même, et elle est distincte des données sur lesquelles le modèle a été entraîné.
Le bureau a une taille fixe, comptée en tokens. Un token est un morceau de texte, environ ¾ d'un mot anglais ; qu'est-ce qu'un token en IA va plus loin. Voici les trois modèles sur CheapTokens et leurs fenêtres :
- GLM-5.3-Flash : 390K tokens
- DeepSeek-V4-Flash : 380K tokens
- MiniMax-M2.7 : 180K tokens
K signifie mille. Une fenêtre de 380K représente environ 285 000 mots anglais : 380 000 × 0,75 = 285 000. C'est quelques romans sur un seul bureau, et ça s'épuise encore plus vite qu'on ne le pense.
Ce qui compte dans la fenêtre#
Tout ce qui figure dans la requête compte, pas seulement votre dernier message :
- le prompt système (les instructions permanentes) ;
- chaque message antérieur, les vôtres et ceux du modèle ;
- les définitions d'outils et les résultats d'outils, si vous utilisez un agent ou un plugin d'éditeur ;
- les documents et images que vous joignez ;
- la réponse elle-même, y compris toute réflexion du modèle.
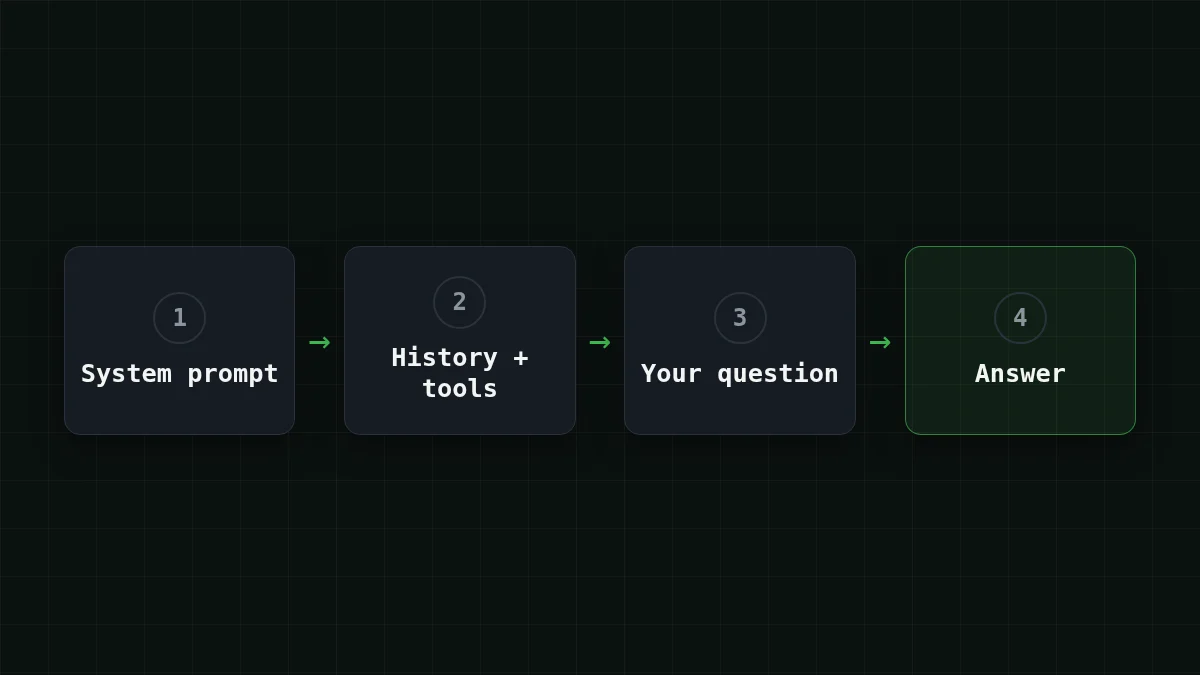
Un agent d'éditeur est le cas sournois. À chaque étape, il renvoie la liste des outils plus tout ce qu'il a lu jusqu'ici. Vous avez tapé une phrase ; la fenêtre en voit bien plus.
Vous n'avez pas à deviner la taille. Chaque réponse porte un champ usage avec les comptes de tokens. Cette boucle de chat minimale (API compatible OpenAI, identifiant de modèle issu de la documentation CheapTokens) montre les deux choses à la fois : tout l'historique part à chaque tour, et les comptes reviennent.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
Appelez ask() dix fois et regardez le premier nombre grimper. Cette montée est toute l'histoire de cet article.
Fenêtre vs sortie max : deux nombres différents#
Chaque page de modèle liste deux tailles, et les débutants les confondent souvent. La fenêtre est tout le bureau, entrée et sortie ensemble. La limite de sortie est la longueur maximale d'une réponse : jusqu'à 32 768 tokens pour DeepSeek-V4-Flash, jusqu'à 8 192 pour GLM-5.3-Flash et MiniMax-M2.7.
Ils partagent le même espace. Quoi que prenne votre entrée, la réponse doit tenir dans ce qui reste. Si vous voulez voir à quoi ressemble une réponse tronquée, pourquoi une réponse IA s'arrête en pleine phrase détaille le phénomène.
Vérification rapide
DeepSeek-V4-Flash a une fenêtre de 380K et une limite de sortie de 32 768 tokens. Vous envoyez 375K tokens d'entrée. Environ quelle longueur peut avoir la réponse ?
Afficher la réponse
Réponse: Environ 5K tokens, ce qui reste dans la fenêtre
La fenêtre couvre l'entrée et la sortie ensemble : 380K − 375K laisse environ 5K, ce qui est inférieur au plafond de 32 768.
Pourquoi un long chat remplit la fenêtre (et la facture)#
Un modèle ne se souvient pas de votre dernier message. Pour poursuivre une conversation, l'API reçoit tout l'historique à chaque tour : les tours précédents sont conservés intégralement, et la réponse du modèle devient une partie de l'entrée suivante. (Les applications de chat suppriment parfois discrètement les messages les plus anciens ; l'API ne le fait pas pour vous.)
Supposons que vous discutiez avec un assistant de support pendant 30 tours. Supposez un prompt système de 400 tokens, 150 tokens par question et 450 par réponse, donc chaque échange ajoute 600 tokens à l'historique.
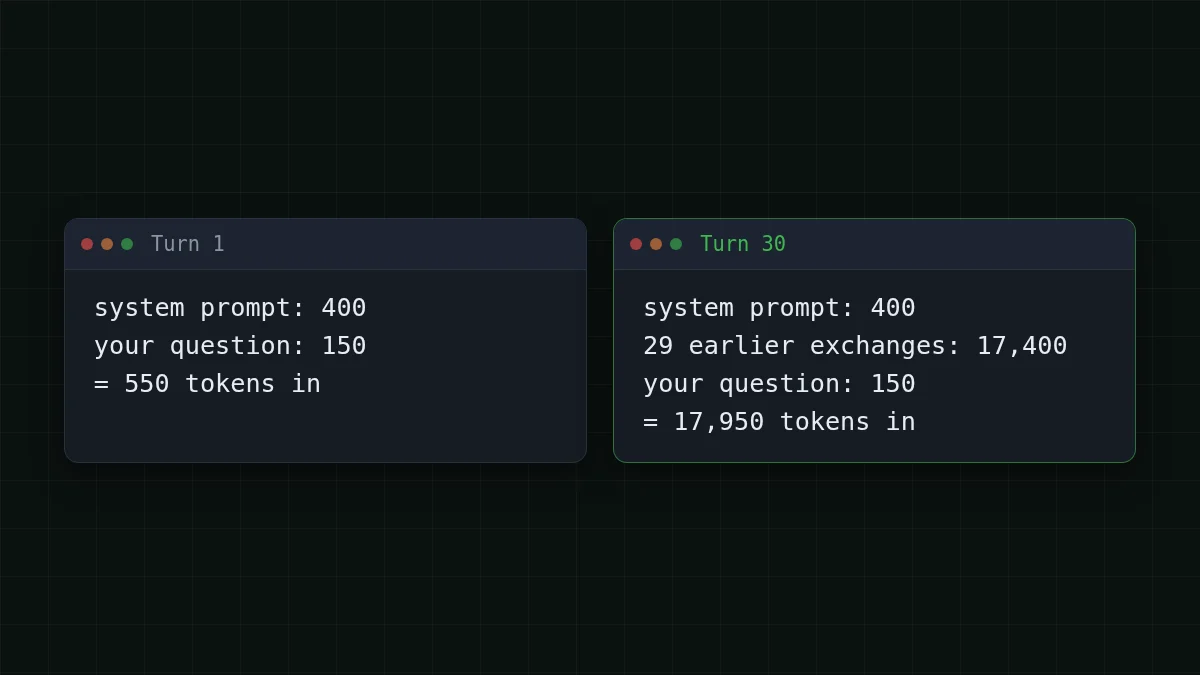
Le tour 1 envoie environ 550 tokens. Le tour 30 envoie 400 + 150 + 29 × 600 = 17 950. Additionné sur toute la conversation, chaque tour porte les 550 tokens de son propre début, donc 30 × 550 = 16 500. En plus, le tour n renvoie n − 1 échanges antérieurs de 600 tokens chacun : 600 × 435 = 261 000, où 435 = 1 + 2 + … + 29. L'entrée de toute la conversation est 16 500 + 261 000 = 277 500 tokens, et les réponses ajoutent 30 × 450 = 13 500.
Sur DeepSeek-V4-Flash, toute cette conversation coûte $0.0055. Voici les trois modèles, avec le prix de référence OpenRouter à côté ; en comptant l'entrée et la sortie ensemble, chacun est moins cher qu'OpenRouter pour cette conversation :
| Modèle | Entrée $/1M | Sortie $/1M | Coût | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
277 500 tokens d'entrée et 13 500 tokens de sortie au total. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
En moyenne, cette conversation représente 277 500 ÷ 30 = 9 250 tokens en entrée par requête et 450 en sortie.
Vous voulez votre propre conversation ? Modifiez les nombres ci-dessous, par exemple pour 100 tours, et regardez à quelle vitesse le total augmente.
Calculateur de coût
La même conversation de 30 tours, en moyenne
Tokens d'entrée par requête: 9 250 · Tokens de sortie par requête: 450 · Requêtes par jour: 30
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
Maintenant la partie honnête. 17 950 tokens représentent moins de 5 % d'une fenêtre de 380K, donc une conversation simple atteint rarement la limite. Ce qui augmente, c'est la facture et le bruit. La documentation d'Anthropic note que la précision et le rappel se dégradent à mesure que le nombre de tokens augmente (elle appelle cela la pourriture du contexte), donc une fenêtre plus grande n'est pas automatiquement meilleure : ce que vous y mettez compte autant que ce qui rentre. Là où la limite apparaît vraiment, c'est avec les documents et les agents. Sur l'API d'Anthropic elle-même, une requête dont l'entrée seule dépasse la fenêtre reçoit une erreur 400, prompt is too long. Pour le volet coût du même effet, voir pourquoi un long chat IA coûte plus cher.
Mon document va-t-il rentrer ?#
Une règle approximative pour le texte anglais : un token représente environ ¾ d'un mot, donc tokens ≈ mots ÷ 0,75. Les autres langues prennent généralement plus de tokens par mot, donc laissez une marge supplémentaire. Essayez avant de lire la suite.
Devinez le nombre
Combien de tokens représente un livre de 90 000 mots ?
Votre estimation
0300 000
Afficher la réponse
Réponse: 120 000
Environ 120 000 : 90 000 ÷ 0,75 = 120 000. Il rentre dans n'importe laquelle des trois fenêtres avec de la place à revendre.
Maintenant un cas plus gros. Supposons que vous ayez une archive de 150 000 mots d'e-mails de support et que vous vouliez un résumé : 150 000 ÷ 0,75 = 200 000 tokens. 200 000 tokens, c'est plus qu'une fenêtre de 180K, donc pour cette archive, choisissez GLM-5.3-Flash (390K) ou DeepSeek-V4-Flash (380K). DeepSeek-V4-Flash laisse encore 380 000 − 200 000 = 180 000 tokens de place sur DeepSeek-V4-Flash, plus qu'assez pour un résumé sous sa limite de réponse de 32 768 tokens. Lire ces 200 000 tokens et écrire un résumé de 2 000 tokens coûte $0.0032.
Un cas plus petit : un rapport de 60 000 mots représente 60 000 ÷ 0,75 = 80 000 tokens. MiniMax-M2.7 le gère avec 100K de marge, ce qui rend sa fenêtre de 180K suffisante pour les chats et les documents de taille moyenne.
Trois habitudes pour une fenêtre presque pleine#
1. Résumez et redémarrez. Au tour 30, la requête porte 17 950 tokens. Demandez au modèle d'écrire un résumé de 200 tokens des décisions prises jusqu'ici, puis démarrez une nouvelle conversation avec lui. La requête suivante fait 400 + 200 + 150 = 750 tokens en entrée, et le modèle sait toujours ce qui compte.
2. N'envoyez que la partie dont vous avez besoin. Collez le chapitre sur lequel vous posez la question, pas le livre entier ; la fonction, pas tout le dépôt. Moins sur le bureau signifie une facture plus petite et, d'après la note d'Anthropic sur la pourriture du contexte, un modèle qui a moins de choses où se perdre.
3. Gardez les parties fixes légères et surveillez usage. Le prompt système, les définitions d'outils et les longs résultats d'outils accompagnent chaque étape. Éliminez ce que vous n'utilisez pas, affichez les comptes de tokens après chaque réponse comme dans la boucle ci-dessus, et réglez max_tokens sur la longueur dont vous avez réellement besoin.
Quand vous voulez essayer cela sur un vrai modèle, la documentation CheapTokens montre la première requête en quelques lignes, et la page de tarification liste le prix en direct de chaque modèle. Pour les longs documents et les boucles d'agents, DeepSeek-V4-Flash (contexte de 380K, jusqu'à 32 768 tokens de sortie, un prix fixe sans heures de pointe) et GLM-5.3-Flash (390K, la plus grande fenêtre des trois) sont ceux à examiner en premier.


