AI untuk pemulaPanduan
Apa itu jendela konteks dalam AI? Apa yang mengisinya dan apa yang harus dilakukan
Jendela konteks adalah memori kerja model untuk satu permintaan: prompt Anda, riwayat obrolan, dan jawabannya. Lihat apa yang mengisinya, cara memperkirakannya, dan tiga kebiasaan.
Di halaman ini
Obrolan Anda berjalan lancar selama dua puluh pesan, dan sekarang jawabannya menjadi tidak jelas. Satu hal yang bertambah dengan setiap pesan adalah jendela konteks: memori kerja model untuk satu permintaan. Jendela ini menampung semua yang Anda kirim ditambah jawaban yang ditulis model, dan ukurannya tetap, misalnya 380K token untuk DeepSeek-V4-Flash.
Apa itu jendela konteks#
Bayangkan sebuah meja. Model hanya dapat bekerja dengan apa yang ada di atas meja saat ini: instruksi Anda, percakapan sejauh ini, dokumen yang ditempel, dan jawaban yang sedang ditulisnya. Apa pun yang tidak ada di atas meja tidak ada baginya. Dokumentasi Anthropic tentang jendela konteks (diperiksa 27 Oktober 2026) menyatakannya dengan cara yang sama: jendela adalah semua teks yang dapat dirujuk model saat menghasilkan respons, termasuk respons itu sendiri, dan terpisah dari data yang digunakan untuk melatih model.
Meja itu memiliki ukuran tetap, dihitung dalam token. Token adalah potongan teks, kira-kira ¾ dari satu kata bahasa Inggris; apa itu token dalam AI membahasnya lebih dalam. Berikut adalah tiga model di CheapTokens dan jendela mereka:
- GLM-5.3-Flash: 390K token
- DeepSeek-V4-Flash: 380K token
- MiniMax-M2.7: 180K token
K berarti ribu. Jendela 380K sekitar 285.000 kata bahasa Inggris: 380.000 × 0,75 = 285.000. Itu beberapa novel di satu meja, dan tetap saja habis lebih cepat dari yang Anda kira.
Apa yang dihitung ke dalamnya#
Semua yang ada dalam permintaan dihitung, bukan hanya pesan terakhir Anda:
- system prompt (instruksi tetap);
- setiap pesan sebelumnya, milik Anda dan milik model;
- definisi tool dan hasil tool, jika Anda menggunakan agen atau plugin editor;
- dokumen dan gambar yang Anda lampirkan;
- jawaban itu sendiri, termasuk pemikiran yang dilakukan model.
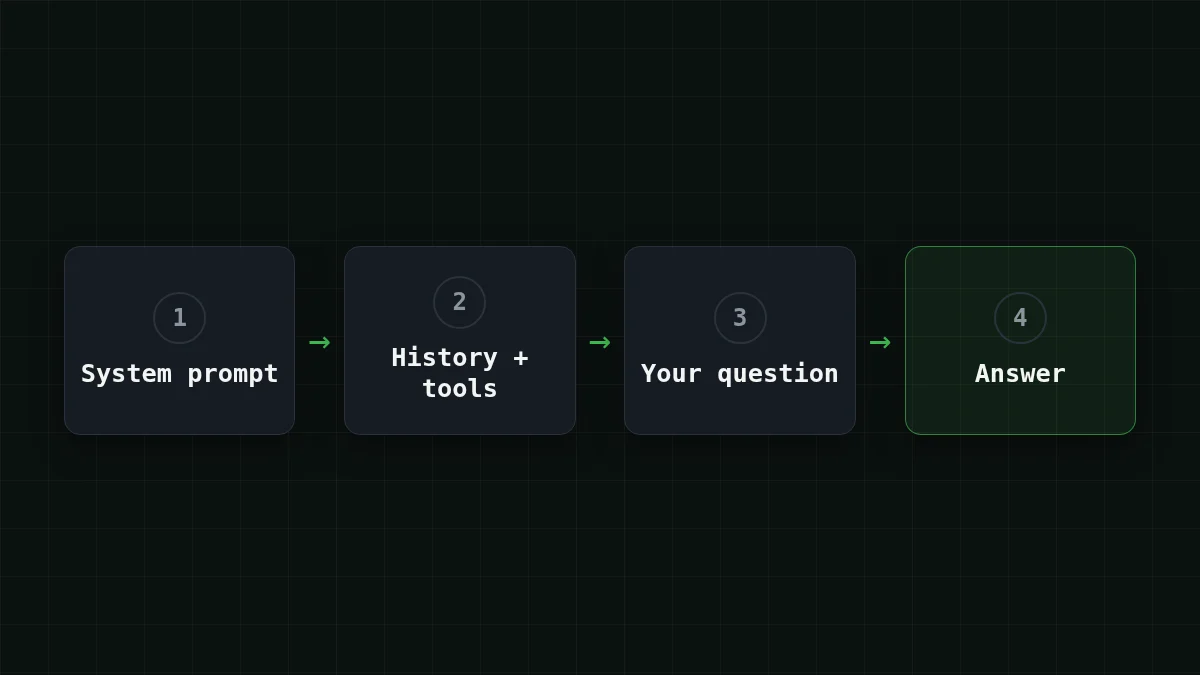
Agen editor adalah kasus yang licik. Pada setiap langkah ia mengirim daftar tool lagi ditambah semua yang telah dibacanya sejauh ini. Anda mengetik satu kalimat; jendela melihat jauh lebih banyak.
Anda tidak perlu menebak ukurannya. Setiap respons membawa bidang usage dengan jumlah token. Loop obrolan minimal ini (API yang kompatibel dengan OpenAI, id model dari dokumentasi CheapTokens) menunjukkan keduanya sekaligus: seluruh riwayat dikirim pada setiap giliran, dan jumlahnya kembali.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
Panggil ask() sepuluh kali dan perhatikan angka pertama naik. Kenaikan itulah inti dari artikel ini.
Jendela vs. output maks: dua angka yang berbeda#
Setiap halaman model mencantumkan dua ukuran, dan pemula sering mencampuradukkannya. Jendela adalah seluruh meja, input dan output bersama-sama. Batas output adalah seberapa panjang satu jawaban boleh: hingga 32.768 token untuk DeepSeek-V4-Flash, hingga 8.192 untuk GLM-5.3-Flash dan MiniMax-M2.7.
Keduanya berbagi ruang yang sama. Berapa pun yang diambil input Anda, jawaban harus muat di sisanya. Jika Anda ingin melihat seperti apa jawaban yang terpotong, mengapa jawaban AI berhenti di tengah kalimat membahasnya.
Cek cepat
DeepSeek-V4-Flash memiliki jendela 380K dan batas output 32.768 token. Anda mengirim 375K token input. Kira-kira seberapa panjang jawabannya bisa?
Tampilkan jawaban
Jawaban: Sekitar 5K token, sisa yang ada di jendela
Jendela mencakup input dan output bersama-sama: 380K − 375K menyisakan sekitar 5K, yang berada di bawah batas 32.768.
Mengapa obrolan panjang memenuhi jendela (dan tagihan)#
Model tidak mengingat pesan terakhir Anda. Untuk melanjutkan percakapan, API menerima seluruh riwayat lagi setiap giliran: giliran sebelumnya disimpan sepenuhnya, dan jawaban model menjadi bagian dari input berikutnya. (Aplikasi obrolan terkadang membuang pesan terlama secara diam-diam; API tidak melakukannya untuk Anda.)
Misalkan Anda mengobrol dengan asisten dukungan selama 30 giliran. Asumsikan system prompt 400 token, 150 token per pertanyaan dan 450 per jawaban, sehingga setiap pertukaran menambah 600 token ke riwayat.
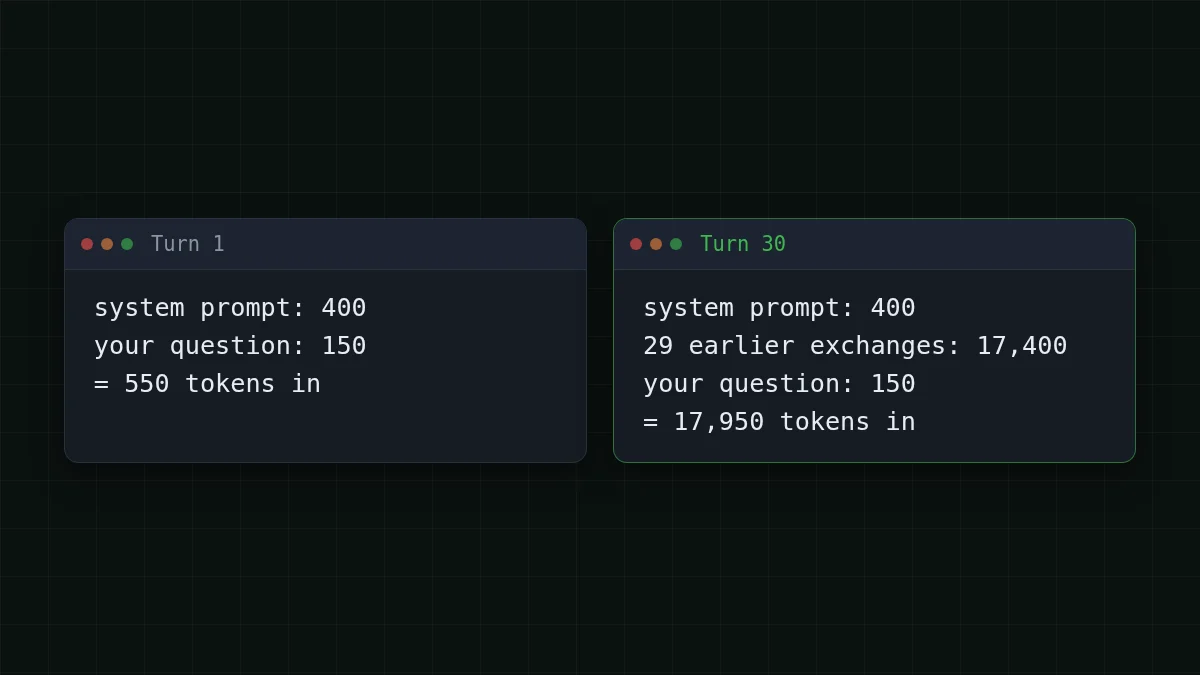
Giliran 1 mengirim sekitar 550 token. Giliran 30 mengirim 400 + 150 + 29 × 600 = 17.950. Jika dijumlahkan sepanjang obrolan, setiap giliran membawa 550 token dari awalnya sendiri, jadi 30 × 550 = 16.500. Di atas itu, giliran n mengirim ulang n − 1 pertukaran sebelumnya yang masing-masing 600 token: 600 × 435 = 261.000, di mana 435 = 1 + 2 + … + 29. Input seluruh obrolan adalah 16.500 + 261.000 = 277.500 token, dan jawabannya menambah 30 × 450 = 13.500.
Pada DeepSeek-V4-Flash seluruh obrolan itu berbiaya $0.0055. Berikut ketiga model, dengan harga referensi OpenRouter di sampingnya; menghitung input dan output bersama-sama, masing-masing lebih murah daripada OpenRouter untuk obrolan ini:
| Model | Input $/1Jt | Output $/1Jt | Biaya | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
Total 277.500 token input dan 13.500 token output. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Rata-rata, obrolan itu adalah 277.500 ÷ 30 = 9.250 token masuk per permintaan dan 450 keluar.
Ingin obrolan Anda sendiri? Ubah angka di bawah, misalnya menjadi 100 giliran, dan perhatikan seberapa cepat totalnya bertambah.
Kalkulator biaya
Obrolan 30 giliran yang sama, rata-rata
Token input per permintaan: 9.250 · Token output per permintaan: 450 · Permintaan per hari: 30
| Model | Per hari | Per bulan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
Sekarang bagian jujurnya. 17.950 token berada di bawah 5% dari jendela 380K, jadi obrolan biasa jarang menabrak dinding. Yang bertambah adalah tagihan dan noise. Dokumentasi Anthropic mencatat bahwa akurasi dan recall menurun seiring bertambahnya jumlah token (disebut context rot), jadi jendela yang lebih besar tidak otomatis lebih baik: apa yang Anda masukkan sama pentingnya dengan seberapa banyak yang muat. Di mana dinding itu muncul adalah pada dokumen dan agen. Pada API Anthropic sendiri, permintaan yang inputnya saja lebih besar dari jendela mendapat error 400, prompt is too long. Untuk sisi biaya dari efek yang sama, lihat mengapa obrolan AI yang panjang lebih mahal.
Apakah dokumen saya akan muat?#
Aturan kasar untuk teks bahasa Inggris: satu token sekitar ¾ kata, jadi token ≈ kata ÷ 0,75. Bahasa lain biasanya memakan lebih banyak token per kata, jadi sisakan margin ekstra. Cobalah sebelum membaca lanjut.
Tebak angkanya
Berapa token untuk buku 90.000 kata?
Tebakan Anda
0300.000
Tampilkan jawaban
Jawaban: 120.000
Sekitar 120.000: 90.000 ÷ 0,75 = 120.000. Buku itu muat di salah satu dari tiga jendela dengan sisa ruang.
Sekarang kasus yang lebih besar. Misalkan Anda memiliki arsip 150.000 kata email dukungan dan ingin ringkasan: 150.000 ÷ 0,75 = 200.000 token. 200.000 token lebih dari jendela 180K, jadi untuk arsip ini pilih GLM-5.3-Flash (390K) atau DeepSeek-V4-Flash (380K). DeepSeek-V4-Flash masih menyisakan 380.000 − 200.000 = 180.000 token ruang pada DeepSeek-V4-Flash, lebih dari cukup untuk ringkasan di bawah batas jawaban 32.768 token. Membaca 200.000 token itu dan menulis ringkasan 2.000 token berbiaya $0.0032.
Kasus yang lebih kecil: laporan 60.000 kata adalah 60.000 ÷ 0,75 = 80.000 token. MiniMax-M2.7 menanganinya dengan sisa 100K, yang membuat jendela 180K-nya cukup untuk obrolan dan dokumen ukuran sedang.
Tiga kebiasaan untuk jendela yang hampir penuh#
1. Ringkas dan mulai ulang. Pada giliran 30, permintaan membawa 17.950 token. Minta model menulis ringkasan 200 token dari keputusan sejauh ini, lalu mulai obrolan baru dengannya. Permintaan berikutnya adalah 400 + 200 + 150 = 750 token masuk, dan model tetap tahu apa yang penting.
2. Kirim hanya bagian yang Anda butuhkan. Tempel bab yang Anda tanyakan, bukan seluruh buku; fungsinya, bukan seluruh repositori. Lebih sedikit di atas meja berarti tagihan lebih kecil, dan, berdasarkan catatan context rot Anthropic, model yang memiliki lebih sedikit hal untuk tersesat.
3. Jaga bagian tetap tetap ramping dan pantau usage. System prompt, definisi tool, dan hasil tool yang panjang ikut serta pada setiap langkah. Pangkas yang tidak Anda gunakan, cetak jumlah token setelah setiap respons seperti pada loop di atas, dan setel max_tokens ke panjang yang benar-benar Anda butuhkan.
Ketika Anda ingin mencobanya pada model nyata, dokumentasi CheapTokens menunjukkan permintaan pertama dalam beberapa baris, dan halaman harga mencantumkan harga langsung setiap model. Untuk dokumen panjang dan loop agen, DeepSeek-V4-Flash (konteks 380K, hingga 32.768 token output, satu harga tetap tanpa jam sibuk) dan GLM-5.3-Flash (390K, jendela terbesar dari ketiganya) adalah yang pertama untuk dilihat.


