AI入門ガイド
AIのコンテキストウィンドウとは?何が埋め、どう対処するか
コンテキストウィンドウは1回のリクエストに対するモデルの作業記憶だ。プロンプト、チャット履歴、回答が含まれる。何が埋めるか、見積もり方、3つの習慣を解説。
このページの内容
チャットは20メッセージまでは問題なく動いていたのに、今では回答が曖昧になってきた。メッセージごとに増えていくものの1つがコンテキストウィンドウ、つまり1回のリクエストに対するモデルの作業記憶だ。これは送信するすべてとモデルが書く回答を保持し、固定サイズを持つ。例えばDeepSeek-V4-Flashでは380Kトークンだ。
コンテキストウィンドウとは#
机を想像してほしい。モデルは今この机の上にあるものだけで作業できる。あなたの指示、これまでの会話、貼り付けた文書、そして書きかけの回答だ。机の上にないものは、モデルにとって存在しない。Anthropicのコンテキストウィンドウに関するドキュメント(2026年10月27日確認)も同じように述べている。ウィンドウとは、モデルが応答を生成する際に参照できるすべてのテキストであり、応答自体も含まれ、モデルが学習したデータとは別物だ。
机には固定サイズがあり、トークンで数える。トークンとはテキストの断片で、おおよそ英単語の¾に相当する。AIにおけるトークンとはで詳しく説明している。CheapTokensにある3つのモデルとそのウィンドウは次のとおりだ。
- GLM-5.3-Flash: 390Kトークン
- DeepSeek-V4-Flash: 380Kトークン
- MiniMax-M2.7: 180Kトークン
Kは千を意味する。380Kのウィンドウは約285,000英単語に相当する。380,000 × 0.75 = 285,000。これは机の上に数冊の小説を置ける量だが、それでも思うよりずっと早く使い切ってしまう。
何がカウントされるか#
リクエスト内のすべてがカウントされ、最後のメッセージだけではない。
- システムプロンプト(常設の指示)
- 以前のすべてのメッセージ(あなたのものもモデルのものも)
- ツール定義とツール結果(エージェントやエディタプラグインを使う場合)
- 添付した文書や画像
- 回答自体(モデルが行う思考も含む)
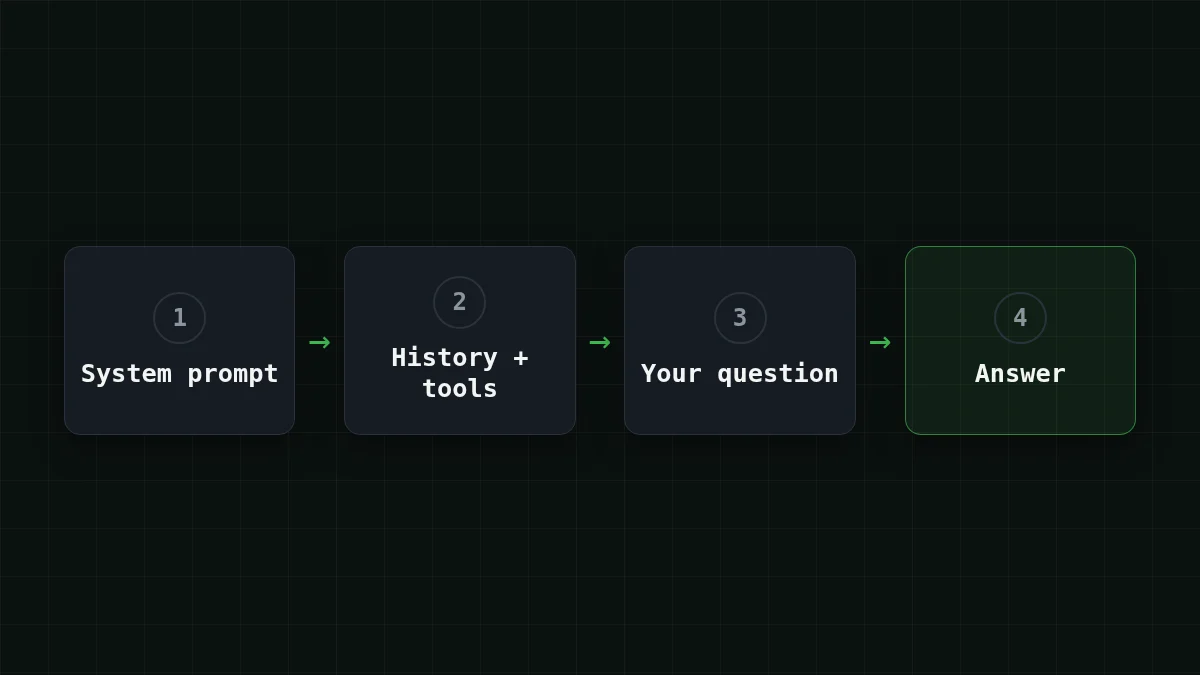
エディタエージェントは特に厄介なケースだ。各ステップでツールリストを再送し、それまでに読んだすべてのものも送る。あなたは1文しか入力していないのに、ウィンドウははるかに多くを見ている。
サイズを推測する必要はない。各応答にはトークン数を含むusageフィールドが付いている。この最小限のチャットループ(OpenAI互換API、モデルIDはCheapTokensのドキュメントから)は両方を同時に示している。毎ターン全履歴が送信され、カウントが返ってくる。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
return answerask()を10回呼び出して、最初の数字が増えていくのを見てほしい。その増加がこの記事のすべてだ。
ウィンドウと最大出力:2つの異なる数字#
どのモデルページにも2つのサイズが記載されており、初心者はよく混同する。ウィンドウは机全体で、入力と出力を合わせたものだ。出力制限は1つの回答がどれだけ長くできるかだ。DeepSeek-V4-Flashでは最大32,768トークン、GLM-5.3-FlashとMiniMax-M2.7では最大8,192トークンだ。
これらは同じスペースを共有する。入力がどれだけ取っても、回答は残りに収まらなければならない。打ち切られた回答がどのようなものか見たいなら、AIの回答が途中で止まる理由で説明している。
クイックチェック
DeepSeek-V4-Flashは380Kのウィンドウと32,768トークンの出力制限を持つ。375Kトークンの入力を送信する。回答はどのくらいの長さになるか?
答えを表示
答え: 約5Kトークン、ウィンドウに残っている分
ウィンドウは入力と出力を合わせてカバーする。380K − 375Kで約5Kが残り、これは32,768の上限を下回る。
長いチャットがウィンドウ(と請求)を埋める理由#
モデルは最後のメッセージを覚えていない。会話を続けるために、APIは毎ターン全履歴を再び受け取る。以前のターンは完全に保持され、モデルの回答は次の入力の一部になる。(チャットアプリは時々最も古いメッセージを静かに削除するが、APIはあなたの代わりにそれをしない。)
サポートアシスタントと30ターン会話するとしよう。400トークンのシステムプロンプト、質問あたり150トークン、回答あたり450トークンと仮定すると、各やり取りで履歴に600トークンが追加される。
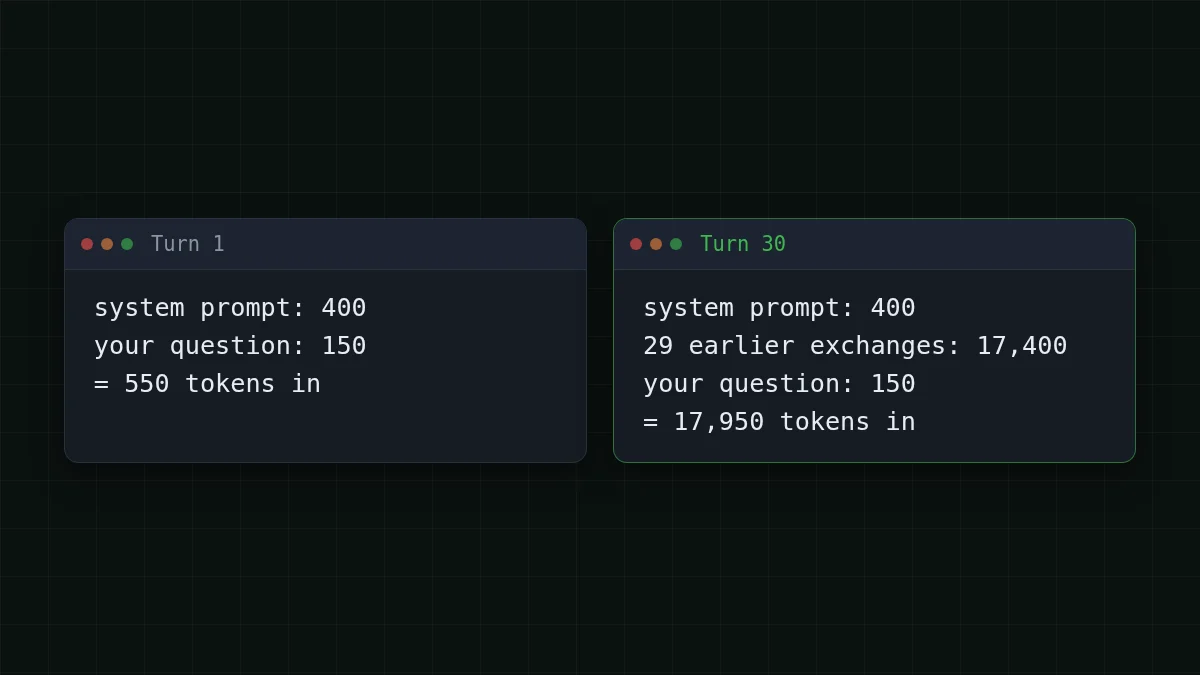
ターン1は約550トークンを送信する。ターン30は400 + 150 + 29 × 600 = 17,950を送信する。チャット全体で合計すると、各ターンは自身の開始時の550トークンを運ぶので、30 × 550 = 16,500。さらに、ターンnはn − 1個の以前のやり取り(各600トークン)を再送する。600 × 435 = 261,000、ここで435 = 1 + 2 + … + 29。チャット全体の入力は16,500 + 261,000 = 277,500トークンで、回答は30 × 450 = 13,500を追加する。
DeepSeek-V4-Flashでは、このチャット全体のコストは$0.0055だ。以下が3モデルすべてで、OpenRouterの参考価格を並べている。入力と出力を合わせて数えると、このチャットではどれもOpenRouterより安い。
| モデル | 入力 $/1M | 出力 $/1M | コスト | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
合計 277,500 入力トークンと 13,500 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
平均すると、このチャットはリクエストあたり277,500 ÷ 30 = 9,250トークン入力、450トークン出力だ。
自分のチャットで試したい? 以下の数字を変更して、例えば100ターンにしてみて、合計がどれだけ速く増えるか見てほしい。
コスト計算機
同じ30ターンのチャット、平均
リクエストあたりの入力トークン数: 9,250 · リクエストあたりの出力トークン数: 450 · 1日あたりのリクエスト数: 30
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
ここで正直な話をしよう。17,950トークンは380Kウィンドウの5%未満なので、普通のチャットが壁にぶつかることはまれだ。増えるのは請求とノイズだ。Anthropicのドキュメントは、トークン数が増えるにつれて精度と再現率が低下すると指摘している(これをコンテキストロットと呼んでいる)。つまり、大きなウィンドウが自動的に良いわけではない。何を入れるかは、どれだけ収まるかと同じくらい重要だ。壁が現れるのは文書とエージェントだ。Anthropic自身のAPIでは、入力だけでウィンドウより大きいリクエストは400エラー、プロンプトが長すぎますとなる。同じ効果のコスト面については、長いAIチャットが高くつく理由を参照してほしい。
私の文書は収まるか?#
英語テキストの大まかなルール:1トークンは約¾単語なので、トークン ≈ 単語数 ÷ 0.75。他の言語は通常1単語あたりより多くのトークンを要するので、余裕を多めに取ろう。読み進める前に試してみてほしい。
数字を当てる
90,000語の本は何トークンか?
あなたの予想
0300,000
答えを表示
答え: 120,000
約120,000:90,000 ÷ 0.75 = 120,000。3つのウィンドウのどれにも余裕で収まる。
次はもっと大きなケース。150,000語のサポートメールのアーカイブがあり、要約が欲しいとする:150,000 ÷ 0.75 = 200,000トークン。200,000トークンは180Kウィンドウを超えるので、このアーカイブにはGLM-5.3-Flash(390K)かDeepSeek-V4-Flash(380K)を選ぼう。DeepSeek-V4-Flashではまだ380,000 − 200,000 = 180,000トークンの余裕が残り、32,768トークンの回答制限内で要約を書くには十分すぎる。その200,000トークンを読み、2,000トークンの要約を書くコストは$0.0032だ。
小さめのケース:60,000語のレポートは60,000 ÷ 0.75 = 80,000トークン。MiniMax-M2.7は100Kの余裕で処理でき、その180Kウィンドウはチャットと中規模文書には十分だ。
ウィンドウがほぼ満杯のときの3つの習慣#
1. 要約して再開する。 ターン30ではリクエストは17,950トークンを運ぶ。これまでの決定事項の200トークン要約をモデルに書かせ、それで新しいチャットを始める。次のリクエストは400 + 200 + 150 = 750トークン入力で、モデルはまだ重要なことを知っている。
2. 必要な部分だけを送る。 本全体ではなく、質問している章を貼り付ける。リポジトリ全体ではなく、関数を。机の上が少なければ請求も小さくなり、Anthropicのコンテキストロットの指摘に従えば、モデルが迷い込む余地も少なくなる。
3. 固定部分をスリムに保ち、usageを監視する。 システムプロンプト、ツール定義、長いツール結果は毎ステップ一緒に運ばれる。使わないものは削り、上のループのように各応答後にトークン数を出力し、max_tokensを実際に必要な長さに設定する。
実際のモデルでこれを試したいときは、CheapTokensのドキュメントが最初のリクエストを数行で示しており、料金ページに各モデルの最新価格が載っている。長い文書とエージェントループには、DeepSeek-V4-Flash(380Kコンテキスト、最大32,768出力トークン、ピーク時間なしの固定価格)とGLM-5.3-Flash(390K、3つの中で最大のウィンドウ)をまず検討してほしい。


