モデルと比較比較
コーディングにおけるGPT-6.1 Terra vs Sol vs Luna: タスクあたりのコスト
コーディングにはTerra、Sol、Lunaのどれ? 1つのタスクを3つのOpenAIティアすべてで価格計算し、どこから始めるかの選び方、安いモデルで十分な場合を解説。
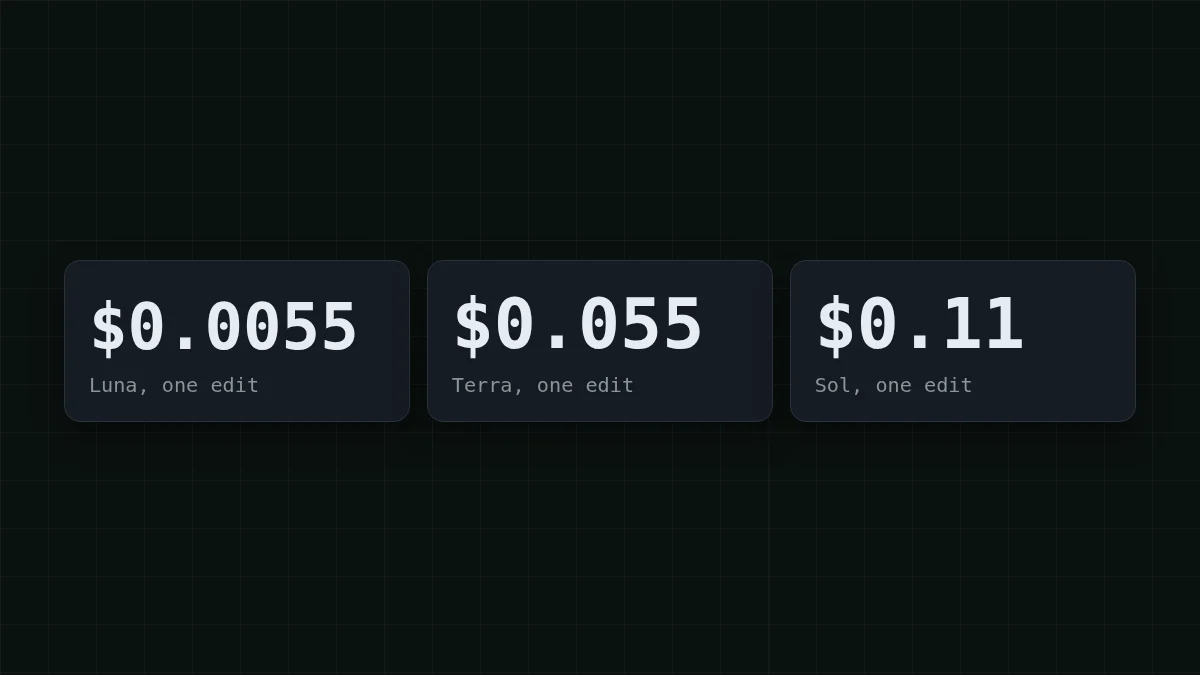
エージェントセッションが終わり、diffも問題なさそうに見える。そこで気になるのは、一番高いティアが必要だったのかどうかだ。短く言えば、Terraから始め、単純な大量ステップはLunaに送り、SolにはTerraがすでに失敗したタスクだけを使う。同一の編集(入力40,000トークン、出力3,000トークン)で、OpenAIの標準価格ではLunaが$0.0055、Terraが$0.055、Solが$0.11になる。
価格表の内容#
OpenAIの価格ページ(2026年10月29日確認、標準ティア、入力272Kトークンまで)には、100万トークンあたりの次の価格が載っている。
テーブルを右にスクロールしてください →
| ティア | 入力 | キャッシュ入力 | 出力 | 1回の編集: 入力40K、出力3K |
|---|---|---|---|---|
GPT-6 Luna (gpt-6-luna) |
$0.10 | $0.01 | $0.50 | $0.0055 |
GPT-6.1 Terra (gpt-6.1-terra) |
$1.00 | $0.05 | $5.00 | $0.055 |
GPT-6.1 Sol (gpt-6.1-sol) |
$2.00 | $0.10 | $10.00 | $0.11 |
パターンは整っている。Solはどの列でもちょうどTerraの2倍だ。Lunaは入力と出力でTerraの10分の1、キャッシュ入力では5分の1になる。つまりコストの階段は固定されており、本当の問いは、安い段がどれくらいの頻度で仕事をこなせるかだ。
最後の列は単純な算術だ。Terraでは、入力が40,000 × 1.00 / 1,000,000 = 0.04、出力が3,000 × 5.00 / 1,000,000 = 0.015なので、0.04 + 0.015 = 0.055。Solでは同じ計算が0.08 + 0.03 = 0.11、Lunaでは0.004 + 0.0015 = 0.0055になる。
1回の編集、そして50回#
このような編集を1日に50回行うとしよう。関数を書き換え、壊れたテストを直し、ファイルと指示で約40,000トークンを入力し、パッチと説明で3,000トークンを出力する。すると1日のコストはTerraで50 × 0.055 = 2.75ドル、Solで50 × 0.11 = 5.50、Lunaで50 × 0.0055 = 0.275になる。
1回の編集で$0.11を気にする人はいない。そのペースでSolを1か月使うとなると話は別で、だからこそティアは気分ではなくタスクの種類ごとに一度決めるべきなのだ。
以下が計算全体を数行にしたもので、貼り付けて自分のトークン数で再実行できる(価格は上の表の例なので、現在の価格を入れること)。
PRICES = {  # $ per 1M tokens: (input, output), OpenAI, 29 Oct 2026
    'luna': (0.10, 0.50),
    'terra': (1.00, 5.00),
    'sol': (2.00, 10.00),
}

def cost(tier, tokens_in, tokens_out):
    p_in, p_out = PRICES[tier]
    return (tokens_in * p_in + tokens_out * p_out) / 1_000_000

print(cost('terra', 40_000, 3_000))  # 0.055
エージェントループ: 請求額は入力が決める#
編集は1回のリクエストだ。エージェントはそれを20回連続で行い、各ステップでファイルとこれまでの履歴を読み直す。20ステップのループで、各ステップが約30,000トークンを送り、約1,000トークンを受け取るとする。入力600,000トークン、出力20,000トークンだ。
Terraでは、入力が600,000 × 1.00 / 1,000,000 = 0.60、出力が20,000 × 5.00 / 1,000,000 = 0.10なので、0.60 + 0.10 = 0.70ドル。Solでは2倍の1.40、Lunaでは0.07に下がる。内訳を見てほしい。$0.70のうち$0.60は、モデルが書くものではなく、あなたが送るものだ。これはほとんどの人が想像する請求の形とは逆だ。
キャッシュは、プレフィックスが本当に繰り返されるなら状況を変える。各ステップの30,000トークンのうち25,000が同じプレフィックスでキャッシュにヒットすると仮定すると、新規入力が100,000 × 1.00 / 1,000,000 = 0.10、キャッシュ入力が500,000 × 0.05 / 1,000,000 = 0.025、出力0.10を加えて、Terraは0.10 + 0.025 + 0.10 = 0.225になる。仕組みはプロンプトキャッシュとは何かに、履歴が増え続ける理由はAIエージェントがなぜそんなに多くのトークンを使うのかにある。
下の計算機は同じループをCheapTokensのモデルで実行する。ステップ数とトークンを自分のエージェントに合わせて変えてほしい。
コスト計算機
CheapTokensモデルでの同じ20ステップのループ
リクエストあたりの入力トークン数: 30,000 · リクエストあたりの出力トークン数: 1,000 · 1日あたりのリクエスト数: 20
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0128 | $0.384 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.011 | $0.33 |
| MiniMax-M2.7$0.05$0.15 | $0.033 | $0.99 |
タスクごとのティアの選び方#
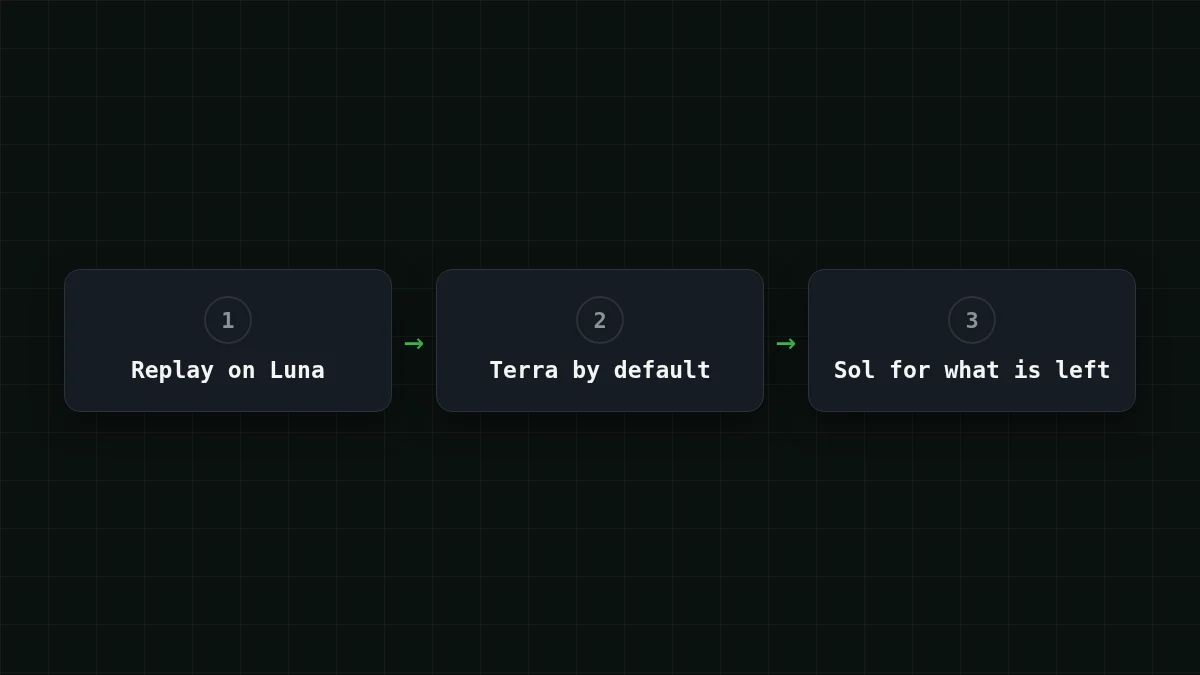
AI実験を行うあるTelegramチャンネルの作者が、CodexでTerraをSolやLunaと比較し、2026年10月28日に動画を公開した。彼の結論は、自身のタイトルにあるように、Terraは中間ティアでありそれは欠点ではないというものだ(投稿)。この捉え方は有用な指針になる。中間の段がデフォルトであり、他の2つには理由が必要だ。
その理由は通常リトライだ。同じトークン数なら、Terraの2回の試行は2 × 0.055 = 0.11で、Solの1回分に等しい。そしてLunaの10回の試行は10 × 0.0055 = 0.055で、Terraの1回分に等しい。つまり、ある種のタスクをSolだけが一発で成功させるなら、そのタスクではSolは元が取れる。Lunaがある種のタスクを10回に1回より多く成功させるなら、失敗を見直す時間を数える前から、Lunaの方が安く済む。
自分に最も近い状況を選ぼう。
ケースを選ぶ
どのティアから始めますか?
オプションを選択して答えを表示
何千もの小さなステップ
コミットメッセージ、チケットの分類、短いコードの説明。Lunaから始める。ステップあたりのコストはTerraの10分の1なので、極端でない失敗率ならどれでも安く済む。失敗し続けるステップの種類にだけ上げる。
日々の編集とリファクタリング
Terraから始めてそのまま留まる。価格表の中間の段であり、入力40K・出力3Kの1回の編集は$0.055だ。同じ種類のタスクがTerraで2回失敗してからSolを検討する。
Terraがすでに失敗したタスク
同じプロンプトでSolを1回試す。同じトークン数なら、それは2回目のTerraの試行と同じコストで、そのタスクに追加のティアが必要かどうかが分かる。
長いエージェントループ
請求額は入力が支配するので、まず各ステップが再送するものを削り、キャッシュのためにプレフィックスを安定させる。ティアはその後で選ぶ。
安価なオープンウェイトモデルで十分な場合#
同じ編集を3つのOpenAIティアと3つのCheapTokensモデルで、同じ入力40,000トークン、出力3,000トークンで比較する。
棒グラフは価格を示すもので、結果ではない。これらのモデルのどれかが自分の編集に十分かどうかは、Lunaと同じ方法で確認する。実際のタスクをリプレイし、diffを読むのだ。合格すれば、請求額はさらに下がる。エージェントループでは、DeepSeek-V4-Flashは380Kのコンテキスト、回答で最大32,768トークン、そして一日中いつでも同じ価格だ。GLM-5.3-Flashは390Kのコンテキスト、MiniMax-M2.7は180Kで、価格はすべて価格ページにあり、接続手順はドキュメントにある。
自分のタスクをリプレイする#
表はコストを与えてくれる。品質は午後のひとときで分かる。最近の履歴から10個のタスクを取り、それぞれをLunaで、次にTerraで実行し、diffを並べて見る。必要な数値はレスポンスのusageフィールドにあり、実行を正確に価格計算できる。CheapTokensでは次のようになる。
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Rename the variable x to retry_count in this function: ..."}]}'返ってくるJSONでは、usage.とusage.がそのタスクの入力と出力だ。これを上のcost()ヘルパーに渡せば、価格のあるどのモデルでもタスクあたりのコストが分かる。新しいティアのローンチ詳細はGPT-6.1 Terra API価格に、入力/出力の内訳は入力トークンと出力トークンにある。
クイックチェック
同じタスクをTerraとSolで同一のトークン数で実行する。価格表だけで何が分かるか?
答えを表示
答え: Solはちょうど2倍のコストになる。その行のすべての価格がTerraの2倍だから
入力、キャッシュ入力、出力はそれぞれSolでは2倍なので、どんな組み合わせでも請求額は2倍になる。余分な費用がより良い結果をもたらすかどうかは、リプレイだけが示せる部分だ。


