Mô hình & so sánhSo sánh
GPT-6.1 Terra vs Sol vs Luna cho lập trình: chi phí mỗi tác vụ
Terra, Sol hay Luna cho lập trình? Một tác vụ được định giá trên cả ba tier OpenAI, cách chọn nơi bắt đầu, và khi nào một model rẻ hơn là đủ.
Trên trang này
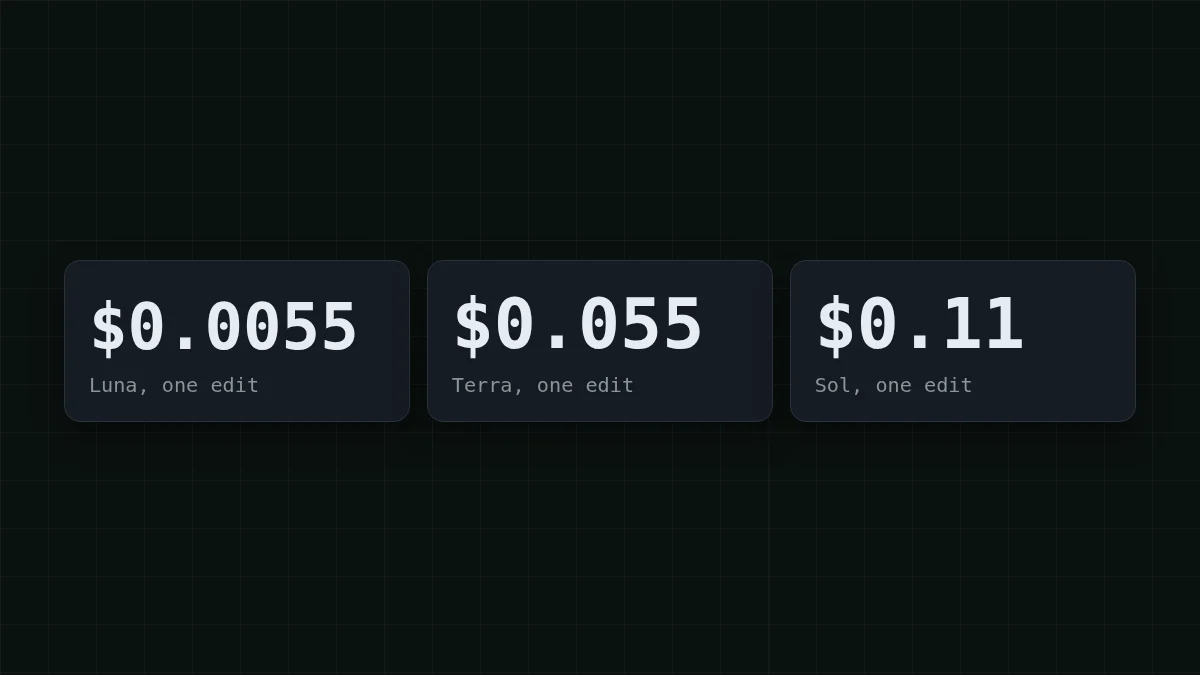
Phiên agent của bạn đã xong, diff trông ổn, và giờ bạn tự hỏi liệu có cần thiết phải dùng tier đắt nhất không. Câu trả lời ngắn: bắt đầu với Terra, gửi các bước đơn giản hàng loạt cho Luna, và chỉ trả tiền cho Sol với tác vụ mà Terra đã trượt. Trên một lần sửa giống hệt nhau (40.000 token vào, 3.000 ra), giá tiêu chuẩn của OpenAI cho ra $0.0055 trên Luna, $0.055 trên Terra và $0.11 trên Sol.
Bảng giá nói gì#
Trang giá của OpenAI (kiểm tra ngày 29 tháng 10 năm 2026, tier tiêu chuẩn, đầu vào tối đa 272K token) liệt kê các mức giá sau trên 1M token:
Cuộn bảng sang phải →
| Tier | Đầu vào | Đầu vào cache | Đầu ra | Một lần sửa: 40K vào, 3K ra |
|---|---|---|---|---|
GPT-6 Luna (gpt-6-luna) |
$0.10 | $0.01 | $0.50 | $0.0055 |
GPT-6.1 Terra (gpt-6.1-terra) |
$1.00 | $0.05 | $5.00 | $0.055 |
GPT-6.1 Sol (gpt-6.1-sol) |
$2.00 | $0.10 | $10.00 | $0.11 |
Quy luật rất gọn. Sol đúng gấp đôi Terra ở mọi cột. Luna bằng một phần mười Terra ở đầu vào và đầu ra, và một phần năm ở đầu vào cache. Vậy bậc thang chi phí là cố định, và câu hỏi thực sự là tần suất bậc rẻ hơn hoàn thành được việc.
Cột cuối là phép tính đơn giản. Trên Terra: 40.000 × 1.00 / 1.000.000 = 0.04 cho đầu vào và 3.000 × 5.00 / 1.000.000 = 0.015 cho đầu ra, vậy 0.04 + 0.015 = 0.055. Trên Sol cùng phép tính là 0.08 + 0.03 = 0.11, trên Luna là 0.004 + 0.0015 = 0.0055.
Một lần sửa, rồi năm mươi lần#
Giả sử bạn thực hiện 50 lần sửa như vậy mỗi ngày: viết lại một hàm, sửa các test bị hỏng, khoảng 40.000 token file và hướng dẫn vào và 3.000 token patch và giải thích ra. Một ngày khi đó tốn 50 × 0.055 = 2.75 đô trên Terra, 50 × 0.11 = 5.50 trên Sol và 50 × 0.0055 = 0.275 trên Luna.
Không ai cảm thấy $0.11 cho một lần sửa. Một tháng dùng Sol với nhịp đó là câu chuyện khác, và đó là lý do để quyết định tier một lần cho mỗi loại tác vụ thay vì một lần theo tâm trạng.
Đây là toàn bộ phép tính dưới dạng vài dòng bạn có thể dán và chạy lại với số token của riêng mình (giá ví dụ từ bảng trên, hãy thay bằng giá hiện tại):
PRICES = {  # $ per 1M tokens: (input, output), OpenAI, 29 Oct 2026
    'luna': (0.10, 0.50),
    'terra': (1.00, 5.00),
    'sol': (2.00, 10.00),
}

def cost(tier, tokens_in, tokens_out):
    p_in, p_out = PRICES[tier]
    return (tokens_in * p_in + tokens_out * p_out) / 1_000_000

print(cost('terra', 40_000, 3_000))  # 0.055
Vòng lặp agent: đầu vào là hóa đơn#
Một lần sửa là một request. Một agent là hai mươi request liên tiếp, và mỗi bước đọc lại các file và lịch sử cho đến lúc đó. Lấy một vòng lặp 20 bước mà mỗi bước gửi khoảng 30.000 token và nhận về khoảng 1.000. Đó là 600.000 token vào và 20.000 ra.
Trên Terra: 600.000 × 1.00 / 1.000.000 = 0.60 cho đầu vào và 20.000 × 5.00 / 1.000.000 = 0.10 cho đầu ra, vậy 0.60 + 0.10 = 0.70 đô. Sol nhân đôi thành 1.40, Luna giảm xuống 0.07. Hãy nhìn vào tỷ lệ: $0.60 trong $0.70 là phần bạn gửi, không phải phần model viết. Đó là ngược với cách hầu hết mọi người hình dung hóa đơn.
Cache thay đổi bức tranh, nếu tiền tố của bạn thực sự lặp lại. Giả sử 25.000 trong 30.000 token mỗi bước là cùng một tiền tố và trúng cache: 100.000 × 1.00 / 1.000.000 = 0.10 đầu vào mới, 500.000 × 0.05 / 1.000.000 = 0.025 đầu vào cache, cộng 0.10 đầu ra, vậy Terra ra 0.10 + 0.025 + 0.10 = 0.225. Cách hoạt động nằm trong prompt caching là gì; lý do lịch sử cứ tăng là trong tại sao AI agent dùng nhiều token đến vậy.
Máy tính bên dưới chạy cùng vòng lặp trên các model CheapTokens. Thay đổi số bước và token cho khớp với agent của bạn.
Máy tính chi phí
Cùng vòng lặp 20 bước trên các model CheapTokens
Token đầu vào mỗi yêu cầu: 30.000 · Token đầu ra mỗi yêu cầu: 1.000 · Số yêu cầu mỗi ngày: 20
| Mô hình | Mỗi ngày | Mỗi tháng |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0128 | $0.384 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.011 | $0.33 |
| MiniMax-M2.7$0.05$0.15 | $0.033 | $0.99 |
Tier nào cho tác vụ nào#
Một tác giả kênh Telegram, người chạy các thí nghiệm AI, đã so sánh Terra với Sol và Luna trong Codex và công bố video ngày 28 tháng 10 năm 2026. Kết luận của anh ấy, trong chính tiêu đề, là Terra là tier trung gian và đó không phải là nhược điểm (bài đăng). Cách đặt vấn đề đó là một chỉ dẫn hữu ích: bậc giữa là mặc định, và hai bậc còn lại cần lý do.
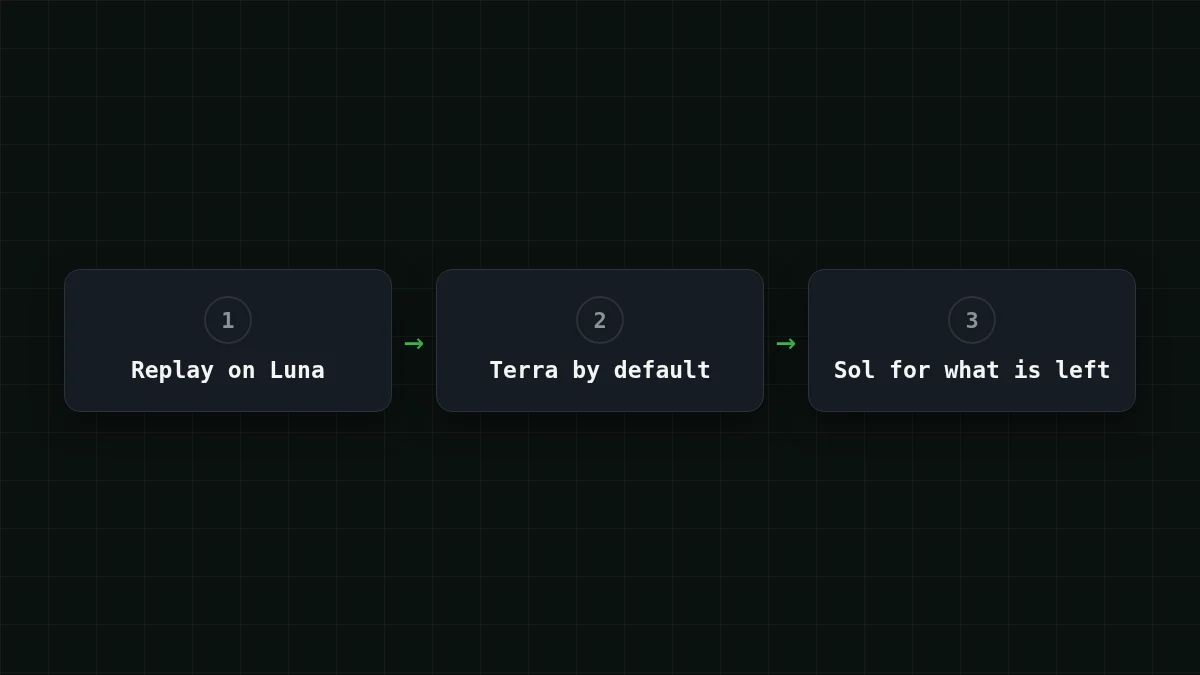
Lý do thường là thử lại. Với cùng số token, hai lần thử Terra tốn 2 × 0.055 = 0.11, tức một lần thử Sol. Và mười lần thử Luna tốn 10 × 0.0055 = 0.055, tức một lần thử Terra. Vậy nếu Sol là tier duy nhất hoàn thành một loại tác vụ ngay lần đầu, nó tự trả tiền cho những tác vụ đó. Nếu Luna hoàn thành một loại tác vụ hơn một lần trong mười, đó là cách rẻ hơn để làm chúng, trước khi tính thời gian xem lại các lần trượt.
Chọn tình huống gần nhất với bạn:
Chọn trường hợp của bạn
Bạn bắt đầu với tier nào?
Chọn một tùy chọn để xem đáp án
Hàng nghìn bước nhỏ
Commit message, phân loại ticket, giải thích code ngắn. Bắt đầu với Luna: chi phí mỗi bước bằng một phần mười Terra, nên bất kỳ tỷ lệ trượt nào không quá cao vẫn rẻ hơn. Chỉ nâng cấp cho loại bước cứ thất bại.
Sửa và refactor hàng ngày
Bắt đầu với Terra và ở đó. Đó là bậc giữa của bảng giá, và một lần sửa 40K vào và 3K ra tốn $0.055. Chỉ xem Sol sau khi cùng loại tác vụ đã trượt trên Terra hai lần.
Tác vụ Terra đã trượt
Thử Sol một lần với cùng prompt. Với cùng số token, chi phí bằng lần thử Terra thứ hai, và bạn biết liệu tier cao hơn có phải là thứ tác vụ cần không.
Vòng lặp agent dài
Hóa đơn bị chi phối bởi đầu vào, nên trước tiên hãy cắt những gì mỗi bước gửi lại và giữ tiền tố ổn định cho cache. Chọn tier sau đó, không phải trước.
Khi nào một model open-weight rẻ hơn là đủ#
Cùng một lần sửa trên ba tier OpenAI bên cạnh ba model CheapTokens, với cùng 40.000 token vào và 3.000 ra:
Các thanh hiển thị giá, không phải kết quả. Liệu một trong các model này có đủ tốt cho các lần sửa của bạn là điều bạn kiểm tra giống như với Luna: chạy lại các tác vụ thực và đọc diff. Nếu nó vượt qua, hóa đơn giảm thêm. Với vòng lặp agent, DeepSeek-V4-Flash có context 380K, tối đa 32.768 token trong một câu trả lời và một mức giá bất kể giờ nào trong ngày. GLM-5.3-Flash có context 390K và MiniMax-M2.7 có 180K; mọi giá nằm trên trang giá, và các bước kết nối nằm trong tài liệu.
Chạy lại tác vụ của chính bạn#
Bảng cho bạn chi phí. Chất lượng bạn tìm ra trong một buổi chiều: lấy mười tác vụ từ lịch sử gần đây, chạy từng tác vụ trên Luna, rồi trên Terra, và đặt các diff cạnh nhau. Các con số duy nhất bạn cần nằm trong response, ở trường usage, giúp định giá một lần chạy chính xác. Với CheapTokens nó trông như thế này:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Rename the variable x to retry_count in this function: ..."}]}'
Trong JSON trả về, usage. và usage. là đầu vào và đầu ra của bạn cho tác vụ đó. Đưa chúng vào helper cost() ở trên, và bạn có chi phí mỗi tác vụ cho bất kỳ model nào có giá. Để biết chi tiết ra mắt của tier mới, xem giá API GPT-6.1 Terra; để biết cách chia đầu vào/đầu ra, xem token đầu vào so với đầu ra.
Kiểm tra nhanh
Bạn chạy cùng một tác vụ trên Terra và trên Sol với số token giống hệt nhau. Chỉ bảng giá nói cho bạn điều gì?
Hiện đáp án
Trả lời: Sol tốn đúng gấp đôi, vì mọi giá trên hàng của nó gấp đôi Terra
Đầu vào, đầu vào cache và đầu ra đều gấp 2× trên Sol, nên hóa đơn gấp 2× bất kể tỷ lệ pha trộn. Liệu số tiền thêm có mua được kết quả tốt hơn là phần chỉ lần chạy lại của bạn mới cho thấy.


