Modelle & VergleicheVergleich
GPT-6.1 Terra vs. Sol vs. Luna fürs Coding: Kosten pro Aufgabe
Terra, Sol oder Luna fürs Coding? Eine Aufgabe bepreist auf allen drei OpenAI-Stufen, eine Methode zur Wahl des Einstiegs und wann ein günstigeres Modell reicht.
Auf dieser Seite
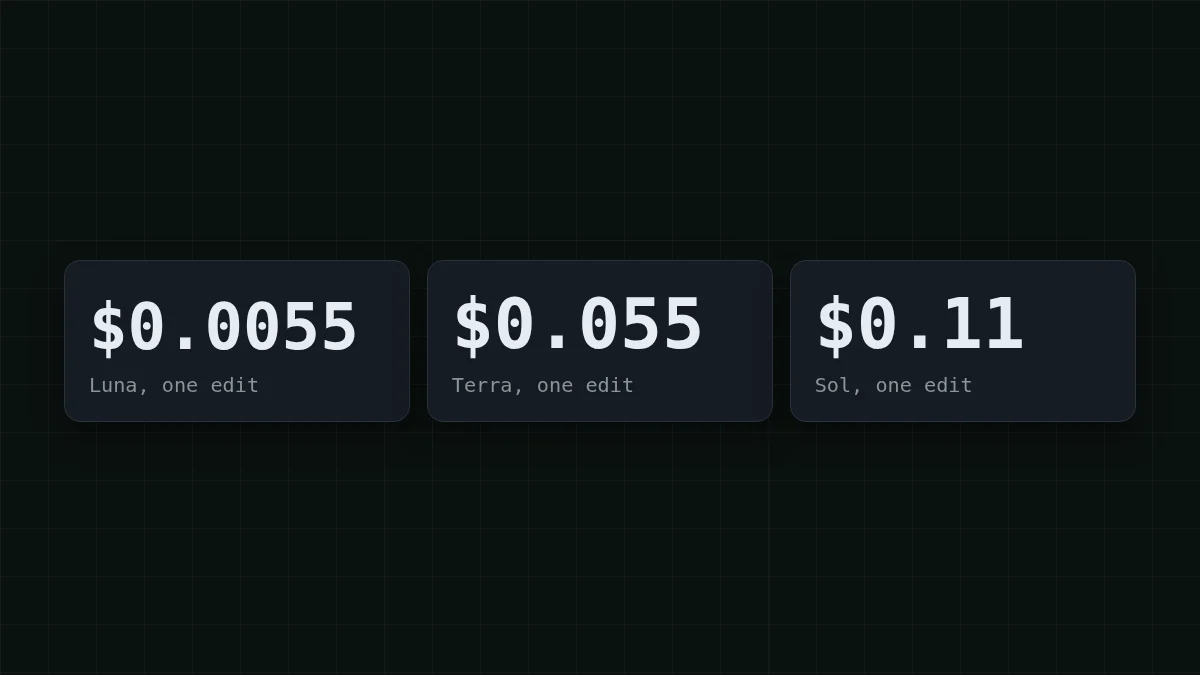
Deine Agent-Session ist beendet, der Diff sieht gut aus, und jetzt fragst du dich, ob die teuerste Stufe nötig war. Kurze Antwort: Starte auf Terra, schicke einfache Massenschritte an Luna, und zahle für Sol nur bei der Aufgabe, die Terra bereits verfehlt hat. Bei einem identischen Edit (40.000 Tokens rein, 3.000 raus) ergeben die OpenAI-Standardpreise 0,0055 $ auf Luna, 0,055 $ auf Terra und 0,11 $ auf Sol.
Was die Preisliste sagt#
OpenAIs Preisseite (geprüft am 29. Oktober 2026, Standardstufe, Input bis 272K Tokens) listet diese Preise pro 1M Tokens:
Tabelle nach rechts scrollen →
| Stufe | Input | Gecachter Input | Output | Ein Edit: 40K rein, 3K raus |
|---|---|---|---|---|
GPT-6 Luna (gpt-6-luna) |
0,10 $ | 0,01 $ | 0,50 $ | 0,0055 $ |
GPT-6.1 Terra (gpt-6.1-terra) |
1,00 $ | 0,05 $ | 5,00 $ | 0,055 $ |
GPT-6.1 Sol (gpt-6.1-sol) |
2,00 $ | 0,10 $ | 10,00 $ | 0,11 $ |
Das Muster ist sauber. Sol ist in jeder Spalte genau doppelt so teuer wie Terra. Luna kostet ein Zehntel von Terra bei Input und Output und ein Fünftel beim gecachten Input. Die Kostenleiter ist also fest, und die eigentliche Frage ist, wie oft eine günstigere Sprosse die Aufgabe erledigt.
Die letzte Spalte ist reine Arithmetik. Auf Terra: 40.000 × 1,00 / 1.000.000 = 0,04 für den Input und 3.000 × 5,00 / 1.000.000 = 0,015 für den Output, also 0,04 + 0,015 = 0,055. Auf Sol ist dieselbe Summe 0,08 + 0,03 = 0,11, auf Luna 0,004 + 0,0015 = 0,0055.
Ein Edit, dann fünfzig davon#
Sagen wir, du machst 50 solcher Edits pro Tag: eine Funktion umschreiben, die Tests reparieren, die sie kaputt gemacht hat, etwa 40.000 Tokens an Dateien und Anweisungen rein und 3.000 Tokens an Patch und Erklärung raus. Ein Tag kostet dann 50 × 0,055 = 2,75 Dollar auf Terra, 50 × 0,11 = 5,50 auf Sol und 50 × 0,0055 = 0,275 auf Luna.
Niemand spürt 0,11 $ bei einem Edit. Ein Monat Sol in diesem Tempo ist ein anderes Gespräch, und genau deshalb entscheidet man die Stufe einmal pro Aufgabenart statt einmal pro Laune.
Hier ist die ganze Rechnung als ein paar Zeilen, die du einfügen und mit deinen eigenen Token-Zahlen erneut ausführen kannst (Beispielpreise aus der Tabelle oben, aktuelle einsetzen):
PRICES = {  # $ per 1M tokens: (input, output), OpenAI, 29 Oct 2026
    'luna': (0.10, 0.50),
    'terra': (1.00, 5.00),
    'sol': (2.00, 10.00),
}

def cost(tier, tokens_in, tokens_out):
    p_in, p_out = PRICES[tier]
    return (tokens_in * p_in + tokens_out * p_out) / 1_000_000

print(cost('terra', 40_000, 3_000))  # 0.055
Agent-Loops: der Input ist die Rechnung#
Ein Edit ist eine Anfrage. Ein Agent sind zwanzig davon hintereinander, und jeder Schritt liest die Dateien und die bisherige Historie erneut. Nimm einen Loop von 20 Schritten, bei dem jeder Schritt etwa 30.000 Tokens sendet und etwa 1.000 zurückbekommt. Das sind 600.000 Tokens rein und 20.000 raus.
Auf Terra: 600.000 × 1,00 / 1.000.000 = 0,60 für den Input und 20.000 × 5,00 / 1.000.000 = 0,10 für den Output, also 0,60 + 0,10 = 0,70 Dollar. Sol verdoppelt das auf 1,40, Luna senkt es auf 0,07. Schau dir die Aufteilung an: 0,60 $ der 0,70 $ sind das, was du sendest, nicht das, was das Modell schreibt. Das ist das Gegenteil dessen, wie sich die meisten die Rechnung vorstellen.
Caching ändert das Bild, wenn sich dein Präfix wirklich wiederholt. Angenommen, 25.000 der 30.000 Tokens in jedem Schritt sind dasselbe Präfix und treffen den Cache: 100.000 × 1,00 / 1.000.000 = 0,10 frischer Input, 500.000 × 0,05 / 1.000.000 = 0,025 gecachter Input, plus 0,10 Output, also landet Terra bei 0,10 + 0,025 + 0,10 = 0,225. Wie das funktioniert, steht in was Prompt-Caching ist; warum die Historie immer weiter wächst, in warum KI-Agenten so viele Tokens verbrauchen.
Der Rechner unten führt denselben Loop auf CheapTokens-Modellen aus. Ändere die Schritte und die Tokens passend zu deinem Agenten.
Kostenrechner
Derselbe 20-Schritte-Loop auf CheapTokens-Modellen
Eingabe-Tokens pro Anfrage: 30.000 · Ausgabe-Tokens pro Anfrage: 1.000 · Anfragen pro Tag: 20
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0128 | $0.384 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.011 | $0.33 |
| MiniMax-M2.7$0.05$0.15 | $0.033 | $0.99 |
Welche Stufe für welche Aufgabe#
Ein Telegram-Kanal-Autor, der KI-Experimente macht, hat Terra mit Sol und Luna in Codex verglichen und am 28. Oktober 2026 ein Video veröffentlicht. Seine Erkenntnis, in seinem eigenen Titel, ist, dass Terra eine mittlere Stufe ist und das kein Nachteil (der Beitrag). Diese Einordnung ist ein nützlicher Hinweis: Die mittlere Sprosse ist der Standard, und die anderen beiden brauchen einen Grund.
Der Grund sind meist Retries. Bei gleichen Token-Zahlen kosten zwei Terra-Versuche 2 × 0,055 = 0,11, was einem Sol-Versuch entspricht. Und zehn Luna-Versuche kosten 10 × 0,0055 = 0,055, was einem Terra-Versuch entspricht. Wenn Sol also die einzige Stufe ist, die eine Aufgabenklasse beim ersten Mal trifft, zahlt sie sich bei diesen Aufgaben selbst. Wenn Luna eine Aufgabenklasse öfter als einmal in zehn Versuchen trifft, ist es der günstigere Weg dorthin, bevor du die Zeit für das Prüfen der Fehlversuche zählst.
Wähle die Situation, die deiner am nächsten kommt:
Wähle deinen Fall
Auf welcher Stufe startest du?
Wähle eine Option, um die Antwort zu sehen
Tausende kleiner Schritte
Commit-Nachrichten, Tickets klassifizieren, kurze Code-Erklärungen. Starte auf Luna: Die Kosten pro Schritt sind ein Zehntel von Terra, also kommt jede Fehlerrate, die nicht extrem ist, trotzdem günstiger weg. Steige nur für den Schritttyp hoch, der immer wieder scheitert.
Tägliche Edits und Refactorings
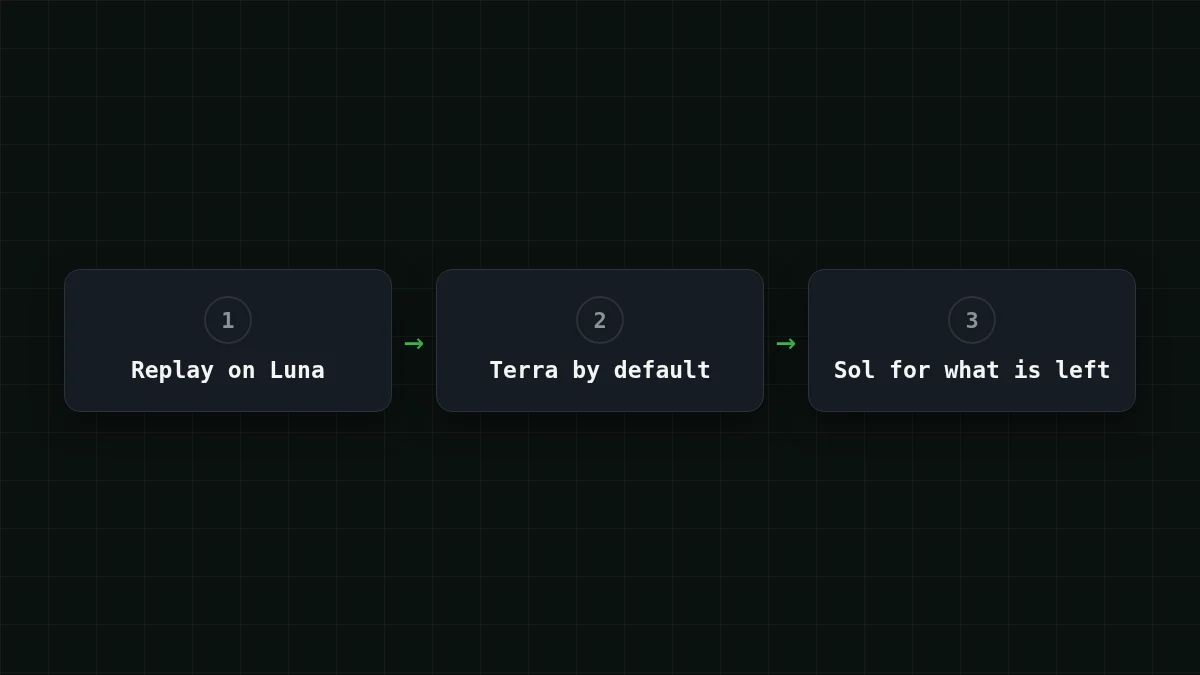
Starte auf Terra und bleib dort. Es ist die mittlere Sprosse der Preisliste, und ein Edit mit 40K rein und 3K raus kostet 0,055 $. Schau dir Sol erst an, nachdem dieselbe Aufgabenart auf Terra zweimal gescheitert ist.
Eine Aufgabe, die Terra bereits verfehlt hat
Probiere Sol einmal mit demselben Prompt. Bei gleichen Tokens kostet das dasselbe wie der zweite Terra-Versuch gekostet hätte, und du erfährst, ob die zusätzliche Stufe das ist, was die Aufgabe braucht.
Ein langer Agent-Loop
Die Rechnung wird vom Input dominiert, also kürze zuerst, was jeder Schritt erneut sendet, und halte das Präfix für Caching stabil. Wähle die Stufe danach, nicht davor.
Wann ein günstigeres Open-Weight-Modell reicht#
Derselbe Edit auf den drei OpenAI-Stufen neben drei CheapTokens-Modellen, mit denselben 40.000 Tokens rein und 3.000 raus:
Die Balken zeigen den Preis, nicht die Ergebnisse. Ob eines dieser Modelle für deine Edits gut genug ist, prüfst du genauso wie bei Luna: echte Aufgaben erneut abspielen und die Diffs lesen. Wenn es besteht, sinkt die Rechnung weiter. Für Agent-Loops hat DeepSeek-V4-Flash einen 380K-Kontext, bis zu 32.768 Tokens in einer Antwort und einen Preis zu jeder Tageszeit. GLM-5.3-Flash hat einen 390K-Kontext und MiniMax-M2.7 einen 180K-Kontext; alle Preise stehen auf der Preisseite, und die Verbindungsschritte stehen in der Dokumentation.
Spiele deine eigenen Aufgaben erneut ab#
Die Tabelle liefert dir die Kosten. Die Qualität findest du an einem Nachmittag heraus: Nimm zehn Aufgaben aus deiner jüngsten Historie, führe jede auf Luna und dann auf Terra aus, und lege die Diffs nebeneinander. Die einzigen Zahlen, die du brauchst, stehen in der Antwort im Feld usage, was es einfach macht, einen Lauf exakt zu bepreisen. Mit CheapTokens sieht das so aus:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Rename the variable x to retry_count in this function: ..."}]}'
Im zurückkommenden JSON sind usage. und usage. dein Input und Output für diese Aufgabe. Gib sie in den cost()-Helfer oben ein, und du hast die Kosten pro Aufgabe für jedes Modell mit einem Preis. Zu den Launch-Details der neuen Stufe siehe GPT-6.1 Terra API-Preis; zur Input/Output-Aufteilung siehe Input vs. Output Tokens.
Kurzer Check
Du führst dieselbe Aufgabe auf Terra und auf Sol mit identischen Token-Zahlen aus. Was sagt dir allein die Preisliste?
Antwort anzeigen
Antwort: Sol kostet genau doppelt so viel, weil jeder Preis in seiner Zeile doppelt so hoch ist wie bei Terra
Input, gecachter Input und Output sind auf Sol jeweils 2×, also ist die Rechnung 2×, egal wie die Mischung aussieht. Ob das zusätzliche Geld ein besseres Ergebnis bringt, kann nur dein Replay zeigen.


