KI-NewsUpdate
GPT-6.1 Terra API-Preis: 1 $ in, 5 $ out pro 1M Tokens
Was OpenAIs neuer GPT-6.1 Terra-Preis für eine 20-Schritte-Agent-Aufgabe bedeutet, neben dem alten GPT-5.6 Terra-Preis und günstigeren Modellen.
Auf dieser Seite
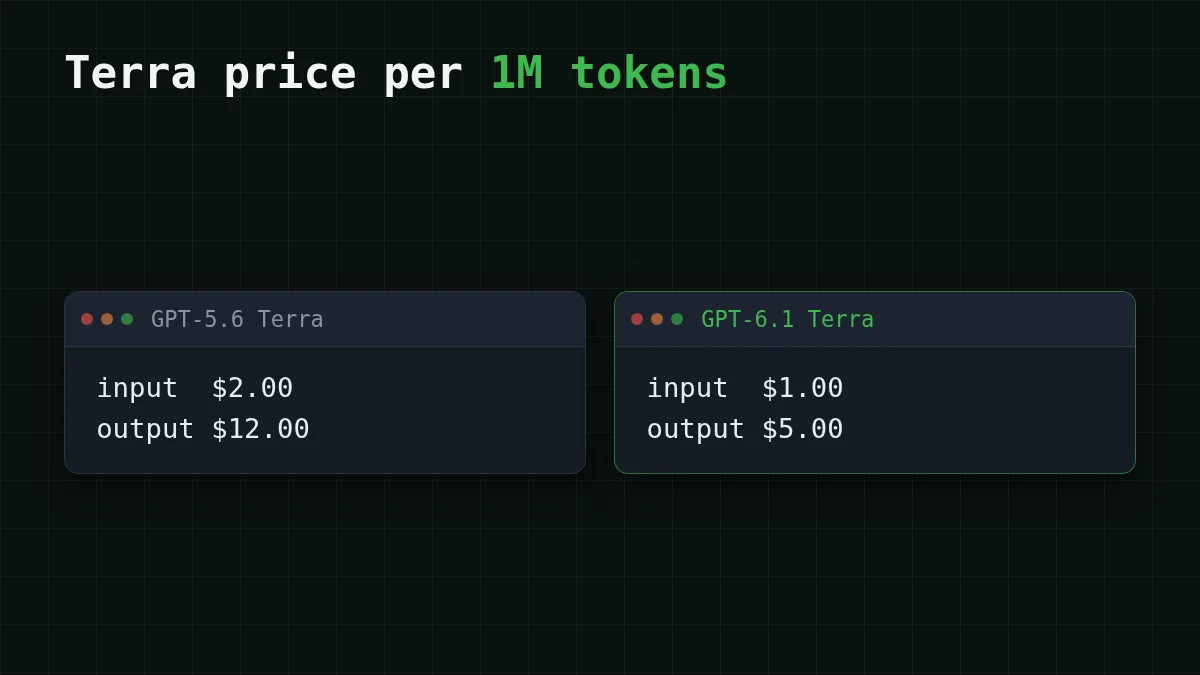
GPT-6.1 Terra ist auf der API-Preisseite von OpenAI mit 1,00 $ pro 1M Input-Tokens und 5,00 $ pro 1M Output-Tokens gelistet (geprüft am 27. Oktober 2026). Das vorherige Terra, GPT-5.6 Terra, ist auf derselben Seite mit 2,00 $ und 12,00 $ gelistet. Wenn dein Coding-Agent auf GPT-5.6 Terra läuft, halbiert der Wechsel zu GPT-6.1 Terra die Rechnung für dieselbe Aufgabe ungefähr. Unten: um wie viel bei einer typischen Agent-Aufgabe, und wo du mit einem günstigeren Modell weiter kommst.
Was sich auf der Preisseite geändert hat#
GPT-6.1 Terra ist auf OpenAIs Preisseite gelistet (geprüft am 27. Oktober 2026) mit der API-ID gpt-6.1-terra. Der Input ist auf die Hälfte des alten Preises gefallen. Der Output ging von 12,00 $ auf 5,00 $. Die zweite Zahl ist wichtiger, als sie aussieht: Agenten schreiben viel, und der Output ist die teure Seite.
Die Seite hat aber mehr als eine Zeile, und die falsche zu erwählen ist der einfachste Weg, von einer Rechnung überrascht zu werden:
Paare zuordnen
Ordne jede Stufe auf der Preisseite ihren Tarifen zu
Tippe auf ein Element links, dann auf sein Paar
- Standard, Input bis 272K Tokens1,00 $ in, 5,00 $ out pro 1M
- Input über 272K Tokens2,00 $ in, 7,50 $ out pro 1M
- Batch / Flex0,50 $ in, 2,50 $ out pro 1M
- Fast2,00 $ in, 10,00 $ out pro 1M
Gecachter Input ist separat mit 0,05 $ pro 1M in der Standard-Stufe gelistet, was hilft, wenn jeder Schritt eines Agenten denselben langen Prefix erneut sendet. Der Rest dieses Artikels verwendet die Standard-Stufe und kein Caching, damit die Zahlen leicht nachzurechnen sind.
Was eine 20-Schritte-Agent-Aufgabe kostet#
Sagen wir, dein Agent löst ein Ticket in 20 Schritten. Jeder Schritt sendet die Aufgabe, die geöffneten Dateien und die bisherigen Tool-Ergebnisse, im Durchschnitt etwa 30.000 Input-Tokens, und schreibt etwa 1.500 Tokens zurück (ein Plan, ein Patch, ein Befehl). Das ist eine unscheinbare Annahme, und genau sie macht Agenten teuer: Der Input wird bei jedem Schritt erneut gesendet. (Falls das neu für dich ist, warum KI-Agenten so viele Tokens verbrauchen geht das durch.)
Eine Aufgabe summiert sich dann auf 20 × 30.000 = 600.000 Input-Tokens und 20 × 1.500 = 30.000 Output-Tokens. Jeder Schritt bleibt weit unter der 272K-Grenze, also gelten die Standard-Tarife.
- GPT-6.1 Terra: 0,6 × 1,00 $ = 0,60 $ für Input, 0,03 × 5,00 $ = 0,15 $ für Output, 0,60 $ + 0,15 $ = 0,75 $ pro Aufgabe.
- GPT-5.6 Terra: 0,6 × 2,00 $ = 1,20 $ für Input, 0,03 × 12,00 $ = 0,36 $ für Output, 1,20 $ + 0,36 $ = 1,56 $ pro Aufgabe.
Jetzt skaliere es. Ein Team, das 100 solcher Aufgaben pro Tag abschließt, zahlt 100 × 0,75 $ = 75 $ pro Tag mit dem neuen Modell gegenüber 100 × 1,56 $ = 156 $ mit dem alten. Eine echte Senkung, und keine Änderung an deinem Code außer der Modell-ID.
Dieselbe Aufgabe auf den Modellen, die wir anbieten, zu Live-Preisen (ein Schritt ist 30.000 in und 1.500 out, mal 20 Schritte):
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 20 Anfragen | OpenRouter, 20 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0271 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0332 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.216 |
30.000 Input- und 1.500 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Für eine ganze Aufgabe kommt DeepSeek-V4-Flash auf $0.012, GLM-5.3-Flash auf $0.0132 und MiniMax-M2.7 auf $0.0345. Die Tabelle zeigt auch den OpenRouter-Preis für jedes davon, und insgesamt, mit Input und Output zusammengerechnet, ist CheapTokens die günstigere Seite.
Bevor du eine ganze Pipeline umstellst, schicke eine Handvoll deiner eigenen Tickets an das Kandidatenmodell und vergleiche die Token-Zahlen im usage-Block mit der Tabelle oben.
Welches Modell für welche Aufgabe#
Wenn der Preisrückgang dich zu Terra gezogen hat, frage zuerst, was deine Schleife eigentlich braucht. Lange Verläufe, lange Antworten, ein knappes Budget: Das sind drei verschiedene Aufgaben, und wir haben für jede ein Modell.
Wähle deinen Fall
Wähle die Aufgabe, die deiner am nächsten kommt
Wähle eine Option, um die Antwort zu sehen
Eine lange Coding-Agent-Schleife
Nimm DeepSeek-V4-Flash. Es hat einen 380K-Kontext, schreibt bis zu 32.768 Output-Tokens pro Antwort und kostet zu jeder Tageszeit gleich viel. Das passt zu Agenten, die viele Dateien lesen und dann große Patches schreiben.
Alltägliches Coding und Chat
Nimm GLM-5.3-Flash. Es hat einen 390K-Kontext und antwortet mit bis zu 8.192 Tokens, und insgesamt ist es für dieselben Tokens günstiger als OpenRouter.
Agent-Arbeit mit knappem Budget
Nimm MiniMax-M2.7. Es hat einen 180K-Kontext und antwortet mit bis zu 8.192 Tokens, und insgesamt ist es für dieselben Tokens günstiger als OpenRouter.
Alle drei laufen über ein Guthaben und sprechen sowohl die OpenAI- als auch die Anthropic-API, sodass der Wechsel zwischen ihnen eine einzeilige Änderung der Modell-ID ist.
Probiere es mit deiner eigenen Aufgabe#
Schicke einen deiner echten Prompts an ein günstigeres Modell und lies den usage-Block in der Antwort. Er nennt dir die exakten Input- und Output-Tokens, die du mit dem oben angenommenen Schritt von 30.000 in / 1.500 out vergleichen kannst. Beispielanfrage (die Adresse und die Modell-ID sind die zum Kopieren; halte deinen Key in einer Umgebungsvariable):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Write a unit test for a function that parses ISO dates."}],
    "max_tokens": 800
  }'
Das vollständige Setup steht in der CheapTokens-Doku, die Live-Preisliste auf der Preisseite, und wie man die Kosten eines KI-Agenten schätzt zeigt, wie du deine eigenen Logs in die zwei Zahlen verwandelst, mit denen dieser Artikel begonnen hat.


