Noticias de IAActualización
Precio de la API de GPT-6.1 Terra: $1 entrada, $5 salida por 1M de tokens
Qué significa el nuevo precio de GPT-6.1 Terra de OpenAI para una tarea de agente de 20 pasos, junto al antiguo precio de GPT-5.6 Terra y modelos más baratos.
En esta página
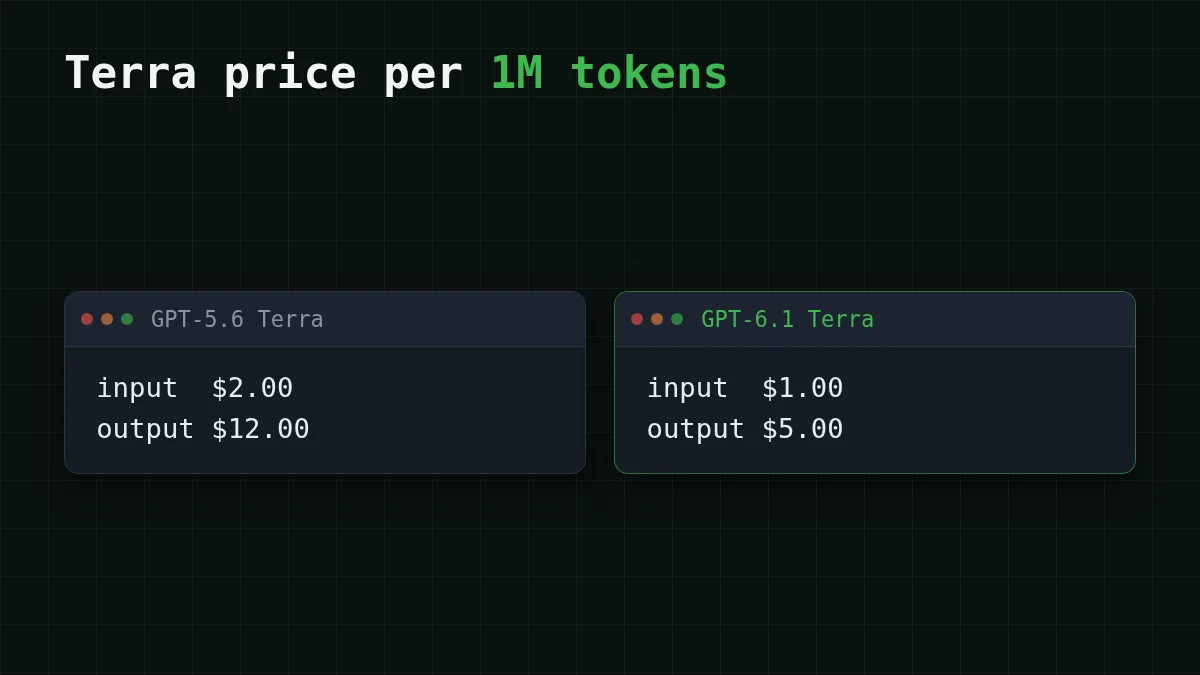
GPT-6.1 Terra aparece a $1.00 por 1M de tokens de entrada y $5.00 por 1M de tokens de salida en la página de precios de la API de OpenAI (consultada el 27 de octubre de 2026). El Terra anterior, GPT-5.6 Terra, aparece en la misma página a $2.00 y $12.00. Si tu agente de programación funciona con GPT-5.6 Terra, cambiarlo a GPT-6.1 Terra reduce aproximadamente a la mitad la factura para la misma tarea. A continuación: cuánto para una tarea típica de agente, y dónde un modelo más barato te lleva más lejos.
Qué cambió en la página de precios#
GPT-6.1 Terra aparece en la página de precios de OpenAI (consultada el 27 de octubre de 2026) con el id de API gpt-6.1-terra. La entrada bajó a la mitad del precio anterior. La salida pasó de $12.00 a $5.00. Ese segundo número importa más de lo que parece: los agentes escriben mucho, y la salida es el lado caro.
La página tiene más de una fila, sin embargo, y elegir la equivocada es la forma más fácil de llevarse una sorpresa en la factura:
Emparejar los pares
Relaciona cada nivel de la página de precios con sus tarifas
Toca un elemento de la izquierda, luego su par
- Estándar, entrada hasta 272K tokens$1.00 entrada, $5.00 salida por 1M
- Entrada por encima de 272K tokens$2.00 entrada, $7.50 salida por 1M
- Batch / Flex$0.50 entrada, $2.50 salida por 1M
- Fast$2.00 entrada, $10.00 salida por 1M
La entrada en caché aparece por separado a $0.05 por 1M en el nivel estándar, lo que ayuda cuando cada paso de un agente reenvía el mismo prefijo largo. El resto de este artículo usa el nivel estándar y sin caché, así que los números son fáciles de recalcular.
Cuánto cuesta una tarea de agente de 20 pasos#
Supongamos que tu agente resuelve un ticket en 20 pasos. Cada paso envía la tarea, los archivos que ha abierto y los resultados de herramientas hasta el momento, unos 30,000 tokens de entrada de media, y escribe unos 1,500 tokens de vuelta (un plan, un parche, un comando). Es una suposición que parece simple, y es la que hace caros a los agentes: la entrada se reenvía en cada paso. (Si esa parte es nueva, por qué los agentes de IA usan tantos tokens lo explica.)
Una tarea entonces suma 20 × 30,000 = 600,000 tokens de entrada y 20 × 1,500 = 30,000 tokens de salida. Cada paso se mantiene muy por debajo de la línea de 272K, así que se aplican las tarifas estándar.
- GPT-6.1 Terra: 0.6 × $1.00 = $0.60 por entrada, 0.03 × $5.00 = $0.15 por salida, $0.60 + $0.15 = $0.75 por tarea.
- GPT-5.6 Terra: 0.6 × $2.00 = $1.20 por entrada, 0.03 × $12.00 = $0.36 por salida, $1.20 + $0.36 = $1.56 por tarea.
Ahora escálalo. Un equipo que cierra 100 tareas de ese tipo al día paga 100 × $0.75 = $75 al día con el modelo nuevo frente a 100 × $1.56 = $156 con el anterior. Un recorte real, y sin cambios en tu código salvo el id del modelo.
La misma tarea en los modelos que servimos, a precios en vivo (un paso es 30,000 de entrada y 1,500 de salida, por 20 pasos):
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 20 solicitudes | OpenRouter, 20 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0271 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0332 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.216 |
30.000 tokens de entrada y 1500 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Para una tarea completa, DeepSeek-V4-Flash sale por $0.012, GLM-5.3-Flash por $0.0132 y MiniMax-M2.7 por $0.0345. La tabla también muestra el precio de OpenRouter para cada uno de ellos, y en total, contando entrada y salida juntas, CheapTokens es el lado más barato.
Antes de mover todo un pipeline, envía un puñado de tus propios tickets al modelo candidato y compara los recuentos de tokens del bloque usage con la tabla anterior.
Qué modelo para qué trabajo#
Si la bajada de precio te acercó a Terra, pregúntate primero qué necesita realmente tu bucle. Historiales largos, respuestas largas, un presupuesto ajustado: son tres trabajos distintos, y tenemos un modelo para cada uno.
Elige tu caso
Elige el trabajo más parecido al tuyo
Elige una opción para ver la respuesta
Un bucle largo de agente de programación
Usa DeepSeek-V4-Flash. Tiene un contexto de 380K, escribe hasta 32,768 tokens de salida por respuesta y cuesta lo mismo a cualquier hora del día. Eso encaja con agentes que leen muchos archivos y luego escriben parches grandes.
Programación y chat del día a día
Usa GLM-5.3-Flash. Tiene un contexto de 390K y responde hasta 8,192 tokens, y en total es más barato que OpenRouter para los mismos tokens.
Trabajo de agente con presupuesto ajustado
Usa MiniMax-M2.7. Tiene un contexto de 180K y responde hasta 8,192 tokens, y en total es más barato que OpenRouter para los mismos tokens.
Los tres están detrás de un solo saldo y hablan tanto la API de OpenAI como la de Anthropic, así que cambiar entre ellos es un cambio de una línea en el id del modelo.
Pruébalo con tu propia tarea#
Envía uno de tus prompts reales a un modelo más barato y lee el bloque usage en la respuesta. Te indica los tokens exactos de entrada y salida, que puedes comparar con el paso de 30,000 de entrada / 1,500 de salida asumido arriba. Petición de ejemplo (la dirección y el id del modelo son los que hay que copiar; guarda tu clave en una variable de entorno):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Write a unit test for a function that parses ISO dates."}],
    "max_tokens": 800
  }'
La configuración completa está en la documentación de CheapTokens, la lista de precios en vivo está en la página de precios, y cómo estimar el coste de un agente de IA muestra cómo convertir tus propios registros en los dos números con los que empezó este artículo.


