AI 뉴스업데이트
GPT-6.1 Terra API 가격: 1M 토큰당 입력 $1, 출력 $5
OpenAI의 새 GPT-6.1 Terra 가격이 20단계 에이전트 작업에 무엇을 의미하는지, 이전 GPT-5.6 Terra 가격 및 더 저렴한 모델과 비교합니다.
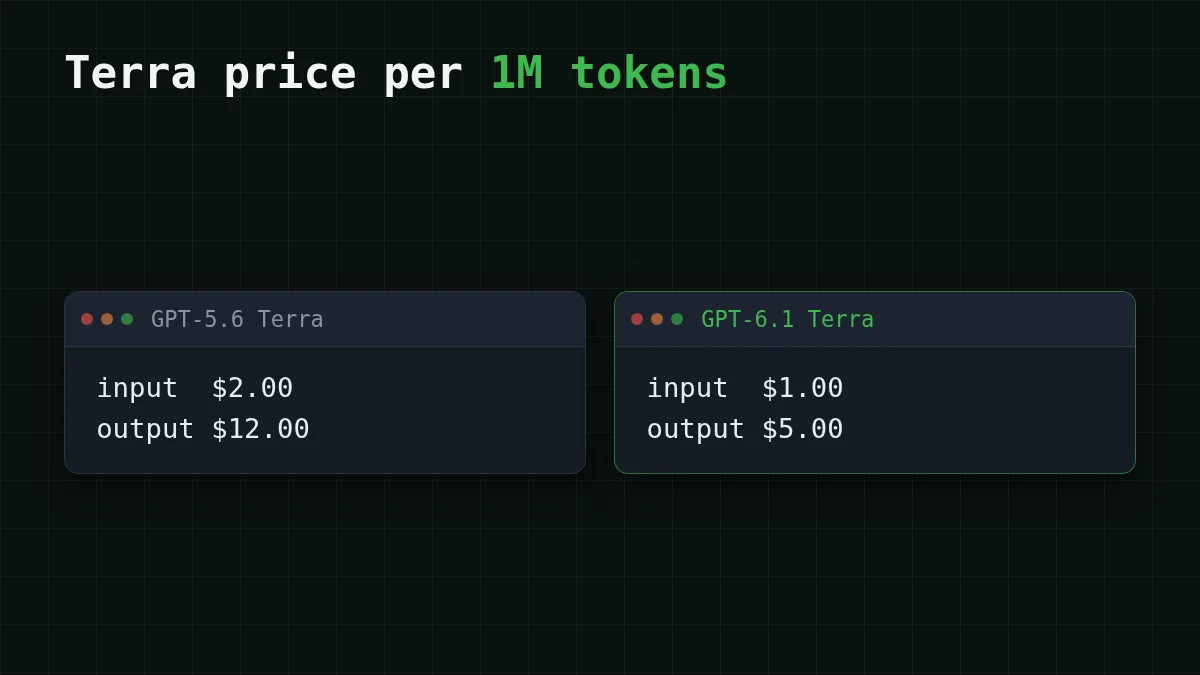
GPT-6.1 Terra는 OpenAI API 가격 페이지에 입력 1M 토큰당 $1.00, 출력 1M 토큰당 $5.00으로 등재되어 있습니다(2026년 10월 27일 확인). 이전 Terra인 GPT-5.6 Terra는 같은 페이지에 $2.00와 $12.00으로 등재되어 있습니다. 코딩 에이전트가 GPT-5.6 Terra에서 실행 중이라면, GPT-6.1 Terra로 옮기면 같은 작업에 대한 비용이 대략 절반으로 줄어듭니다. 아래에서는 일반적인 에이전트 작업에서 얼마나 줄어드는지, 그리고 더 저렴한 모델이 어디서 더 나아가는지를 다룹니다.
가격 페이지에서 바뀐 것#
GPT-6.1 Terra는 OpenAI 가격 페이지에 API id gpt-6.1-terra로 등재되어 있습니다(2026년 10월 27일 확인). 입력은 이전 가격의 절반으로 떨어졌습니다. 출력은 $12.00에서 $5.00로 내려갔습니다. 두 번째 숫자가 보이는 것보다 더 중요합니다. 에이전트는 많이 쓰고, 출력이 비싼 쪽이기 때문입니다.
하지만 페이지에는 행이 하나 이상 있으므로, 잘못된 행을 고르는 것이 청구서에 놀라게 되는 가장 쉬운 방법입니다:
짝 맞추기
가격 페이지의 각 티어를 요율과 맞추기
왼쪽 항목을 탭한 다음 짝을 탭하세요
- Standard, 입력 최대 272K 토큰1M당 입력 $1.00, 출력 $5.00
- 입력 272K 토큰 초과1M당 입력 $2.00, 출력 $7.50
- Batch / Flex1M당 입력 $0.50, 출력 $2.50
- Fast1M당 입력 $2.00, 출력 $10.00
캐시된 입력은 standard 티어에서 1M당 $0.05로 별도 등재되어 있으며, 에이전트의 모든 단계가 같은 긴 프리픽스를 다시 보낼 때 도움이 됩니다. 이 글의 나머지 부분은 standard 티어와 캐싱 없음을 사용하므로 숫자를 쉽게 다시 계산할 수 있습니다.
20단계 에이전트 작업의 비용#
에이전트가 한 티켓을 20단계로 해결한다고 가정해 봅시다. 각 단계는 작업, 열어 둔 파일, 지금까지의 도구 결과를 보내며 평균 약 30,000 입력 토큰이고, 약 1,500 토큰을 다시 씁니다(계획, 패치, 명령). 평범해 보이는 가정이지만, 바로 이것이 에이전트를 비싸게 만듭니다. 입력이 매 단계 다시 전송되기 때문입니다. (이 부분이 처음이라면, AI 에이전트가 왜 그렇게 많은 토큰을 쓰는지에서 자세히 다룹니다.)
그러면 한 작업은 20 × 30,000 = 600,000 입력 토큰과 20 × 1,500 = 30,000 출력 토큰으로 합산됩니다. 모든 단계가 272K 선보다 훨씬 아래에 있으므로 standard 요율이 적용됩니다.
- GPT-6.1 Terra: 입력 0.6 × $1.00 = $0.60, 출력 0.03 × $5.00 = $0.15, 작업당 $0.60 + $0.15 = $0.75.
- GPT-5.6 Terra: 입력 0.6 × $2.00 = $1.20, 출력 0.03 × $12.00 = $0.36, 작업당 $1.20 + $0.36 = $1.56.
이제 규모를 키워 봅시다. 하루에 이런 작업 100건을 처리하는 팀은 새 모델에서 하루 100 × $0.75 = $75를 내고, 이전 모델에서는 100 × $1.56 = $156를 냅니다. 실제로 줄어들며, 모델 id 외에는 코드를 바꿀 필요가 없습니다.
저희가 제공하는 모델에서 같은 작업을 실시간 가격으로 계산하면 다음과 같습니다(한 단계는 입력 30,000, 출력 1,500, 곱하기 20단계):
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 20회 요청 | OpenRouter, 20회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0271 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0332 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.216 |
요청당 입력 30,000개 및 출력 1,500개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
작업 한 건 전체로 보면 DeepSeek-V4-Flash는 $0.012, GLM-5.3-Flash는 $0.0132, MiniMax-M2.7은 $0.0345입니다. 표에는 각 모델의 OpenRouter 가격도 나와 있으며, 입력과 출력을 합산한 총액에서는 CheapTokens가 더 저렴한 쪽입니다.
전체 파이프라인을 옮기기 전에, 자신의 티켓 몇 건을 후보 모델로 보내고 usage 블록의 토큰 수를 위 표와 비교해 보세요.
어떤 작업에 어떤 모델#
가격 인하 때문에 Terra 쪽으로 끌렸다면, 먼저 루프에 실제로 무엇이 필요한지 물어보세요. 긴 히스토리, 긴 답변, 빠듯한 예산은 서로 다른 세 가지 작업이며, 저희는 각각에 맞는 모델을 가지고 있습니다.
사례 선택하기
자신의 작업과 가장 가까운 것 고르기
답을 보려면 옵션을 선택하세요
긴 코딩 에이전트 루프
DeepSeek-V4-Flash를 선택하세요. 380K 컨텍스트를 가지며 답변당 최대 32,768 출력 토큰을 쓰고, 하루 중 어느 시간에도 같은 비용이 듭니다. 많은 파일을 읽은 뒤 큰 패치를 쓰는 에이전트에 적합합니다.
일상적인 코딩과 채팅
GLM-5.3-Flash를 선택하세요. 390K 컨텍스트를 가지며 최대 8,192 토큰까지 답하고, 같은 토큰 기준으로 총액이 OpenRouter보다 저렴합니다.
빠듯한 예산의 에이전트 작업
MiniMax-M2.7을 선택하세요. 180K 컨텍스트를 가지며 최대 8,192 토큰까지 답하고, 같은 토큰 기준으로 총액이 OpenRouter보다 저렴합니다.
세 모델 모두 하나의 잔액 뒤에 있으며 OpenAI와 Anthropic API를 모두 지원하므로, 모델 id 한 줄만 바꾸면 전환할 수 있습니다.
자신의 작업으로 시험해 보기#
실제 프롬프트 하나를 더 저렴한 모델로 보내고 답변의 usage 블록을 읽어 보세요. 정확한 입력 및 출력 토큰을 알려주며, 위에서 가정한 단계당 입력 30,000 / 출력 1,500과 비교할 수 있습니다. 예시 요청(주소와 모델 id는 복사할 값이며, 키는 환경 변수에 보관하세요):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Write a unit test for a function that parses ISO dates."}],
    "max_tokens": 800
  }'
전체 설정은 CheapTokens 문서에 있고, 실시간 가격 목록은 가격 페이지에 있으며, AI 에이전트 비용을 추정하는 방법은 자신의 로그를 이 글이 시작한 두 숫자로 바꾸는 방법을 보여줍니다.


