Notícias de IAAtualização
Preço da API do GPT-6.1 Terra: $1 in, $5 out por 1M de tokens
O que o novo preço do GPT-6.1 Terra da OpenAI significa para uma tarefa de agente de 20 etapas, ao lado do preço antigo do GPT-5.6 Terra e de modelos mais baratos.
Nesta página
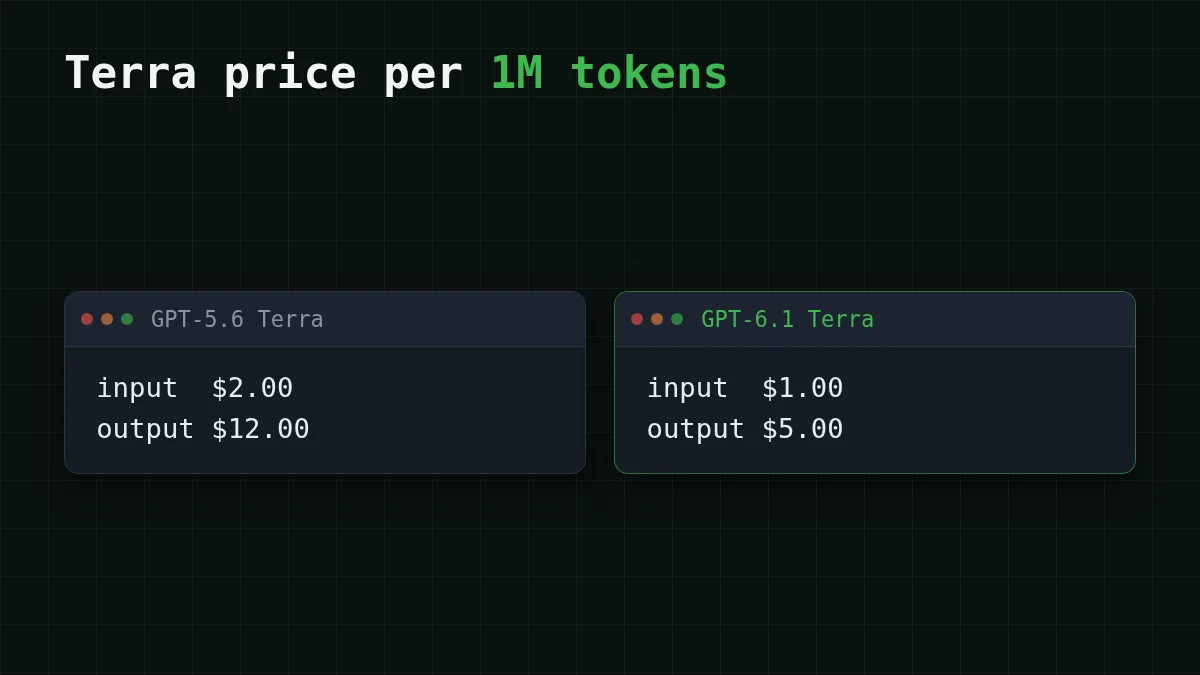
O GPT-6.1 Terra está listado a $1,00 por 1M de tokens de entrada e $5,00 por 1M de tokens de saída na página de preços da API da OpenAI (verificado em 27 de outubro de 2026). O Terra anterior, GPT-5.6 Terra, está listado na mesma página a $2,00 e $12,00. Se o seu agente de código roda no GPT-5.6 Terra, migrá-lo para o GPT-6.1 Terra praticamente reduz pela metade a conta para a mesma tarefa. Abaixo: quanto para uma tarefa típica de agente, e onde um modelo mais barato leva você mais longe.
O que mudou na página de preços#
O GPT-6.1 Terra está listado na página de preços da OpenAI (verificado em 27 de outubro de 2026) com o id de API gpt-6.1-terra. A entrada caiu para metade do preço antigo. A saída foi de $12,00 para $5,00. Esse segundo número importa mais do que parece: agentes escrevem muito, e a saída é o lado caro.
A página tem mais de uma linha, porém, e escolher a errada é a forma mais fácil de se surpreender com uma fatura:
Emparelhar os pares
Combine cada faixa da página de preços com suas tarifas
Toque num item à esquerda, depois no seu par
- Standard, entrada até 272K tokens$1,00 in, $5,00 out por 1M
- Entrada acima de 272K tokens$2,00 in, $7,50 out por 1M
- Batch / Flex$0,50 in, $2,50 out por 1M
- Fast$2,00 in, $10,00 out por 1M
A entrada em cache é listada separadamente a $0,05 por 1M na faixa standard, o que ajuda quando cada etapa de um agente reenvia o mesmo prefixo longo. O restante deste artigo usa a faixa standard e sem cache, então os números são fáceis de refazer.
Quanto custa uma tarefa de agente de 20 etapas#
Digamos que seu agente resolva um ticket em 20 etapas. Cada etapa envia a tarefa, os arquivos que abriu e os resultados das ferramentas até o momento, cerca de 30.000 tokens de entrada em média, e escreve cerca de 1.500 tokens de volta (um plano, um patch, um comando). É uma suposição simples, e é ela que torna os agentes caros: a entrada é reenviada a cada etapa. (Se essa parte é nova, por que agentes de IA usam tantos tokens explica isso.)
Uma tarefa então soma 20 × 30.000 = 600.000 tokens de entrada e 20 × 1.500 = 30.000 tokens de saída. Cada etapa fica bem abaixo da linha de 272K, então as tarifas standard se aplicam.
- GPT-6.1 Terra: 0,6 × $1,00 = $0,60 de entrada, 0,03 × $5,00 = $0,15 de saída, $0,60 + $0,15 = $0,75 por tarefa.
- GPT-5.6 Terra: 0,6 × $2,00 = $1,20 de entrada, 0,03 × $12,00 = $0,36 de saída, $1,20 + $0,36 = $1,56 por tarefa.
Agora escale. Uma equipe que fecha 100 tarefas assim por dia paga 100 × $0,75 = $75 por dia no modelo novo contra 100 × $1,56 = $156 no antigo. Um corte real, e sem mudança no seu código além do id do modelo.
A mesma tarefa nos modelos que servimos, a preços atuais (uma etapa é 30.000 in e 1.500 out, vezes 20 etapas):
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 20 solicitações | OpenRouter, 20 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0271 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0332 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.216 |
30.000 tokens de entrada e 1.500 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Para uma tarefa inteira, o DeepSeek-V4-Flash fica em $0.012, o GLM-5.3-Flash em $0.0132 e o MiniMax-M2.7 em $0.0345. A tabela também mostra o preço no OpenRouter para cada um deles, e no total, com entrada e saída somadas, o CheapTokens é o lado mais barato.
Antes de migrar um pipeline inteiro, envie alguns dos seus próprios tickets ao modelo candidato e compare as contagens de tokens no bloco usage com a tabela acima.
Qual modelo para qual trabalho#
Se a queda de preço te atraiu para o Terra, pergunte primeiro o que seu loop realmente precisa. Históricos longos, respostas longas, orçamento apertado: são três trabalhos diferentes, e temos um modelo para cada.
Escolha o seu caso
Escolha o trabalho mais próximo do seu
Escolha uma opção para ver a resposta
Um loop longo de agente de código
Use DeepSeek-V4-Flash. Ele tem contexto de 380K, escreve até 32.768 tokens de saída por resposta e custa o mesmo em qualquer hora do dia. Isso serve para agentes que leem muitos arquivos e depois escrevem patches grandes.
Codificação e chat do dia a dia
Use GLM-5.3-Flash. Ele tem contexto de 390K e responde até 8.192 tokens, e no total é mais barato que o OpenRouter para os mesmos tokens.
Trabalho de agente com orçamento apertado
Use MiniMax-M2.7. Ele tem contexto de 180K e responde até 8.192 tokens, e no total é mais barato que o OpenRouter para os mesmos tokens.
Os três ficam atrás de um único saldo e falam tanto a API da OpenAI quanto a da Anthropic, então alternar entre eles é uma mudança de uma linha no id do modelo.
Experimente na sua própria tarefa#
Envie um dos seus prompts reais a um modelo mais barato e leia o bloco usage na resposta. Ele informa os tokens exatos de entrada e saída, que você pode comparar com a etapa de 30.000 in / 1.500 out assumida acima. Exemplo de requisição (o endereço e o id do modelo são os que devem ser copiados; mantenha sua chave em uma variável de ambiente):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Write a unit test for a function that parses ISO dates."}],
    "max_tokens": 800
  }'
A configuração completa está na documentação do CheapTokens, a lista de preços atual está na página de preços, e como estimar o custo de um agente de IA mostra como transformar seus próprios logs nos dois números com que este artigo começou.


