Balitang AIUpdate
Presyo ng GPT-6.1 Terra API: $1 in, $5 out bawat 1M token
Ano ang ibig sabihin ng bagong presyo ng GPT-6.1 Terra ng OpenAI para sa isang 20-hakbang na gawain ng agent, kasama ang dating presyo ng GPT-5.6 Terra at mas murang mga modelo.
Sa pahinang ito
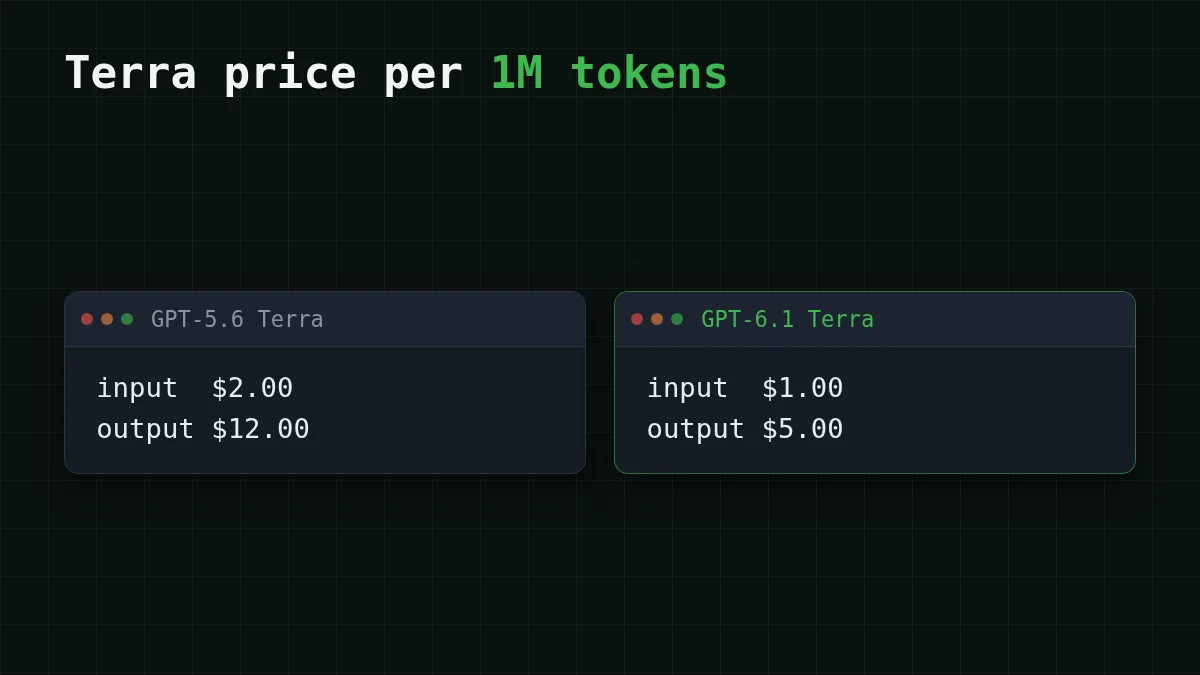
Ang GPT-6.1 Terra ay nakalista sa $1.00 bawat 1M input token at $5.00 bawat 1M output token sa pahina ng presyo ng OpenAI API (sinuri noong 27 Oktubre 2026). Ang dating Terra, GPT-5.6 Terra, ay nakalista sa parehong pahina sa $2.00 at $12.00. Kung ang iyong coding agent ay tumatakbo sa GPT-5.6 Terra, ang paglipat nito sa GPT-6.1 Terra ay halos kalahati ng bill para sa parehong gawain. Sa ibaba: gaano kalaki para sa isang tipikal na gawain ng agent, at saan ka mas makakarating sa mas murang modelo.
Ano ang nagbago sa pahina ng presyo#
Ang GPT-6.1 Terra ay nakalista sa pahina ng presyo ng OpenAI (sinuri noong 27 Oktubre 2026) na may API id na gpt-6.1-terra. Bumaba ang input sa kalahati ng dating presyo. Ang output ay mula $12.00 naging $5.00. Mas mahalaga ang pangalawang numero kaysa sa itsura nito: maraming isinusulat ang mga agent, at ang output ang mamahaling bahagi.
May higit sa isang row ang pahina, gayunpaman, at ang pagpili ng maling row ang pinakamadaling paraan para mabigla sa invoice:
Itugma ang mga pares
Itugma ang bawat tier sa pahina ng presyo sa mga rate nito
I-tap ang isang item sa kaliwa, pagkatapos ang pares nito
- Standard, input hanggang 272K token$1.00 in, $5.00 out bawat 1M
- Input na higit sa 272K token$2.00 in, $7.50 out bawat 1M
- Batch / Flex$0.50 in, $2.50 out bawat 1M
- Fast$2.00 in, $10.00 out bawat 1M
Ang cached input ay nakalista nang hiwalay sa $0.05 bawat 1M sa standard tier, na nakakatulong kapag ang bawat hakbang ng agent ay muling nagpapadala ng parehong mahabang prefix. Ang natitirang bahagi ng artikulong ito ay gumagamit ng standard tier at walang caching, kaya madaling ulitin ang mga numero.
Magkano ang isang 20-hakbang na gawain ng agent#
Sabihin nating ang iyong agent ay nagsasagawa ng isang ticket sa 20 hakbang. Ang bawat hakbang ay nagpapadala ng gawain, ang mga file na binuksan nito at ang mga resulta ng tool sa ngayon, mga 30,000 input token sa average, at nagsusulat ng mga 1,500 token pabalik (isang plano, isang patch, isang command). Iyon ay isang simpleng tingnang palagay, at ito ang nagpapamahal sa mga agent: ang input ay muling ipinapadala sa bawat hakbang. (Kung bago ito sa iyo, ang bakit gumagamit ng napakaraming token ang mga AI agent ay nagpapaliwanag nito.)
Ang isang gawain ay umaabot sa 20 × 30,000 = 600,000 input token at 20 × 1,500 = 30,000 output token. Ang bawat hakbang ay nananatiling malayo sa 272K na linya, kaya ang standard na rate ang naaangkop.
- GPT-6.1 Terra: 0.6 × $1.00 = $0.60 para sa input, 0.03 × $5.00 = $0.15 para sa output, $0.60 + $0.15 = $0.75 bawat gawain.
- GPT-5.6 Terra: 0.6 × $2.00 = $1.20 para sa input, 0.03 × $12.00 = $0.36 para sa output, $1.20 + $0.36 = $1.56 bawat gawain.
Ngayon, i-scale ito. Ang isang team na nagsasara ng 100 ganoong gawain sa isang araw ay nagbabayad ng 100 × $0.75 = $75 sa isang araw sa bagong modelo kumpara sa 100 × $1.56 = $156 sa luma. Tunay na pagbawas, at walang pagbabago sa iyong code maliban sa model id.
Ang parehong gawain sa mga modelong aming inihahain, sa live na presyo (isang hakbang ay 30,000 in at 1,500 out, beses 20 hakbang):
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 20 mga kahilingan | OpenRouter, 20 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0271 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0332 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.216 |
30,000 input at 1,500 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Para sa isang buong gawain, ang DeepSeek-V4-Flash ay umabot sa $0.012, ang GLM-5.3-Flash sa $0.0132 at ang MiniMax-M2.7 sa $0.0345. Ipinapakita rin ng talahanayan ang presyo ng OpenRouter para sa bawat isa sa kanila, at sa kabuuan, kung pagsasamahin ang input at output, ang CheapTokens ang mas mura.
Bago mo ilipat ang isang buong pipeline, magpadala ng ilang sarili mong ticket sa kandidatong modelo at ihambing ang bilang ng token sa usage block sa talahanayan sa itaas.
Aling modelo para sa aling gawain#
Kung ang pagbaba ng presyo ang naghatak sa iyo patungo sa Terra, itanong muna kung ano ang aktwal na kailangan ng iyong loop. Mahahabang history, mahahabang sagot, masikip na budget: tatlong magkakaibang gawain iyon, at mayroon kaming modelo para sa bawat isa.
Piliin ang iyong kaso
Piliin ang gawaing pinakamalapit sa iyo
Pumili ng opsyon upang makita ang sagot
Isang mahabang coding-agent loop
Gamitin ang DeepSeek-V4-Flash. Mayroon itong 380K context, nagsusulat ng hanggang 32,768 output token bawat sagot, at pareho ang presyo sa anumang oras ng araw. Angkop iyon sa mga agent na nagbabasa ng maraming file at pagkatapos ay nagsusulat ng malalaking patch.
Araw-araw na coding at chat
Gamitin ang GLM-5.3-Flash. Mayroon itong 390K context at sumasagot ng hanggang 8,192 token, at sa kabuuan ito ay mas mura kaysa sa OpenRouter para sa parehong token.
Gawain ng agent sa masikip na budget
Gamitin ang MiniMax-M2.7. Mayroon itong 180K context at sumasagot ng hanggang 8,192 token, at sa kabuuan ito ay mas mura kaysa sa OpenRouter para sa parehong token.
Lahat ng tatlo ay nasa likod ng isang balanse at nagsasalita ng parehong OpenAI at Anthropic API, kaya ang paglipat sa pagitan nila ay isang linyang pagbabago ng model id.
Subukan ito sa sarili mong gawain#
Magpadala ng isa sa iyong tunay na prompt sa isang mas murang modelo at basahin ang usage block sa sagot. Sinasabi nito sa iyo ang eksaktong input at output token, na maihahambing mo sa 30,000-in / 1,500-out na hakbang na ipinapalagay sa itaas. Halimbawang request (ang address at model id ang kopyahin; itago ang iyong key sa isang environment variable):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Write a unit test for a function that parses ISO dates."}],
    "max_tokens": 800
  }'
Ang buong setup ay nasa CheapTokens docs, ang live na listahan ng presyo ay nasa pahina ng presyo, at ang paano tantiyahin ang gastos ng isang AI agent ay nagpapakita kung paano gawing dalawang numero na sinimulan ng artikulong ito ang sarili mong mga log.


