Actus IAMise à jour
Prix de l'API GPT-6.1 Terra : 1 $ en entrée, 5 $ en sortie par 1M de tokens
Ce que signifie le nouveau prix de GPT-6.1 Terra d'OpenAI pour une tâche d'agent en 20 étapes, face à l'ancien prix de GPT-5.6 Terra et à des modèles moins chers.
Sur cette page
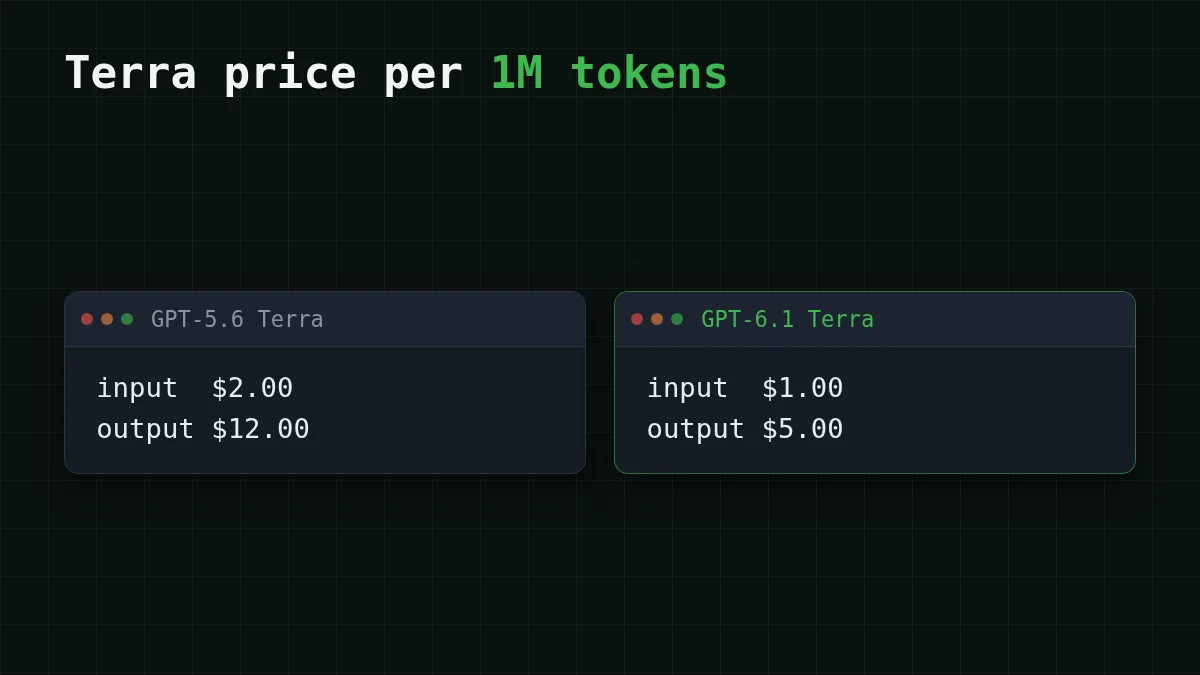
GPT-6.1 Terra est affiché à 1,00 $ par 1M de tokens d'entrée et 5,00 $ par 1M de tokens de sortie sur la page tarifaire de l'API OpenAI (vérifiée le 27 octobre 2026). Le Terra précédent, GPT-5.6 Terra, est affiché sur la même page à 2,00 $ et 12,00 $. Si votre agent de codage tourne sur GPT-5.6 Terra, le passer à GPT-6.1 Terra divise à peu près par deux la facture pour la même tâche. Ci-dessous : de combien pour une tâche d'agent typique, et où un modèle moins cher vous mène plus loin.
Ce qui a changé sur la page tarifaire#
GPT-6.1 Terra est affiché sur la page tarifaire d'OpenAI (vérifiée le 27 octobre 2026) avec l'id d'API gpt-6.1-terra. L'entrée est tombée à la moitié de l'ancien prix. La sortie est passée de 12,00 $ à 5,00 $. Ce second chiffre compte plus qu'il n'y paraît : les agents écrivent beaucoup, et la sortie est le côté cher.
La page comporte cependant plusieurs lignes, et choisir la mauvaise est le moyen le plus simple d'avoir une mauvaise surprise sur la facture :
Associer les paires
Faites correspondre chaque palier de la page tarifaire à ses tarifs
Touchez un élément à gauche, puis sa paire
- Standard, entrée jusqu'à 272K tokens1,00 $ en entrée, 5,00 $ en sortie par 1M
- Entrée au-delà de 272K tokens2,00 $ en entrée, 7,50 $ en sortie par 1M
- Batch / Flex0,50 $ en entrée, 2,50 $ en sortie par 1M
- Fast2,00 $ en entrée, 10,00 $ en sortie par 1M
L'entrée mise en cache est affichée séparément à 0,05 $ par 1M sur le palier standard, ce qui aide quand chaque étape d'un agent renvoie le même long préfixe. Le reste de cet article utilise le palier standard et pas de cache, pour que les chiffres soient faciles à refaire.
Combien coûte une tâche d'agent en 20 étapes#
Disons que votre agent résout un ticket en 20 étapes. Chaque étape envoie la tâche, les fichiers qu'il a ouverts et les résultats d'outils jusqu'ici, environ 30 000 tokens d'entrée en moyenne, et écrit environ 1 500 tokens en retour (un plan, un patch, une commande). C'est une hypothèse banale, et c'est celle qui rend les agents chers : l'entrée est renvoyée à chaque étape. (Si cette partie est nouvelle, pourquoi les agents IA utilisent autant de tokens l'explique en détail.)
Une tâche totalise donc 20 × 30 000 = 600 000 tokens d'entrée et 20 × 1 500 = 30 000 tokens de sortie. Chaque étape reste bien en dessous de la limite de 272K, donc les tarifs standard s'appliquent.
- GPT-6.1 Terra : 0,6 × 1,00 $ = 0,60 $ pour l'entrée, 0,03 × 5,00 $ = 0,15 $ pour la sortie, 0,60 $ + 0,15 $ = 0,75 $ par tâche.
- GPT-5.6 Terra : 0,6 × 2,00 $ = 1,20 $ pour l'entrée, 0,03 × 12,00 $ = 0,36 $ pour la sortie, 1,20 $ + 0,36 $ = 1,56 $ par tâche.
Maintenant, changez d'échelle. Une équipe qui clôture 100 tâches de ce type par jour paie 100 × 0,75 $ = 75 $ par jour sur le nouveau modèle contre 100 × 1,56 $ = 156 $ sur l'ancien. Une vraie baisse, et aucun changement dans votre code à part l'id du modèle.
La même tâche sur les modèles que nous servons, aux prix actuels (une étape, c'est 30 000 en entrée et 1 500 en sortie, fois 20 étapes) :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 20 requêtes | OpenRouter, 20 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0271 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0332 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.216 |
30 000 tokens d'entrée et 1 500 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Pour une tâche complète, DeepSeek-V4-Flash revient à $0.012, GLM-5.3-Flash à $0.0132 et MiniMax-M2.7 à $0.0345. Le tableau montre aussi le prix OpenRouter pour chacun d'eux, et au total, entrée et sortie comptées ensemble, CheapTokens est le côté le moins cher.
Avant de migrer tout un pipeline, envoyez une poignée de vos propres tickets au modèle candidat et comparez les comptages de tokens du bloc usage avec le tableau ci-dessus.
Quel modèle pour quel travail#
Si la baisse de prix vous a attiré vers Terra, demandez d'abord ce dont votre boucle a réellement besoin. Historiques longs, réponses longues, budget serré : ce sont trois travaux différents, et nous avons un modèle pour chacun.
Choisissez votre cas
Choisissez le travail le plus proche du vôtre
Choisissez une option pour voir la réponse
Une longue boucle d'agent de codage
Prenez DeepSeek-V4-Flash. Il a un contexte de 380K, écrit jusqu'à 32 768 tokens de sortie par réponse, et coûte la même chose à toute heure de la journée. Cela convient aux agents qui lisent beaucoup de fichiers puis écrivent de gros patches.
Codage et chat du quotidien
Prenez GLM-5.3-Flash. Il a un contexte de 390K et répond jusqu'à 8 192 tokens, et au total il est moins cher qu'OpenRouter pour les mêmes tokens.
Travail d'agent avec un budget serré
Prenez MiniMax-M2.7. Il a un contexte de 180K et répond jusqu'à 8 192 tokens, et au total il est moins cher qu'OpenRouter pour les mêmes tokens.
Les trois sont derrière un seul solde et parlent à la fois l'API OpenAI et l'API Anthropic, donc passer de l'un à l'autre est un changement d'une ligne de l'id du modèle.
Essayez sur votre propre tâche#
Envoyez l'un de vos vrais prompts à un modèle moins cher et lisez le bloc usage dans la réponse. Il vous indique les tokens d'entrée et de sortie exacts, que vous pouvez comparer avec l'étape de 30 000 en entrée / 1 500 en sortie supposée ci-dessus. Exemple de requête (l'adresse et l'id du modèle sont ceux à copier ; gardez votre clé dans une variable d'environnement) :
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Write a unit test for a function that parses ISO dates."}],
    "max_tokens": 800
  }'
La configuration complète est dans la documentation CheapTokens, la liste des prix actuels est sur la page tarifaire, et comment estimer le coût d'un agent IA montre comment transformer vos propres logs en les deux chiffres par lesquels cet article a commencé.


